Confluent bringt verwaltete KI-Inferenz direkt in Echtzeit-Datenströme
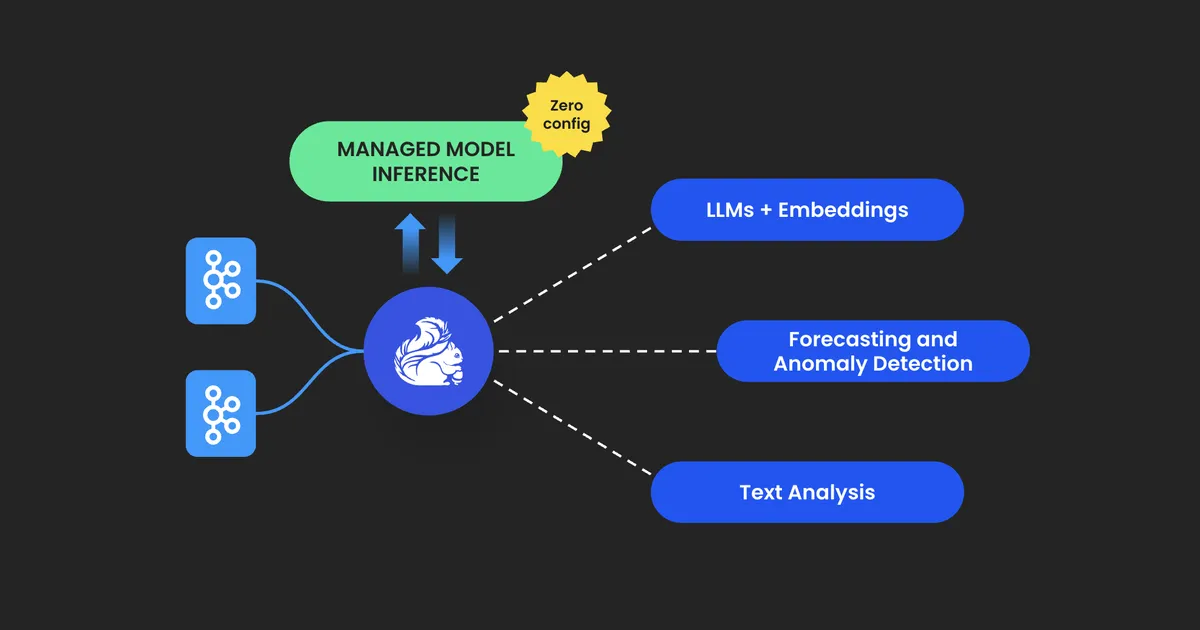
Confluent hat Managed Model Inference in Confluent Cloud für Apache Flink allgemein verfügbar gemacht. Damit können Nutzer unterstützte KI-Modelle direkt aus Echtzeit-Datenströmen per SQL aufrufen. Nach Angaben des Unternehmens entfällt für diese Modelle die Verwaltung von Provider-Zugangsdaten, Endpoints und Infrastruktur für das Bereitstellen der Modelle.
- Managed Model Inference ist in Confluent Cloud für Apache Flink allgemein verfügbar.
- Unterstützte Modelle lassen sich über Flink SQL ohne Provider-Zugangsdaten oder Endpoint-Konfiguration aufrufen.
- LLMs und Embedding-Modelle sind auf Amazon Bedrock, Azure OpenAI und Google Vertex AI allgemein verfügbar.
- Prognosen, Anomalieerkennung und Textanalyse befinden sich in der Early-Access-Phase.
- Die Nutzung von LLMs und Embeddings wird zum Token-Preis des Cloud-Providers ohne Aufschlag von Confluent abgerechnet.
Inferenz rückt näher an die Streaming-Daten
Confluent zufolge soll Managed Model Inference die Verzögerung zwischen dem Eintreffen eines Ereignisses und einer KI-gestützten Entscheidung verringern. Statt Daten durch eine separate Verarbeitungspipeline zu schicken, können Nutzer die Inferenz im Datenstrom ausführen. Das Ergebnis des Modells trifft damit gemeinsam mit dem Ereignis ein.
Das Unternehmen verweist auf Anwendungsfälle, bei denen das Timing den Wert einer Entscheidung beeinflusst. Eine verdächtige Transaktion kann gestoppt werden, während eine Zahlung noch läuft. Ein Problem in der Fertigung lässt sich erkennen, bevor es zu einem Ausfall führt. Weitere zeitkritische Beispiele sind das Auffüllen eines Einzelhandelsregals, bevor es leer ist, und das Erkennen ungewöhnlicher Energienachfrage in Echtzeit.
Managed Model Inference läuft über Flink SQL mit unterstützten Modellen, die bei Cloud-Service-Providern gehostet werden. Mit SHOW MODELS können Nutzer die in ihrer Region verfügbaren Modelle anzeigen und anschließend eines per Namen aufrufen, etwa AI_COMPLETE(`system.anthropic.claude-sonnet-4-6`, 'your prompt').
LLMs und Embeddings allgemein verfügbar
Managed Model Inference für LLMs und Embedding-Modelle ist in Confluent Cloud allgemein verfügbar. Prognosen, Anomalieerkennung und Textanalyse befinden sich in der Early-Access-Phase.
AI_COMPLETE ermöglicht es Nutzern, ein LLM für Aufgaben wie Klassifizierung, Zusammenfassung, Extraktion und Bewertung aufzufordern. AI_EMBEDDING wandelt Text in Vektoren für die semantische Suche und die Retrieval-Augmented Generation um.
Die unterstützten Modelle stammen von drei Cloud-Plattformen: Claude, Amazon Nova und Titan embeddings auf Amazon Bedrock, GPT-5.4 und text-embedding-3 auf Azure OpenAI sowie Gemini und Gemini Embedding auf Google Vertex AI. Confluent zufolge bleibt das SQL über die Clouds hinweg gleich, lediglich der Modellname ändert sich.
Für Prognosen und Anomalieerkennung ergänzt der Dienst AI_FORECAST und AI_DETECT_ANOMALIES. Zu den ersten Zeitreihenmodellen gehören IBM Granite TTM, IBM Granite FlowState, IBM Granite PatchTST-FM, IBM Granite TSPulse und Google TimesFM. Zu den Textanalysemodellen zählen Piiranha zur Erkennung personenbezogener Daten und DeBERTa für die Stimmungsanalyse.
Verwalteter und externer Modellzugriff
Managed Model Inference ergänzt Confluents External Model Inference, das seit März 2025 allgemein verfügbar ist. External Model Inference ist für Modelle außerhalb der verwalteten Liste oder für den eigenen Endpoint eines Nutzers gedacht. Nutzer müssen die Verbindung selbst einrichten, eigene Provider-Zugangsdaten und API-Schlüssel hinterlegen und den Provider direkt bezahlen.
Mit Managed Model Inference rufen Nutzer unterstützte Modelle per Namen auf, ohne ein Provider-Konto einzurichten, einen API-Schlüssel zu speichern oder eine Verbindung, einen Endpoint oder Infrastruktur für das Bereitstellen der Modelle zu betreiben. Die Nutzung erscheint auf der Confluent-Rechnung. Für LLMs und Embeddings zahlen Kunden laut Confluent den Token-Preis des Cloud-Providers ohne Aufschlag von Confluent. Die Nutzung wird dabei anhand der Eingabe- und Ausgabetokens erfasst und getrennt von der Flink-Berechnung ausgewiesen.
Administratoren von Organisationen können über die Confluent CLI ein monatliches Budget in US-Dollar festlegen. Benachrichtigungen werden bei 50 %, 90 % und 100 % per E-Mail, Slack, Microsoft Teams und Webhook verschickt. Confluent weist darauf hin, dass diese Budgets lediglich Benachrichtigungen auslösen, die Ausgaben aber nicht begrenzen. Die Inferenz läuft daher auch nach dem Erreichen von 100 % weiter.
Für Nutzer bedeutet die Ankündigung, dass sich unterstützte KI-Modelle mit weniger Integrations- und Betriebsaufwand in Streaming-Anwendungen einbinden lassen. Die Kategorien im Early Access übertragen denselben SQL-basierten Ansatz zudem auf weitere Bereiche neben Sprach- und Embedding-Modellen. Die separate externe Option bleibt für eigene Endpoints und Modelle außerhalb der verwalteten Liste verfügbar.
Confluent: Managed Model Inference Brings AI into Real-Time Data Streams