IBM und Confluent bringen Zeitreihenmodelle in Streaming-Daten
IBM und Confluent integrieren Foundation-Modelle für Zeitreihen direkt in Streaming-Daten-Workflows. Damit werden Prognosen, Anomalieerkennung und Optimierung näher an Echtzeitentscheidungen im Unternehmen möglich. Die Modelle sind nativ in Confluent Cloud und On-Premises-Umgebungen verfügbar und laufen auf CPUs, ohne GPUs zu benötigen.
- IBM und Confluent integrieren Zeitreihenmodelle in Confluent.
- Die Modelle unterstützen Prognosen, Anomalieerkennung und Optimierung.
- Sie laufen auf CPUs in Confluent Cloud und On-Premises-Umgebungen.
- Laut IBM Research verzeichnet die Modellfamilie mehr als 50 Millionen Downloads.
- Zu den Anwendungsfällen zählen Produktion, Anomalieerkennung im Einzelhandel und Lieferkettenplanung.
Zeitreihenintelligenz zieht ins Streamhouse ein
IBM Research teilte mit, dass seine Zeitreihenmodelle nun als integrierte Funktionen innerhalb von Confluent laufen können, sowohl in der Cloud als auch On-Premises. In Confluent Cloud werden die Modelle vollständig verwaltet, während die Confluent Platform für Apache Flink sie innerhalb der eigenen Infrastruktur eines Unternehmens ausführen kann.
Die Ankündigung beschreibt die Modelle als Möglichkeit, numerische Daten wie Maschinenmesswerte, Zahlungen, Verkäufe, Bestellungen und Bestandsveränderungen zu verarbeiten. Foundation-Modelle für Zeitreihen lernen allgemeine Muster aus vielfältigen historischen Daten und übertragen dieses Wissen auf neue Zeitreihen und Aufgaben. Laut IBM Research erhalten Teams dadurch einen gemeinsamen Ausgangspunkt, ohne für jede Zeitreihe ein separates Modell zu benötigen. Teams können ein Modell zudem feinabstimmen oder seine Ergebnisse mit weiteren Daten und Geschäftslogik kombinieren.
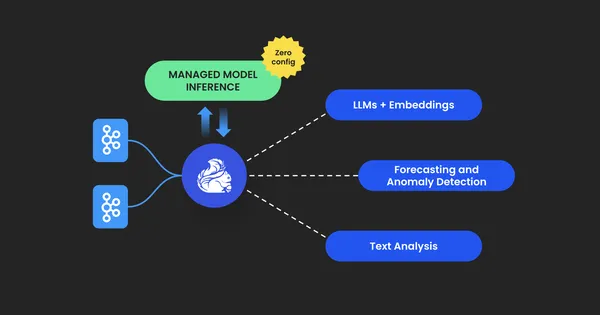
Die Modelle sind in Apache Flink integriert. Die Plattform kann Streaming-Daten aufbereiten, Prognosen und Anomalieerkennung aufrufen und die Modellergebnisse neben den Ereignissen verfügbar machen, die sie hervorgebracht haben. Confluents Streamhouse-Architektur ist darauf ausgelegt, den aktuellen Geschäftskontext kontinuierlich zu erfassen, zu verarbeiten, zu steuern und Anwendungen, Analysen sowie Agenten bereitzustellen.
CPU-Einsatz und operative Anwendungsfälle
IBM Research teilte mit, dass die Modellfamilie mehr als 50 Millionen Downloads verzeichnet. Die Modelle laufen auf Standard-CPUs und können dadurch neben einer Streaming-Pipeline in der Cloud oder On-Premises betrieben werden. Nach Angaben des Unternehmens kann dies den Bedarf an dedizierter GPU-Infrastruktur verringern und die Bereitstellung vereinfachen.
Die Ankündigung hebt Anwendungen in der Fertigung, im Einzelhandel, im Bankwesen und bei Fluggesellschaften hervor. In der Fertigung könnte ein vortrainiertes TTM-Modell alle 10 Minuten Produktions-Telemetriedaten und Qualitätsmessungen auswerten und anschließend vier Stunden im Voraus den Anteil der Produkte prognostizieren, die voraussichtlich die Spezifikationen erfüllen. Fällt die Prognose unter einen Werkszielwert, kann ein Optimierungsprozess die Einstellungen der Steuerung prüfen, bevor ein Bediener die Produktionslinie verändert.
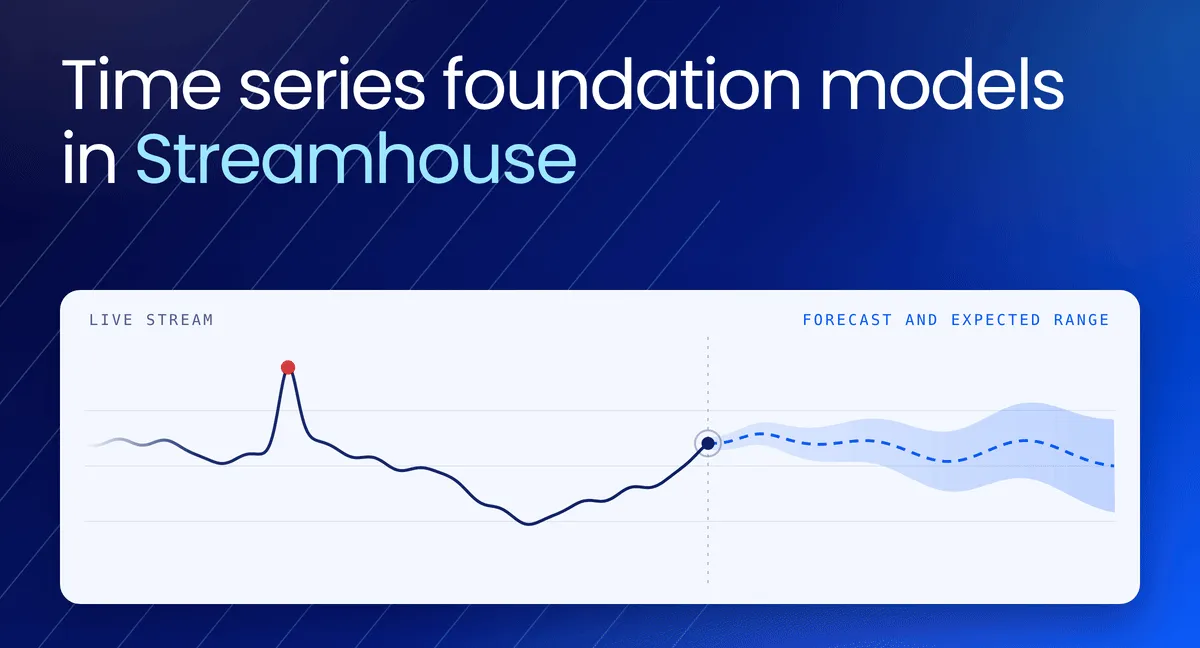
Im Einzelhandel kann die Funktion AI_DETECT_ANOMALIES anhand der jüngsten Historie für jede Verkaufszeitreihe einen erwarteten Bereich festlegen. Ein Team kann das Konfidenzniveau auswählen und anschließend einen ungewöhnlichen Messwert mit Bestands- und Filialdaten kombinieren, um eine wahrscheinliche Ursache zu ermitteln, etwa ein Problem im Regal oder den Bedarf, Waren nachzufüllen.
Prognosen lassen sich bei neuen Ereignissen aktualisieren
IBM Research präsentiert Streaming-Zeitreihenmodelle als Möglichkeit, Prognosen mit den operativen Systemen zu verbinden, die für den nächsten Schritt zuständig sind. Prognosen können aktualisiert werden, sobald neue Beobachtungen eintreffen, abhängig von den Anforderungen des Modells und der Konfiguration der Datenpipeline. Ergebnisse können zudem an Anwendungen weitergeleitet werden, in denen Teams sie mit Geschäftskontext, Regeln und menschlichem Urteilsvermögen kombinieren.
Ein Beispiel aus der Lieferkette nutzt AI_FORECAST, um eine 28-Tage-Nachfrageprognose für Produkte und Filialen zu erstellen, einschließlich einer P10- und P90-Spanne. Sobald neue Verkaufsdaten eintreffen, kann eine Planungsanwendung die Prognose mit Beständen, Lieferzeit und dem vom Planer gewählten Servicelevel kombinieren, um einen Nachbestellpunkt zu berechnen.
Für Anwender deutet die Ankündigung auf einen Wandel hin: weg von der Analyse von Zeitreihendaten nach einem Ereignis und hin zur Nutzung von Prognosen und Anomaliesignalen, während sich die Abläufe noch verändern. Für Unternehmen könnte die Kombination aus Streaming-Daten, kompakten CPU-basierten Modellen und Anwendungslogik zeitnahe Entscheidungen unterstützen, ohne dass jedes Team für jede Zeitreihe ein eigenes Modell entwickeln und warten muss.
Hugging Face: Time-Series Models in the Streamhouse: A New Frontier and Use Cases