CoreWeave macht AI Object Storage auf der NVIDIA GTC allgemein verfügbar
CoreWeave hat CoreWeave AI Object Storage allgemein verfügbar gemacht, einen verwalteten, S3-kompatiblen Objektspeicherdienst für KI-Training und Inferenz. Das Unternehmen kündigte den Start auf der NVIDIA GTC an.
- CoreWeave AI Object Storage ist allgemein verfügbar und wurde auf der NVIDIA GTC angekündigt.
- Der S3-kompatible Dienst zielt auf KI-Training und Inferenz ab und bietet laut CoreWeave bis zu 2 GB/s pro GPU.
- LOTA speichert Daten zwischen beziehungsweise stellt sie auf lokalen NVMe-Laufwerken der GPU-Knoten bereit, um die Netzwerklatenz zu senken.
- Laut CoreWeave fallen keine Egress-, Anfrage- oder versteckten Gebühren an.
- Der Dienst lässt sich in CKS, SAML/SSO, Terraform und verwaltete Grafana-Dashboards integrieren.
Was CoreWeave auf den Markt bringt
Laut CoreWeave ist AI Object Storage für GPU-intensives Modelltraining ausgelegt und bietet Kapazitäten im Exabyte-Bereich. Der Dienst ergänzt das bestehende Speicherangebot des Unternehmens, zu dem Distributed File Storage und Dedicated Storage gehören.
CoreWeave argumentiert, herkömmlicher Cloud-Speicher stoße an Grenzen, wenn Modelle größer und komplexer werden. Der neue Dienst sei von Grund auf entwickelt worden, um diesen Leistungsanforderungen gerecht zu werden. Klassische Objektspeichersysteme würden in datenintensiven KI-Workflows häufig zu Engpässen führen.
Der Dienst ist darauf ausgelegt, mit den NVIDIA-GPU-Compute-Clustern von CoreWeave zusammenzuarbeiten. Nach Angaben des Unternehmens unterstützt er Leistungswerte von bis zu 2 GB/s pro GPU und skaliert auf Hunderttausende GPUs. Zudem werde die neueste NVIDIA-GPU-Architektur, darunter Blackwell und Hopper, vollständig unterstützt.
LOTA-Caching und Preismodell
Ein zentraler Bestandteil des Produkts ist der Local Object Transport Accelerator, kurz LOTA. Laut CoreWeave speichert er häufig genutzte Datensätze zwischen und/oder stellt Daten direkt auf den lokalen NVMe-Laufwerken der GPU-Knoten bereit. Das Unternehmen sagt, dies verringere die Netzwerklatenz und beschleunige das Training.
CoreWeave erklärt außerdem, die Caching-Technologie funktioniere ohne zusätzliche Tools oder komplexe Konfigurationen, sodass sich KI-Teams auf Aufbau und Verfeinerung ihrer Modelle konzentrieren können.
Zur Preisgestaltung nennt das Unternehmen Folgendes:
- Keine Egress-, Anfrage- oder versteckten Gebühren; Kunden zahlen nur für den genutzten Speicher.
- Kapazität für Billionen von Objekten und Exabytes an Daten, mit Leistung, die mit dem Speicherbedarf wächst.
- Verschlüsselung im Ruhezustand und bei der Übertragung, rollenbasierte Zugriffskontrolle, Audit-Logging und Lifecycle-Richtlinien.
Integration in die CoreWeave-Plattform
CoreWeave zufolge soll sich AI Object Storage in sein Cloud-Ökosystem einfügen. Der Dienst unterstützt die SAML/SSO-Authentifizierung der Plattform für Nutzerverwaltung und Identitätsföderation. LOTA ist in den CoreWeave Kubernetes Service (CKS) integriert, was nach Angaben des Unternehmens eine enge Verzahnung zwischen CKS-Anwendungen und der Caching-Schicht ermöglicht.
Entwickler können den Speicher mit dem CoreWeave-Terraform-Provider verwalten, der Automatisierung und Infrastructure-as-Code-Workflows ermöglicht, und Speicherressourcen gemeinsam mit GPU-Compute-Clustern bereitstellen.
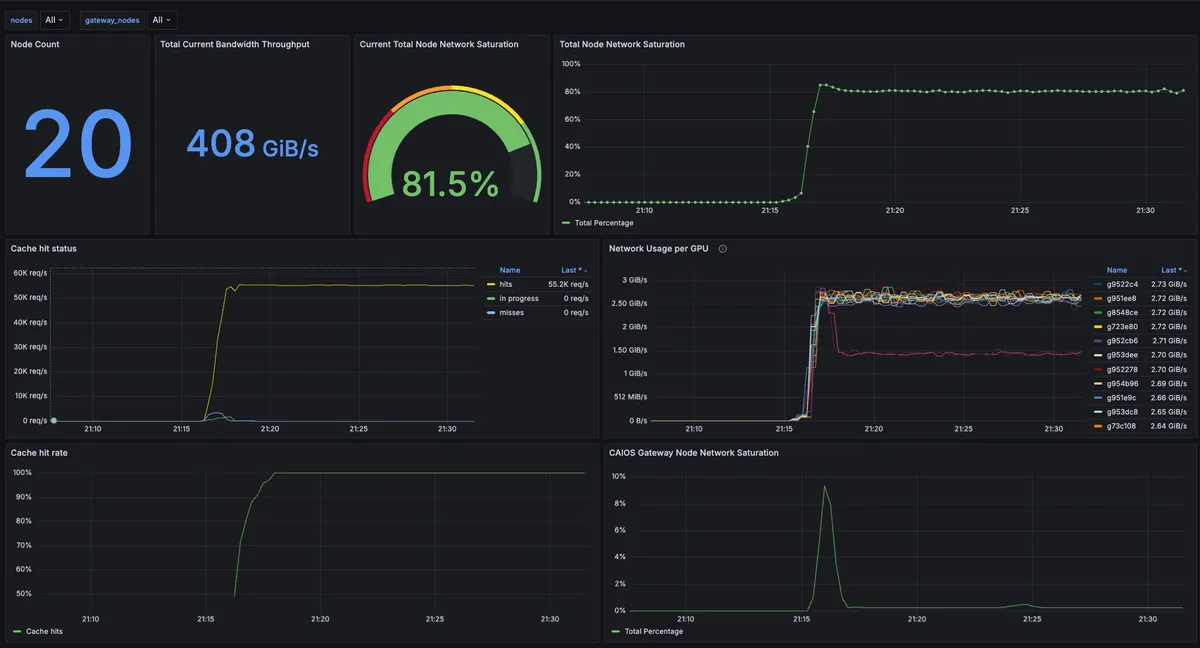
Über die CoreWeave Console steht ein verwaltetes Grafana-Dashboard zur Verfügung. Es zeigt Anfragen pro Sekunde, Durchsatz beziehungsweise Bandbreitennutzung und Anfragedauer an. Die Daten lassen sich nach Bucket, Region, Operationstyp oder Antwortcode gruppieren oder filtern. Das helfe Teams laut CoreWeave, Nutzungsmuster zu verstehen, Probleme zu erkennen und zu beheben.
Was das für KI-Teams bedeutet
Für Teams, die Training oder Inferenz bereits auf CoreWeave-GPUs betreiben, erweitert der Start das Angebot um eine S3-kompatible Objektspeicheroption, die an dieselbe Infrastruktur gekoppelt ist. Da es nach Unternehmensangaben keine Egress- und Anfragegebühren gibt, besteht das Preismodell allein aus einer Speichergebühr.
Die Leistungsangaben, darunter bis zu 2 GB/s pro GPU, stammen von CoreWeave selbst; unabhängige Benchmarks enthält die Quelle nicht. Das Unternehmen verweist zudem auf sein übergreifendes Infrastrukturdesign, das nach eigenen Angaben bis zu 20 Prozent mehr GPU-Leistung freisetzt.