Blackwell
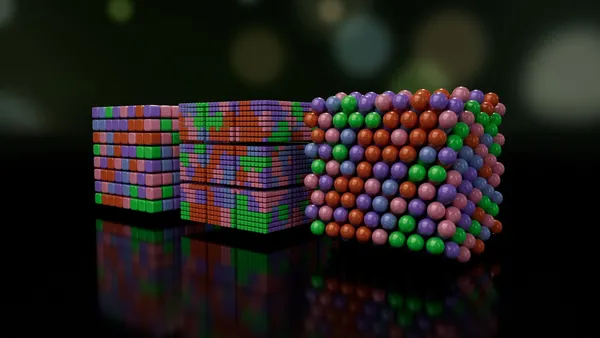
NVIDIA beschleunigt mit Tensor-Core-FP32-Methoden die Inferenz des Point Edge Transformer für MLIPs
Laut NVIDIA können Tensor-Core-Methoden, die FP32-Matrixrechnung emulieren, maschinell gelernte interatomare Potenziale ohne erneutes Training beschleunigen. In Tests…
CoreWeave erreicht bei MLPerf Endpoints 441.740 Token pro Sekunde mit DeepSeek-R1
CoreWeave gibt an, im erstmals ausgetragenen MLPerf-0.7-Endpoints-Benchmark führende Ergebnisse erzielt zu haben: Mit dem Reasoning-Modell DeepSeek-R1 auf 68…
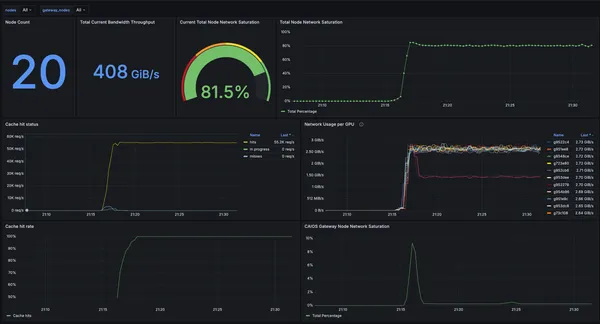
CoreWeave macht AI Object Storage auf der NVIDIA GTC allgemein verfügbar
CoreWeave hat CoreWeave AI Object Storage allgemein verfügbar gemacht, einen verwalteten, S3-kompatiblen Objektspeicherdienst für KI-Training und Inferenz. Das…
NVIDIA RTX Spark: Windows-Notebooks ab 2.399 Dollar mit bis zu 128 GB Speicher erhältlich
Notebooks mit NVIDIA RTX Spark sind ab sofort erhältlich. Sie bringen Blackwell-RTX-Grafik, bis zu 128 GB Unified Memory und die NVIDIA-KI-Plattform in schlanke…
Baseten nimmt NVIDIAs offenes multimodales Modell Nemotron 3.5 Super VL ins Angebot
Baseten stellt NVIDIAs Nemotron 3.5 Super VL für Inferenz und Anpassung bereit. Das offene multimodale Modell verbindet visuelles Verständnis, Reasoning und Tool-Nutzung…
NVIDIA bringt Green Contexts mit CUDA 13.1 in die CUDA Runtime API
NVIDIA hat erläutert, wie Green Contexts, die seit CUDA 13.1 auch über die CUDA Runtime API zugänglich sind, es einer einzelnen Anwendung erlauben…
 Top-Meldung
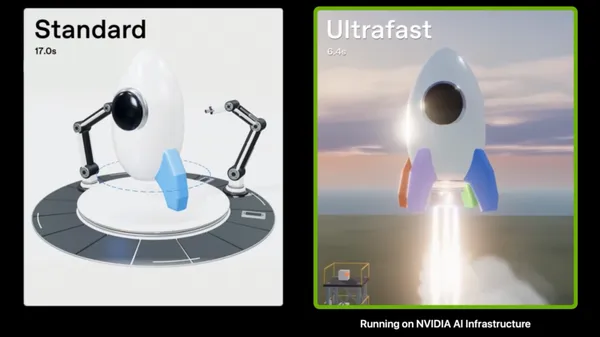
OpenAIs GPT-6 Astra Ultrafast läuft auf NVIDIA Blackwell und ist bis zu achtmal schneller
GPT-6 Astra Ultrafast, ein schnellerer Modus von OpenAIs Modell Astra auf NVIDIA-Blackwell-GPUs, ist ab sofort in der OpenAI API sowie für berechtigte Nutzer von ChatGPT…
ForschungMetas TLX-basierte Jagged Flash Attention schlägt FA4 auf Blackwell mit dreimal weniger Code
Metas Team hat mit TLX (Triton Low-level Extensions) einen Jagged-Flash-Attention-Kernel (JFA) für NVIDIA Blackwell B200 entwickelt. Laut dem Beitrag im PyTorch-Blog…