NVIDIA beschleunigt mit Tensor-Core-FP32-Methoden die Inferenz des Point Edge Transformer für MLIPs
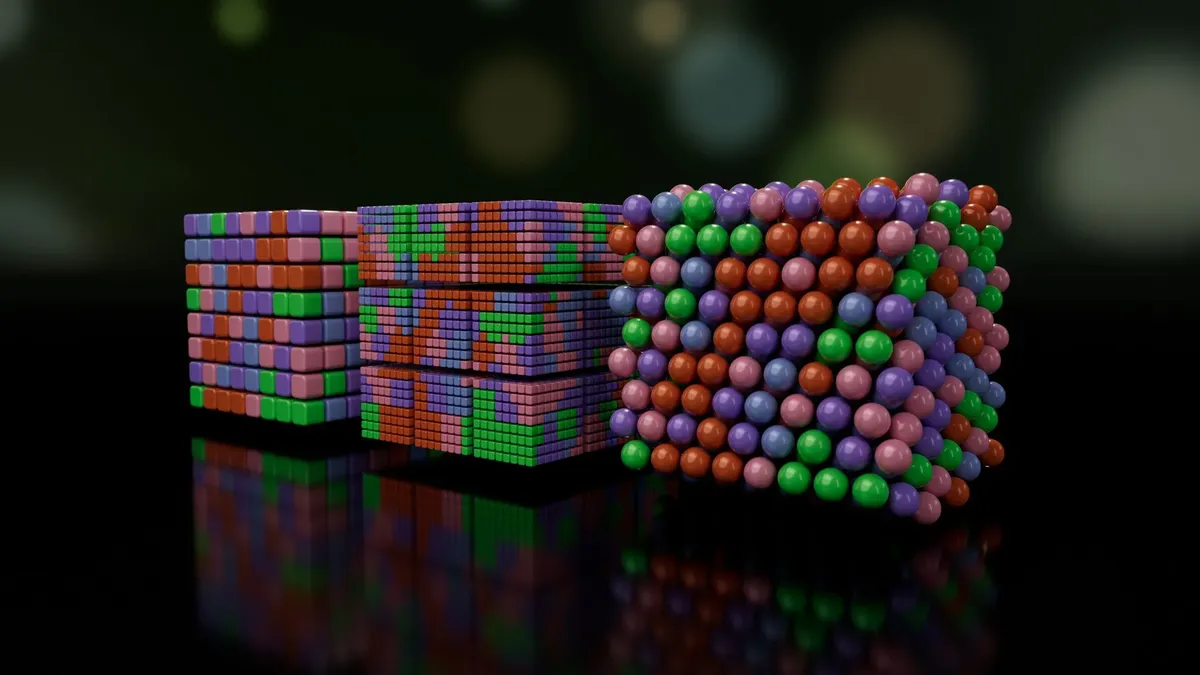
Laut NVIDIA können Tensor-Core-Methoden, die FP32-Matrixrechnung emulieren, maschinell gelernte interatomare Potenziale ohne erneutes Training beschleunigen. In Tests mit dem Point Edge Transformer (PET) beschleunigte BF16x9 auf Blackwell-GPUs große GEMMs bei einem System mit 17.280 Atomen um das 2,2- bis 2,5-Fache.
- BF16x9 auf Blackwell-GPUs beschleunigte große PET-GEMMs um das 2,2- bis 2,5-Fache bei 17.280 Atomen und um das 1,2- bis 1,4-Fache bei 192 Atomen.
- Laut NVIDIA liegt der BF16x9-Fehler unter der eigenen Nichtdeterminiertheit des Modells.
- TF32x3 auf Ampere-GPUs beschleunigte wichtige GEMMs um das 1,7- bis 1,9-Fache und den gesamten MD-Schritt um bis zu das 1,5-Fache.
- TF32x3 entsprach in NVE-Trajektorien der FP32-Energieerhaltung, während TF32 mit einem Durchlauf Drift und Rauigkeit zeigte.
- Für den Einsatz der Methoden sind weder erneutes Training noch Änderungen an der Architektur nötig.
Warum Präzision in atomistischen Simulationen wichtig ist
Atomistische Simulationen helfen Forschenden zu verstehen, wie sich Moleküle und Materialien verhalten, von chemischen Reaktionen und Phasenübergängen bis zu mechanischem Versagen. Quantenmechanische Verfahren wie die Dichtefunktionaltheorie (DFT) liefern genaue Energien und Kräfte, doch ihr Rechenaufwand beschränkt sie oft auf kleine Systeme oder kurze Simulationen. Klassische interatomare Potenziale sind deutlich schneller, aber ihre festen funktionalen Formen begrenzen Genauigkeit und Übertragbarkeit.
Maschinell gelernte interatomare Potenziale (MLIPs) liegen zwischen beiden Ansätzen. Sie nutzen neuronale Netze, um potenzielle Energien und interatomare Kräfte zu einem Bruchteil der Kosten vorherzusagen. Sie effizient auszuführen, bleibt laut NVIDIA jedoch schwierig. Die Kräfte ergeben sich durch Differenzieren der vorhergesagten Energie und steuern in der Molekulardynamik über viele Zeitschritte die Aktualisierung von Atomgeschwindigkeiten und -positionen. Kleine Fehler können sich aufsummieren, daher ist die numerische Präzision sowohl für die physikalische Genauigkeit als auch für die Stabilität der Trajektorien entscheidend.
Aus diesem Grund führen viele MLIPs die Inferenz weiterhin in FP32 aus, obwohl moderne NVIDIA-GPUs mit Tensor-Core-Operationen in niedriger Präzision einen deutlich höheren Durchsatz bei Matrixmultiplikationen bieten.
So funktionieren die FP32-Emulationsmethoden
Der von NVIDIA untersuchte Ansatz zerlegt jeden FP32-Operanden in Komponenten niedrigerer Präzision, berechnet deren Kreuzprodukte auf Tensor Cores und fügt die Ergebnisse mit FP32-Akkumulation wieder zusammen. Laut NVIDIA lässt sich so der Durchsatz steigern, während die Genauigkeit nahe an nativem FP32 bleibt, ohne dass Gewichte oder Architektur des Modells verändert werden müssen.
Auf Blackwell-GPUs bietet NVIDIA cuBLAS einen BF16x9-Pfad. Dabei wird jeder FP32-Operand in drei BF16-Komponenten aufgeteilt, und neun paarweise Produkte werden mit der nötigen Skalierung wieder kombiniert. Aktiviert wird er über die Umgebungsvariable CUBLAS_EMULATE_SINGLE_PRECISION=1, sodass kompatible PyTorch-GEMMs ihn ohne eigene GEMM-Implementierung nutzen können. cuBLAS unterstützt ihn auf Blackwell-GPUs mit Compute Capability 10.0 oder 10.3.
Auf Ampere-GPUs verwendet TF32x3 pro Operand eine führende TF32-Komponente und eine TF32-Restkomponente. NVIDIAs Implementierung kommt ohne Skalierungsfaktoren aus, berechnet drei Kreuzprodukte und lässt den Term Rest mal Rest weg. NVIDIA CUTLASS stellt sie über den Operator OpMultiplyAddFastF32 bereit, wobei Ein- und Ausgaben in FP32 bleiben.
Ergebnisse beim Point Edge Transformer
PET ist ein Transformer-basiertes MLIP, das vom Lab COSMO an der EPFL entwickelt wurde. NVIDIA wählte es als anspruchsvollen Test, weil es bereits einen Großteil der Laufzeit in hochoptimierten GEMMs verbringt und daher wenig Spielraum bleibt. Die Tests nutzten den PET-MAD-Small-Checkpoint mit 26 Millionen Parametern an einer Wasserbox mit 192 Atomen und einer Superzelle mit 17.280 Atomen, außerdem den Large-Checkpoint mit 255 Millionen Parametern am System mit 192 Atomen.
- BF16x9 auf Blackwell: Große GEMMs liefen bei der Last mit 17.280 Atomen 2,2- bis 2,5-mal schneller, bei der Last mit 192 Atomen 1,2- bis 1,4-mal schneller.
- MD-Schritt, 192 Atome: Die Performant-Strategie erreichte das 1,2-Fache, die Eager-Strategie das 1,1-Fache, jeweils im Vergleich zu kompiliertem FP32.
- MD-Schritt, 17.280 Atome: Die Performant-Strategie erreichte das 1,7-Fache, die Eager-Strategie das 1,4-Fache.
- TF32x3 auf Ampere: Wichtige GEMMs wurden 1,7- bis 1,9-fach schneller, der gesamte Molekulardynamikschritt bis zu 1,5-fach, bei einem Kraftfehler nahe der FP32-Basislinie.
Die Performant-Strategie nutzt BF16x9, wenn cuBLAS dadurch einen Geschwindigkeitsvorteil erwartet, während die Eager-Strategie es immer einsetzt, wenn die Operation es unterstützt. Laut NVIDIA liegt der Fehler durch BF16x9 unter dem Niveau der eigenen Nichtdeterminiertheit des Modells.
Energieerhaltung und Strukturrelaxation
NVIDIA testete TF32x3 außerdem auf Glätte der potenziellen Energie, Energieerhaltung und Strukturrelaxation. In NVE-Trajektorien entsprach TF32x3 dem Verhalten von FP32, während TF32 mit nur einem Durchlauf Drift und Rauigkeit zeigte.
Bei der Relaxation einer Cantor-Legierungsplatte mit 539 Atomen konvergierte TF32x3 in 218 bis 222 Schritten bei 1,5-facher Beschleunigung pro Schritt. TF32 mit nur einem Durchlauf erreichte die Kraft-Toleranz selbst nach 1.000 Schritten nicht.
Was das für Anwender bedeutet
Die Ergebnisse legen nahe, dass MLIP-Nutzer auf Blackwell- oder Ampere-GPUs Geschwindigkeit gewinnen können, ohne neu zu trainieren, die Architektur zu ändern oder eigene Kernel zu schreiben. NVIDIA weist darauf hin, dass die Methoden in Kombination mit optimierter Graphkonstruktion, fusionierten Operationen, eigenen Kerneln und CUDA Graphs weitere Gewinne bringen können. Diesen kombinierten Effekt habe man jedoch nicht gemessen, er müsse für jede Arbeitslast Ende-zu-Ende ermittelt werden.
Als nächste Schritte verweist NVIDIA auf die cuBLAS-Dokumentation für BF16x9, die Dokumentation des NVIDIA ALCHEMI Toolkit mit Beispielen zur TF32x3-Integration sowie das UPET-Repository für PET-Modell-Checkpoints.
NVIDIA Developer: Unlocking Tensor Core Performance for Machine Learning Interatomic Potentials