OpenAIs GPT-6 Astra Ultrafast läuft auf NVIDIA Blackwell und ist bis zu achtmal schneller
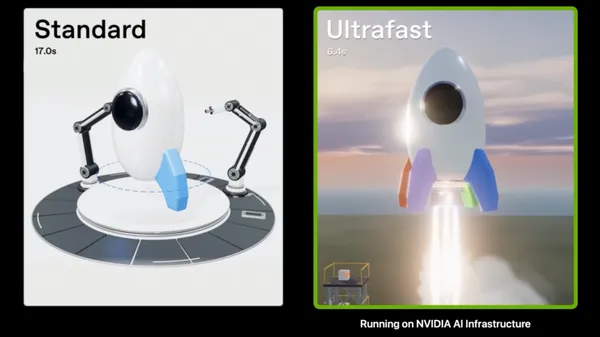
GPT-6 Astra Ultrafast, ein schnellerer Modus von OpenAIs Modell Astra auf NVIDIA-Blackwell-GPUs, ist ab sofort in der OpenAI API sowie für berechtigte Nutzer von ChatGPT Work und Codex verfügbar. Laut NVIDIA erzeugt der Modus Token bis zu achtmal schneller als der Modus Astra Standard.
- GPT-6 Astra Ultrafast ist ab sofort in der OpenAI API sowie für berechtigte Nutzer von ChatGPT Work und Codex verfügbar.
- Der Modus läuft auf NVIDIA-Blackwell-GPUs und erzeugt Token laut NVIDIA bis zu achtmal schneller als Astra Standard.
- OpenAI nutzt eigene Modelle, um die Inferenz-Software auf NVIDIA-GPUs zu verfeinern, auch nach der Bereitstellung.
- Zugang, Preise und Details zur Umsetzung stehen im Ultrafast-Leitfaden.
Was Ultrafast bietet
Laut NVIDIA wird Ultrafast durch Inferenz-Optimierungen in den Modellen von OpenAI beschleunigt, die die NVIDIA-Blackwell-Architektur gezielt nutzen. Das Ergebnis sei eine bis zu achtmal schnellere Token-Generierung im Vergleich zu Astra Standard.
Der Modus richtet sich an Entwickler. NVIDIA argumentiert, dass eine schnellere Generierung die Zyklen aus Bearbeiten, Testen und Debuggen bei Coding-Agenten verkürzen, die Wartezeit für Antworten zwischen Tool-Aufrufen senken und interaktive Anwendungen reaktionsschneller machen kann.
Das Unternehmen betont, dass Geschwindigkeit vor allem dann zählt, wenn sie sich über einen ganzen Arbeitsablauf hinweg wiederholt. Ein Agent schreibt Code, nutzt ein Tool, prüft das Ergebnis und entscheidet über den nächsten Schritt. Ultrafast bringe die Fähigkeiten von Astra in diese zeitkritischen Schleifen, so NVIDIA.
Modelle, die ihr eigenes Serving optimieren
Philippe Tillet, Inference Lead bei OpenAI, sagte, "NVIDIA's deep investment in tooling and documentation has enabled us to make our models exceptionally good at programming Blackwell and Rubin GPUs." Er fügte hinzu, Astra könne dieses Wissen in leistungsstarke Kernels umsetzen, die NVIDIA-Hardware bei Latenz, Durchsatz und Kosten überzeugend machen.
Uday Ruddarraju, Chief Technology Officer für Compute bei OpenAI, erklärte, das Unternehmen habe seine internen Modelle genutzt, um die Inferenz auf NVIDIA-GPUs zu optimieren, und die Programmierbarkeit von NVIDIA habe die Beschleunigung hinter Astra Ultrafast mit ermöglicht.
Laut NVIDIA geht diese Arbeit auch nach der Bereitstellung weiter. OpenAI nutze seine eigenen Modelle, um die auf NVIDIA-GPUs laufende Inferenz-Software zu verfeinern, Verbesserungen zu testen und umzusetzen. Dieser fortlaufende Prozess könne die Antworten der Modelle beschleunigen und die bereitgestellte Infrastruktur mit der Zeit produktiver machen.
Flexibilität über Workloads hinweg und Zugang für Entwickler
NVIDIA verweist außerdem auf die Programmierbarkeit seiner Plattform. Entwickler und Forscher könnten die Infrastruktur für Training, Inferenz und Reinforcement Learning wiederverwenden, während sich die Modelle weiterentwickeln. Diese Flexibilität helfe Teams, Rechenleistung bei veränderter Nachfrage umzuwidmen, die Auslastung zu verbessern und eine Überdimensionierung für jeden einzelnen Workload zu vermeiden.
Entwickler können GPT-6 Astra Ultrafast schon heute über die API nutzen. Für Zugang, Preise und Details zur Umsetzung verweist NVIDIA auf den Ultrafast-Leitfaden. Die Ankündigung selbst nennt weder Preise noch weitere Einzelheiten.
Für Teams, die Coding-Agenten und interaktive Anwendungen entwickeln, lautet das Versprechen: kürzere Wartezeiten bei jedem Schritt einer mehrstufigen Aufgabe. Der Faktor 8 ist ein von NVIDIA genannter Höchstwert, die tatsächlichen Gewinne hängen daher vom jeweiligen Workload ab.