CoreWeave bietet Cloud-Instanzen mit NVIDIA-HGX-H100-Supercomputern an
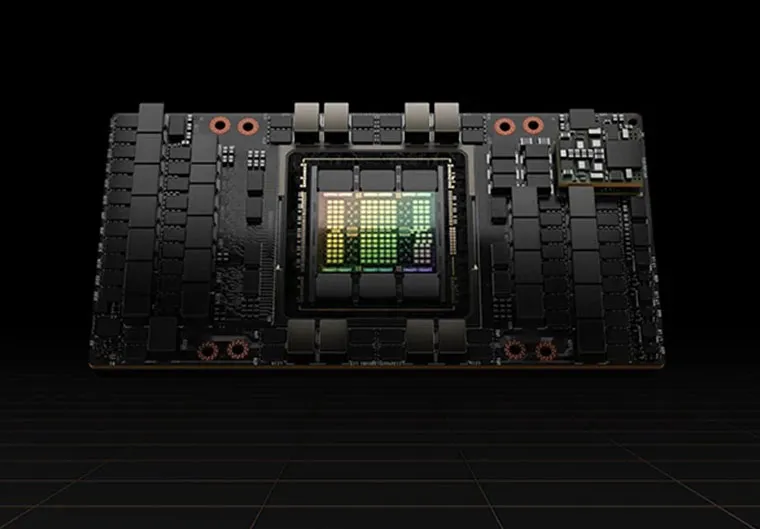
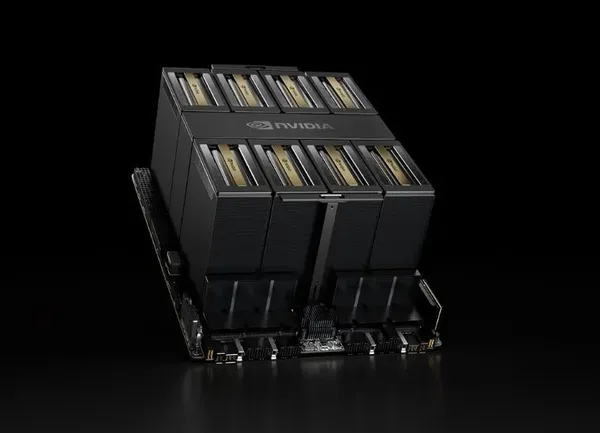
CoreWeave will zu den ersten Anbietern gehören, die Cloud-Instanzen auf Basis von NVIDIA-HGX-H100-Supercomputern bereitstellen. Das GPU-Cloud-Unternehmen richtet sich an KI- und Machine-Learning-Firmen, die große Modelle trainieren, skalieren und betreiben.
- CoreWeave plant Cloud-Instanzen mit NVIDIA-HGX-H100-Supercomputern und will nach eigenen Angaben zu den ersten Anbietern gehören.
- Die NVIDIA-Plattform soll gegenüber der HGX A100 bis zu neunmal schnelleres KI-Training und bis zu 30-mal schnellere KI-Inferenz bieten.
- CoreWeave behauptet, Kunden sparten gegenüber großen, allgemein ausgerichteten Public Clouds bis zu 80 %, ohne Zahlung für Leerlaufzeiten.
- Der Dienst läuft auf Kubernetes-nativer Infrastruktur und unterstützt quelloffene Modelle wie Stable Diffusion, GPT-NeoX-20B und BLOOM.
- Kunden können H100-Kapazitäten bereits reservieren, die Quelle nennt aber weder Preise noch Termine.
Was CoreWeave anbietet
CoreWeave hat angekündigt, NVIDIA-HGX-H100-Supercomputer für nach eigener Beschreibung hochmoderne KI- und ML-Unternehmen bereitzustellen. Laut Unternehmen zielt das Angebot darauf ab, Modelle der nächsten Generation zu trainieren, zu skalieren und einzusetzen.
Die H100-Instanzen ergänzen ein Portfolio, zu dem laut CoreWeave bereits A100, A5000, virtuelle Maschinen, flexibler Speicher und Hochleistungsnetzwerke gehören. Alles wird über die Kubernetes-native Infrastruktur von CoreWeave bereitgestellt. Das Unternehmen beschreibt sich als speziell für groß angelegte, GPU-beschleunigte Workloads konzipiert und auf die anspruchsvollsten KI- und Machine-Learning-Anwendungen spezialisiert.
Kunden können sich über die CoreWeave-Website näher über die HGX H100 informieren oder Kapazitäten reservieren.
Leistungsversprechen für die HGX H100
Die Leistungsangaben in der Ankündigung beschreiben die Plattform von NVIDIA, nicht eigene Benchmarks von CoreWeave. Laut der Quelle ermöglicht die HGX H100 gegenüber der NVIDIA HGX A100 bis zu siebenmal mehr Effizienz bei Anwendungen des Hochleistungsrechnens (HPC), bis zu neunmal schnelleres KI-Training auf den größten Modellen und bis zu 30-mal schnellere KI-Inferenz.
Der Beitrag verweist zudem auf die niedrigste NVIDIA-GPUDirect-Netzwerklatenz am Markt, die über die Plattform NVIDIA Quantum-2 InfiniBand erreicht werde. Zusammen verkürzen diese Merkmale laut Quelle die Trainingszeit von KI-Modellen auf „Tage oder Stunden statt Monate“.
Im Beitrag wird Dave Salvator, Director of Product Marketing, NVIDIA Enterprise Infrastructure, zitiert: „Das neue Angebot von CoreWeave mit Instanzen auf Basis von NVIDIA-HGX-H100-Supercomputern bietet Kunden die Flexibilität und Leistung, die für groß angelegte HPC-Anwendungen nötig sind.“
Preismodell und Software-Unterstützung
CoreWeave gibt an, dass sein Preismodell Kunden bis zu 80 % gegenüber großen, allgemein ausgerichteten Public Clouds spare. Dafür nennt das Unternehmen zwei Gründe. Erstens zahlten Kunden nur für die hochgradig konfigurierbaren HPC-Ressourcen, die sie tatsächlich nutzen, und nie für Leerlaufzeiten. Zweitens verschafften die Kubernetes-native Infrastruktur und die Netzwerkarchitektur Leistungsvorteile, darunter nach eigenen Angaben branchenführende Hochfahrzeiten und reaktionsschnelles Auto-Scaling, mit denen Kunden Rechenleistung effizienter nutzen könnten.
Auf der Softwareseite setzt CoreWeave nach eigenen Angaben eine Reihe quelloffener Kubernetes-Projekte ein und lässt sich in Technologien wie Determined.AI integrieren. Zudem unterstützt das Unternehmen quelloffene KI-Modelle wie Stable Diffusion, GPT-NeoX-20B und BLOOM.
Was das für Kunden bedeutet
CEO und Mitgründer Michael Intrator verstand den Schritt als Bestätigung der eingeschlagenen Richtung: „Das bestätigt, was wir aufbauen und wohin wir uns entwickeln.“ Der Erfolg von CoreWeave werde weiterhin davon getragen, GPU-beschleunigte Rechenleistung sowohl für Start-ups als auch für Unternehmenskunden verfügbar zu machen, und die Investition in die HGX-H100-Plattform baue dieses Engagement aus.
Für KI-Teams bedeutet das praktisch: Sie erhalten bei einem spezialisierten Cloud-Anbieter Zugang zu neuerer NVIDIA-Hardware, neben älteren GPU-Optionen und mit nutzungsabhängiger Abrechnung. Die im Beitrag genannten Kosten- und Geschwindigkeitsvorteile sind Eigenangaben der Unternehmen, Preisdetails oder Verfügbarkeitstermine nennt die Quelle nicht.