CoreWeave macht NVIDIA-HGX-B200-Instanzen allgemein verfügbar
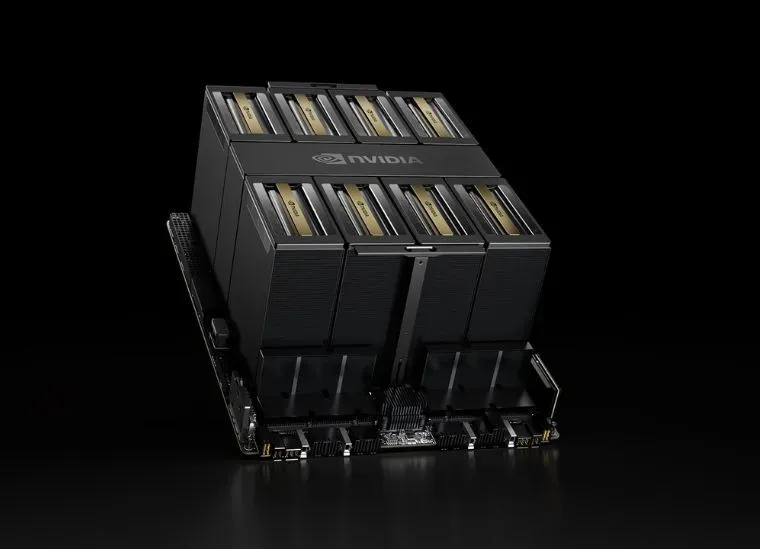
CoreWeave hat seine Instanzen auf Basis von NVIDIA HGX B200 allgemein verfügbar gemacht und erweitert damit den Zugang zur Blackwell-Hardware über die erste Bereitstellung für einen einzelnen strategischen Kunden hinaus. Laut Unternehmen liefern die Instanzen pro GPU mehr als doppelt so hohe Leistung wie die Vorgängergeneration mit NVIDIA-Hopper-GPUs.
- CoreWeave hat NVIDIA-HGX-B200-Instanzen allgemein verfügbar gemacht, nach einer ersten Bereitstellung im Februar 2025.
- Jede Instanz bietet 8 B200-GPUs mit je 180 GB HBM3e, 2 Intel-Emerald-Rapids-8562Y+-CPUs und 61,44 TB NVMe-Speicher.
- CoreWeave verspricht bis zu 15-mal schnellere Inferenz und 3-mal schnelleres Training als bei H100-basierten Instanzen.
- Die Instanzen sind ab sofort als b200-8x in der Availability Zone US-WEST-01A verfügbar.
- SUNK, CKS, Observe und Mission Control übernehmen Orchestrierung, Monitoring und Zuverlässigkeit.
Vom Einzelkunden zur allgemeinen Verfügbarkeit
CoreWeave hatte NVIDIA-HGX-B200-Instanzen erstmals im Februar 2025 bereitgestellt. Damals versorgte das Unternehmen einen strategischen Kunden mit mehr als 10.000 NVIDIA-Blackwell-GPUs, verbunden über NVIDIA-Quantum-2-InfiniBand-Netzwerke. Der neue Start, so das Unternehmen, "erweitert den Zugang erheblich" zu der Hardware.
CoreWeave positioniert die Instanzen für KI-Training und Echtzeit-Inferenz in KI-Workloads von Unternehmen. Kunden können sie ab dem Tag der Ankündigung mit der Instance-ID b200-8x in der Availability Zone US-WEST-01A bereitstellen. Interessierte Unternehmen sollen sich beim Anbieter melden, um Instanzen zu reservieren.
Hardware und Leistungsversprechen
Jede Instanz kombiniert 8 NVIDIA-B200-Blackwell-GPUs mit jeweils 180 GB HBM3e-Speicher, verbunden über NVIDIA NVLink und NVLink Switch. Hinzu kommen 2 Intel-Emerald-Rapids-8562Y+-CPUs und 61,44 TB lokaler NVMe-Speicher.
Für die Vernetzung nutzt jede Instanz eine NVIDIA BlueField-3 DPU und 8 NVIDIA-ConnectX-7-InfiniBand-Host-Channel-Adapter. Sie sind an ein nicht blockierendes 400G-NDR-InfiniBand-Fabric von NVIDIA Quantum-2 angebunden.
CoreWeave nennt im Vergleich zu Systemen der Hopper-Generation folgende Leistungswerte:
- Bis zu 15-mal schnellere Inferenz bei Modellen wie GPT-MoE-1.8T gegenüber H100-basierten Instanzen.
- 3-mal schnelleres Training als bei H100-basierten Instanzen.
- 2-mal schnellere Query-Benchmarks als mit NVIDIA-Hopper-GPUs, unterstützt durch eine dedizierte Dekomprimierungs-Engine.
Die Plattform unterstützt die Präzisionsformate FP4 und FP8 über die Transformer Engine der zweiten Generation. Es handelt sich um Herstellerangaben, die Testbedingungen beschreibt die Quelle nicht.
Der Software-Stack rund um die Hardware
CoreWeave hebt mehrere eigene Werkzeuge für den Betrieb der B200-Systeme hervor. CoreWeave SUNK integriert Slurm und Kubernetes, sodass Kunden große Modelle auf demselben B200-Cluster trainieren und ausliefern können. Laut Unternehmen skaliert es Ressourcen dynamisch, teilt Rechenleistung zwischen Workloads und platziert Jobs per topologiebewusstem Scheduling nach GPU-Interconnect und Datennähe, was die Model FLOPs Utilization (MFU) steigern soll.
CoreWeave Kubernetes Service (CKS) ist ein verwalteter Kubernetes-Dienst für KI-Workloads. Er betreibt die Instanzen direkt auf Bare-Metal-Servern, womit CoreWeave nach eigener Aussage möglichst geringe Latenz und höchsten Durchsatz erreichen will. Jeder HGX-B200-Cluster läuft in einer eigenen privaten Virtual Private Cloud, dedizierte BlueField-DPUs übernehmen Netzwerk-, Sicherheits- und Speicheraufgaben.
Fürs Monitoring liefert CoreWeave Observe Einblicke pro GPU, etwa zu GPU-XID-Fehlern, Speichernutzung, GPU-Auslastung, Stromverbrauch und Temperatur. CoreWeave Mission Control verbindet automatisiertes Monitoring mit menschlicher Expertenaufsicht für Zuverlässigkeit und Ausfallsicherheit.
Was das für Kunden bedeutet
Für Unternehmen, die Blackwell-Kapazität suchen, wird die B200 mit dem Start von einer einzelnen Großbereitstellung zu einem Angebot für mehr Kunden. Verfügbar ist es derzeit in einer Zone, US-WEST-01A. Preise oder Angaben zu weiteren Regionen nennt die Quelle nicht.
Zur Untermauerung ihrer Infrastrukturversprechen verweist CoreWeave zudem auf Platz 1 als Platinum-bewertete AI Cloud im ClusterMAX-Ranking von SemiAnalysis. Teams, die Training und Inferenz auf einem Cluster betreiben wollen, sind die Hauptzielgruppe der SUNK-Integration.