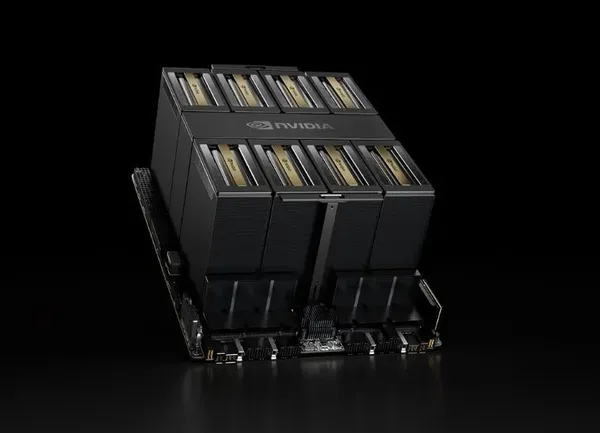
CoreWeave bringt große NVIDIA-Blackwell-Cluster für KI-Kunden auf den Markt
CoreWeave zufolge gehört das Unternehmen zu den ersten Anbietern, die große NVIDIA-Blackwell-Cluster auf den Markt bringen. Es gibt zwei Konfigurationen: NVIDIA HGX B200 und NVIDIA GB200 NVL72. Beide sind laut Unternehmen über NVIDIA Quantum-2 InfiniBand vernetzt.
- CoreWeave will zu den Ersten gehören, die große NVIDIA-Blackwell-Cluster auf den Markt bringen.
- Angeboten werden zwei Konfigurationen: NVIDIA HGX B200 und NVIDIA GB200 NVL72, verbunden über Quantum-2 InfiniBand.
- Die GB200 NVL72 verbindet 36 Grace CPUs mit 72 Blackwell-GPUs und ist flüssigkeitsgekühlt.
- CoreWeave nennt für die GB200 NVL72 bis zu 30-fach schnellere Echtzeit-Inferenz bei LLMs mit einer Billion Parametern, für die HGX B200 einen Faktor von 15.
- Das Unternehmen positioniert seine vollständig verwaltete Infrastruktur als Weg, den DevOps-Aufwand zu senken.
Zwei Blackwell-Konfigurationen
CoreWeave beschreibt sein Angebot als große NVIDIA-Blackwell-Cluster in zwei Varianten. Die erste ist die NVIDIA HGX B200, die nach Angaben des Unternehmens für besonders anspruchsvolle Workloads in den Bereichen KI, Datenverarbeitung und Hochleistungsrechnen ausgelegt ist. Es handelt sich um eine x86-Plattform mit NVIDIA-Blackwell-GPUs, die laut CoreWeave eine 15-fach schnellere Echtzeit-Inferenz bei Modellen mit einer Billion Parametern bietet.
Die zweite ist die NVIDIA GB200 NVL72, eine flüssigkeitsgekühlte Lösung im Rack-Maßstab. Sie verbindet 36 NVIDIA Grace CPUs mit 72 NVIDIA-Blackwell-GPUs und liefert nach Unternehmensangaben bis zu 30-fach schnellere Echtzeit-Inferenz für LLMs mit einer Billion Parametern. Alle Systeme sind über das ultraschnelle NVIDIA Quantum-2 InfiniBand miteinander verbunden.
Welche Lücke CoreWeave im Markt sieht
CoreWeave stellt den Start in den Kontext einer aus seiner Sicht bestehenden Lücke im Cloud-Markt. Kunden, die KI- und Machine-Learning-Workloads in großem Maßstab bei etablierten Hyperscalern betreiben, verbrächten demnach wertvolle Zeit damit, ihren Stack in allgemeinen Clouds erst aufzubauen und nachzurüsten, bevor es losgehen kann. Alternative Clouds konzentrierten sich dagegen meist auf kleinere Projekte und könnten die Rechenleistung nicht bereitstellen, die für den Einsatz von Large Language Models in Unternehmensqualität nötig sei.
Deshalb habe man begonnen, den nach eigener Darstellung ersten KI-Hyperscaler überhaupt aufzubauen, mit Fokus auf leistungsstarke, skalierbare und sichere, vollständig verwaltete Infrastruktur für KI-/ML-Kunden. Das Unternehmen verweist auf Tools seiner Teams für die automatisierte Zustandsprüfung von Knoten, schnelles Kopieren und Laden von Modellen sowie ein vereinfachtes Workload-Management. Außerdem erhielten Kunden beispiellose Einblicke in ihre Cluster, und die eigenen Ingenieure arbeiteten mit den Teams der Kunden zusammen, um Probleme rasch zu lösen.
Mehr als Training und Inferenz
In dem Beitrag heißt es, NVIDIA habe seine Blackwell-Architektur Anfang des Jahres auf der NVIDIA GTC vorgestellt. Blackwell kann bis zu 72 GPUs in einer einzigen NVIDIA-NVLink-Domäne verbinden. Das bringt laut CoreWeave eine höhere Bandbreite für die Kommunikation zwischen den GPUs, was dem Training und dem Betrieb riesiger Modelle zugutekomme.
Dem Unternehmen zufolge eröffnet das Einsatzfelder weit über KI-Training und Inferenz hinaus, etwa Quantencomputing, Wirkstoffforschung und Fusionsenergie. CoreWeave ergänzt, wissenschaftliches Rechnen und physikbasierte Simulationen stünden vor großen Fortschritten, da KI die nächsten Durchbrüche antreibe.
Was das für Kunden bedeutet
CoreWeave richtet die Cluster an Teams, die Infrastrukturaufwand vermeiden wollen. Mit dem vollständig verwalteten Ansatz müssten Kunden nach Angaben des Unternehmens weniger Zeit für DevOps aufwenden und könnten sich stärker auf den Betrieb ihrer Workloads und die schnellere Markteinführung ihrer Produkte konzentrieren. Zudem erhielten sie mehr Kontrolle und Transparenz über ihre Cluster, und die eigene, speziell für KI entwickelte Software solle maximale Ressourcenleistung und Effizienz sicherstellen.
Preise, Verfügbarkeitstermine oder Kundennamen nennt die Quelle nicht. Interessierte Unternehmen werden aufgefordert, CoreWeave für Gespräche über eine Partnerschaft zu kontaktieren. Bei den genannten Leistungswerten handelt es sich um Angaben aus CoreWeaves Beitrag.