CoreWeave macht Instanzen mit RTX PRO 6000 Blackwell Server Edition allgemein verfügbar
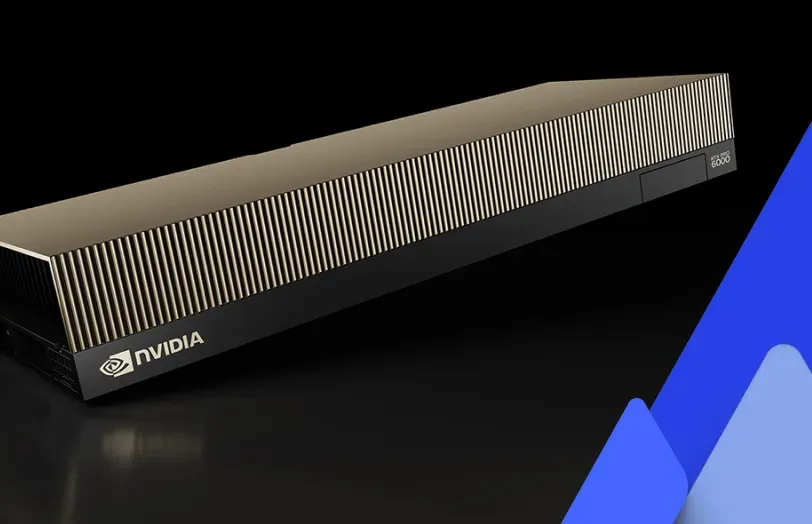
CoreWeave hat Instanzen auf Basis der NVIDIA RTX PRO 6000 Blackwell Server Edition allgemein verfügbar gemacht und nennt sich nach eigenen Angaben den ersten Cloud-Anbieter, der das tut. Die Instanzen richten sich an KI-, Grafik- und Hochleistungsrechen-Workloads und werden in der Region US-EAST-04 angeboten.
- CoreWeave nennt sich nach eigenen Angaben den ersten Cloud-Anbieter mit allgemein verfügbaren Instanzen auf Basis der NVIDIA RTX PRO 6000 Blackwell Server Edition.
- Die Instanzen sind in der Region US-EAST-04 verfügbar, mit bis zu 8 GPUs, zwei Intel-Emerald-Rapids-CPUs und BlueField-3-DPUs.
- CoreWeave nennt bis zu 5,6-mal schnellere LLM-Inferenz und 3,5-mal schnellere Text-zu-Video-Generierung als bei der L40S, basierend auf vorläufigen NVIDIA-Prognosen.
- Jede GPU hat 96 GB GDDR7-Speicher mit 1,6 TB/s, die Instanzen bieten mehr als 7 TB lokalen NVMe-Speicher.
- Der Zugang erfolgt über CKS und SUNK; Preise nennt die Ankündigung nicht.
Das bietet CoreWeave
Laut CoreWeave richten sich die neuen Instanzen an Unternehmen und Startups, die an generativer KI, Echtzeit-Rendering und der Entwicklung großer Sprachmodelle (LLMs) arbeiten. Das Unternehmen beschreibt seine Infrastruktur als gezielt dafür gebaut, dass Kunden das Potenzial der NVIDIA-Blackwell-Architektur voll ausschöpfen können.
Jede Instanz unterstützt Konfigurationen mit bis zu 8 GPUs. Dazu kommen zwei Intel-Emerald-Rapids-CPUs und NVIDIA-BlueField-3-DPUs. CoreWeave zufolge sorgen die DPUs in Multi-Tenant-Umgebungen für eine sicherere VPC-Isolation und Netzwerke mit niedriger Latenz. Außerdem übernehmen sie Netzwerkaufgaben von der CPU, sodass Rechenressourcen für KI- und GPU-lastige Workloads frei bleiben.
Die Instanzen verfügen zudem über mehr als 7 TB schnellen lokalen NVMe-Speicher. Laut CoreWeave ermöglicht das schnellen Zugriff auf große Modelle, Datensätze und Assets und senkt die Latenz beim Datenabruf für Inferenz und grafikintensive Aufgaben.
Leistungsangaben im Vergleich zur L40S
Die RTX PRO 6000 Blackwell Server Edition wird als deutlicher Sprung gegenüber der vorherigen NVIDIA-Generation L40S präsentiert. CoreWeave nennt bis zu 5,6-mal schnellere LLM-Inferenz und 3,5-mal schnellere Text-zu-Video-Generierung. Zur aufgeführten Hardware zählen 96 GB GDDR7-Speicher mit 1,6 TB/s Bandbreite, Tensor Cores der fünften Generation für FP4-Präzision und RT Cores der vierten Generation.
- 3,8 PFLOPS FP4-KI-Leistung für agentische KI, LLM-Inferenz und generative Workflows
- Mehr als 5-fach höherer LLM-Inferenzdurchsatz im Vergleich zur L40S
- Mehr als doppelt so schnelles Fine-Tuning im Vergleich zur L40S
In einer Fußnote der Ankündigung heißt es, der Inferenzvergleich beruhe auf vorläufigen NVIDIA-Leistungsprognosen vom April 2025. Zugrunde liegen Llama3 70B bei 8K/256, 20 t/s/usr und 2 s FTL auf 8 GPUs, wobei die RTX PRO 6000 mit FP4 gegen die L40S mit FP8 antritt. Es handelt sich um Herstellerangaben, nicht um unabhängige Benchmarks.
In einem früheren CoreWeave-Beitrag, der die Instanzen als bald verfügbar ankündigte, war noch von bis zu 5,3-mal schnellerer LLM-Inferenz die Rede. Die Zahl hat sich also zwischen den beiden Ankündigungen geändert.
Plattform und Software-Integration
CoreWeave zufolge sind die Instanzen sowohl über den CoreWeave Kubernetes Service (CKS) als auch über Slurm on Kubernetes (SUNK) verfügbar, die zusammen die Orchestrierung containerisierter Anwendungen vereinfachen sollen. CoreWeave AI Object Storage (CAIOS) und der Local Object Transport Accelerator (LOTA) sind in die Instanzen integriert und sollen hohen Datendurchsatz und intelligentes Caching für groß angelegte Trainings- und Inferenz-Pipelines bieten.
Unterstützt werden die Instanzen außerdem von den Observability-Diensten von CoreWeave, die GPU-Auslastung, Systemfehler, Temperaturen und andere Logs detailliert überwachen, damit Kunden Probleme schnell erkennen und beheben können.
Das Unternehmen verweist auf frühere Arbeiten mit NVIDIA-HGX-H200- und NVIDIA-GB200-NVL72-Deployments als Beleg dafür, neue Rechenleistung schnell bereitzustellen. Außerdem führt SemiAnalysis CoreWeave nach eigenen Angaben als KI-Cloud Nr. 1, einschließlich des exklusiven Platinum-ClusterMAX-Ratings.
Was das für Kunden bedeutet
Kunden, die RTX-PRO-6000-Blackwell-Kapazität wünschen, können sie ab sofort bei CoreWeave in der Region US-EAST-04 anfragen. Laut Unternehmen können Firmen damit KI-Training beschleunigen, Latenzen senken und Deployments für KI- und Grafik-Workloads skalieren. Preise oder Details zu Kapazitäten in anderen Regionen nennt die Ankündigung nicht. Interessierte Kunden sollen sich für die Bereitstellung der Instanzen an CoreWeave wenden.