Databricks-Benchmark: Deklarative Spark-Pipelines senken die Rechenzeit von Agenten um das 34-Fache
Databricks sieht in Spark Declarative Pipelines (SDP) die bessere Wahl für KI-Agenten, die produktive Datenpipelines bauen. Im eigenen Benchmark benötigten deklarative Builds rund 34-mal weniger Rechenzeit und etwa 51 % weniger Code als prozedurales PySpark.
- Laut Databricks werden über 70 % der SDP-Pipelines auf der Plattform inzwischen von Agenten erstellt.
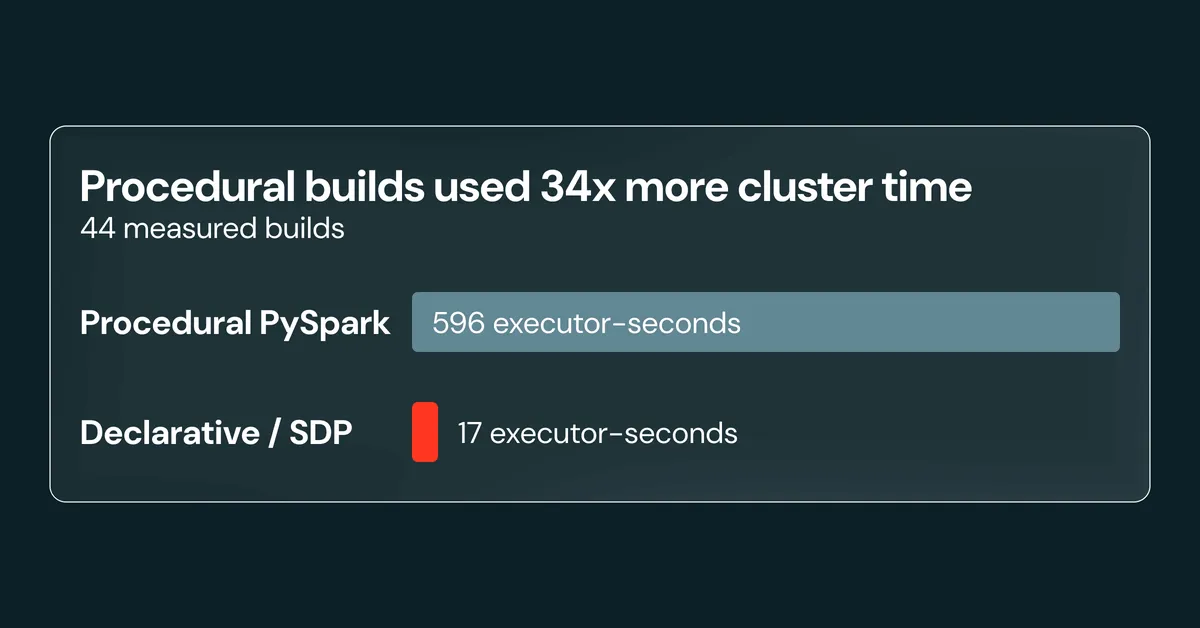
- Im Benchmark mit 528 Builds und Opus 4.8 verbrauchten prozedurale Läufe 596 Executor-Sekunden, deklarative nur 17, also rund das 34-Fache.
- Deklarative Pipelines hatten im Median 64 Zeilen gegenüber 131 bei prozeduralen, etwa 51 % weniger.
- Stille Logikfehler lagen in ähnlicher Größenordnung: 27,7 % bei prozeduralen und 32,2 % bei deklarativen Builds.
- Deklarative Builds kosten etwa das 2,3-Fache an LLM-Tokens, im Median rund 0,50 gegenüber 0,26 US-Dollar.
Warum von Agenten geschriebene Pipelines die Anforderungen erhöhen
Laut Databricks werden inzwischen über 70 % der SDP-Pipelines auf der Plattform von Agenten erstellt. Das Unternehmen sieht dadurch zwei Punkte unter Druck: Jeder Versuch eines Agenten kostet Rechenleistung und Zeit, Iterationen müssen also günstig sein. Zudem wird das Code-Review zum entscheidenden Kontrollpunkt, weshalb der Code knapp, lesbar und korrekt sein muss.
Apache Spark kennt zwei Programmiermodelle. Eine prozedurale Pipeline gibt Spark Schritt für Schritt vor, wie jeder Datensatz aufzubauen ist, und ob sie funktioniert, zeigt sich nur durch Ausführen. Eine deklarative Pipeline beschreibt dagegen die gewünschten Datensätze und überlässt Spark die Entscheidung, wie sie erzeugt werden. Databricks vergleicht das mit dem Prompting eines LLM, das den Lösungsweg selbst findet.
Eine deklarative Pipeline lasse sich vor der Ausführung auf strukturelle Fehler prüfen, ähnlich den Prüfungen zur Kompilierzeit in einer typisierten Sprache wie Rust, so das Unternehmen. Spaltenverweise werden gegen das Schema des gelesenen Datensatzes aufgelöst, Abhängigkeiten zwischen Datensätzen werden einem Erzeuger im Graphen zugeordnet, und der Graph wird auf Vollständigkeit und Reihenfolge geprüft. Spark übernimmt außerdem die Ausführungsreihenfolge und das Speichern der Ergebnisse, sodass der Agent weniger Boilerplate-Code schreiben muss.
So lief der Benchmark ab
Databricks testete 22 Data-Engineering-Aufgaben, die jeweils wie ein echtes Ticket formuliert waren und Tabelle, Spaltennamen und Datentypen der zu erzeugenden Pipeline festlegten. Für jede Aufgabe erzeugte das Unternehmen 12 Eingabedatensätze mit unsauberen Werten, wie sie in Produktionsdaten vorkommen. Der Agent baute für jeden Datensatz eine Pipeline mit prozeduralem PySpark und eine mit SDP, das ergibt 264 Builds pro Ansatz und insgesamt 528. Alle Builds liefen mit Opus 4.8.
Ein automatisierter Grader, der nicht wusste, welcher Ansatz ein Ergebnis hervorgebracht hatte, prüfte jede Ausgabe. Deklarative Pipelines durchliefen zunächst den Dry Run von Spark, und der Agent durfte einen fehlgeschlagenen Build bis zu einer festen Obergrenze überarbeiten. Setup, Prompts, Datensätze, Grader und Ergebnisse sind laut Databricks in einem öffentlichen Repository verfügbar.
Beide Ansätze schlossen nahezu jede Aufgabe ab: prozedural 255 von 264, deklarativ 258 von 264.
Ergebnisse: weniger Rechenzeit, weniger Code
Prozedurale Pipelines fingen vor der Ausführung keine Fehler ab, da sie keine Phase vor der Ausführung haben. Über alle gemessenen Builds hinweg verbrauchten prozedurale Läufe 596 Executor-Sekunden, deklarative nur 17. Den Unterschied um etwa das 34-Fache führt Databricks auf den Dry Run zurück, der strukturelle Fehler früh erkannte. Bei den deklarativen Läufen wurden 55 von 264 Builds gestoppt, bevor überhaupt eine Ausgabe entstand.
Auch die Codemenge unterschied sich. Bei den abgeschlossenen Builds hatten deklarative Pipelines im Median 64 Zeilen, prozedurale 131, was laut Databricks rund 51 % weniger Zeilen entspricht. Der prozedurale Code streute zudem stärker: 19 prozedurale Builds luden Daten in den Arbeitsspeicher und verarbeiteten sie zeilenweise, eine Abkürzung, die mit Testdaten funktioniert, aber bei wachsenden Datenmengen scheitern kann. Bei keinem der deklarativen Builds kam das vor.
Einschränkungen und Zielkonflikte
Databricks nennt zwei Einschränkungen. Erstens erkennt ein Dry Run nur strukturelle Fehler, nicht stille Fehler, bei denen eine Pipeline sauber durchläuft und ein falsches Ergebnis liefert. Stille Fehler traten bei 73 von 264 prozeduralen Builds (27,7 %) und bei 85 von 264 deklarativen Builds (32,2 %) auf. Die Raten lägen laut Unternehmen innerhalb von etwa 15 % beieinander, was zu wenig sei, um von einem echten Unterschied zu sprechen. Die Logik brauche weiterhin Tests und Reviews.
Zweitens verursachen deklarative Builds höhere Kosten bei den LLM-Tokens, etwa das 2,3-Fache. Databricks beziffert den mittleren Build auf rund 0,50 US-Dollar bei deklarativem gegenüber 0,26 US-Dollar bei prozeduralem Vorgehen, jeweils zu den Listenpreisen von Opus 4.8, wie in der Vergleichstabelle des Unternehmens angegeben. Der Agent iteriert am Dry Run, bis die Pipeline stimmig ist, was mehr Arbeit im Vorfeld bedeutet.
Was das für Teams bedeutet
Databricks argumentiert, die Token-Kosten seien eine einmalige, feste Ausgabe beim Schreiben der Pipeline, während verschwendete Cluster-Rechenleistung bei jedem fehlerhaften Lauf erneut anfalle und mit der Datenmenge wachse. Daraus schließt das Unternehmen, dass der deklarative Ansatz im Produktionsmaßstab im Vorteil ist und mit wachsenden Pipelines und Datenmengen wirtschaftlicher wird. Die Zahlen stammen aus einem Benchmark von Databricks selbst, der ein einziges Agentenmodell auf 22 Aufgaben prüft. Teams sollten das öffentliche Setup daher mit ihren eigenen Workloads erneut durchlaufen lassen.
Databricks: Built for Agents: The Case for Spark Declarative Pipelines