Daytona testet KI-Agenten unter Linux, macOS und Windows
Daytona hat eine Umgebung für bestärkendes Lernen vorgestellt, die KI-Agenten über eine einzige API unter Linux, macOS und Windows testet. Die Aufgabe Fleet Migration zeigte, dass beide DeepSeek-Modelle mit Windows zu kämpfen hatten. Damit werden Schwächen sichtbar, die Linux-exklusive Benchmarks übersehen können.
- Daytonas Aufgabe Fleet Migration erstreckt sich über Linux, macOS und Windows.
- Agenten müssen Clients für gzip-Komprimierung und API-Ratenbegrenzung aktualisieren.
- DeepSeek Pro war in 77% der Durchläufe erfolgreich, DeepSeek Flash in 42%.
- Jeder beobachtete Fehlschlag betraf die Windows-Umgebung.
- OpenEnv stellt die Schnittstelle für Training und Bewertung bereit.
Eine Aufgabe für drei Betriebssysteme
Die meisten Benchmarks für Coding-Agenten laufen laut Daytona in Linux-Containern, weil diese kostengünstig, reproduzierbar und einfach auszuwerten sind. Das Unternehmen argumentiert, dass dieses Setup viele Workflows in Unternehmen nicht abbildet. Dort arbeiten Teams möglicherweise mit unterschiedlichen Betriebssystemen, Shells, Schedulern und Ausführungsumgebungen.
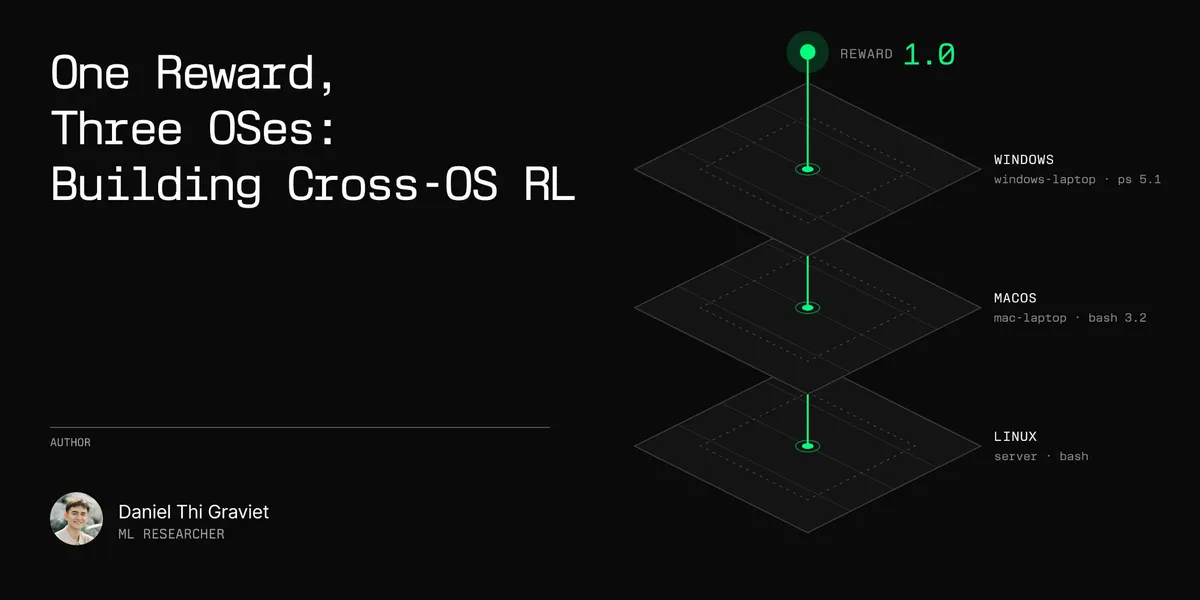
Daytonas Umgebung Fleet Migration stellt einem Agenten ein einziges Problem auf drei Maschinen: einem Linux-Server, einem macOS-Laptop und einem Windows-Laptop. Auf dem Server läuft eine aktualisierte Check-in-API, während beide Laptops veraltete Clients verwenden. Der Agent muss die Clients aktualisieren, damit die Flotte ohne Verlust ihrer bisherigen Check-in-Historie weiter funktioniert.
Für jede Episode werden drei unabhängige Daytona-Sandboxen eingerichtet. Der Agent kann sie mit exec, read_file und write_file untersuchen und ändern. Dafür stehen 60 Operationen zur Verfügung.
Derselbe API-Vertrag erfordert unterschiedliche Lösungen
Die API des Servers führt zwei inkompatible Änderungen ein. Anfragen müssen die gzip-Komprimierung mit Content-Encoding: gzip verwenden. Außerdem erhalten Geräte, die innerhalb von 15 Sekunden mehr als zwei Check-ins durchführen, den HTTP-Status 429 mit einem Retry-After-Header.
Der macOS-Client läuft in Bash 3.2 und wird über launchd als root gestartet. Da Bash-Variablen beliebige Binärdaten nicht sicher speichern können, muss der Agent die Anfrage in eine temporäre Datei schreiben, sie mit gzip komprimieren und mit curl --data-binary senden.
Der Windows-Client läuft in PowerShell 5.1 und wird vom Windows Task Scheduler als SYSTEM gestartet. Da diese Umgebung keinen entsprechenden integrierten gzip-Befehl bietet, muss der Agent .NETs System.IO.Compression.GZipStream verwenden und die komprimierten Bytes an Invoke-RestMethod übergeben.
Daytona hat Fleet Migration in OpenEnv integriert, das eine standardisierte Schnittstelle für das Training und die Bewertung von Agenten bereitstellt. Bei der Abgabe startet der Grader jeden Laptop über dessen nativen Scheduler, statt lediglich zu prüfen, ob die Skripte bei manueller Ausführung funktionieren.
Windows legte die größte Schwäche offen
Daytona bewertete DeepSeek Pro und DeepSeek Flash in 25 Durchläufen und nutzte OpenRouter, um beide Modelle bereitzustellen. DeepSeek Pro reparierte die Flotte in 10 von 13 Versuchen, also in 77% der Fälle. DeepSeek Flash war in 5 von 12 Versuchen erfolgreich, also in 42% der Fälle.
Laut Daytona betraf jeder beobachtete Fehlschlag Windows. Keines der beiden Modelle scheiterte auf dem Linux-Server oder dem macOS-Laptop. DeepSeek Flash versuchte häufig, Unix-Befehle in PowerShell zu verwenden, oder hatte Schwierigkeiten mit Windows-spezifischen gzip-APIs. In vier Durchläufen schöpfte das Modell sein Operationslimit aus, ohne eine Lösung abzugeben. Weitere Fehlschläge entstanden, weil das Windows-Skript manuell überprüft wurde, statt zu bestätigen, dass es über den Task Scheduler unter dem SYSTEM-Konto funktionierte.
Der Unterschied zeigte sich auch bei der Tool-Nutzung. DeepSeek Flash verwendete pro Durchlauf etwa 222.000 Prompt-Tokens und 34 exec-Aufrufe. Bei DeepSeek Pro waren es dagegen etwa 53.000 Prompt-Tokens und 10 exec-Aufrufe. Daytona wertet die Ergebnisse als Beleg dafür, dass Betriebssystem-übergreifende Umgebungen sowohl die Fähigkeit eines Agenten testen können, eine Änderung zu verstehen, als auch seine Fähigkeit, diese unter realistischen Einschränkungen des Betriebssystems umzusetzen und zu überprüfen.
Daytona: One Reward, Three OSes: Building Cross-OS RL