Snorkel AI verbessert Qwen3.8-27B bei anspruchsvollen Profi-Aufgaben
Snorkel AI zufolge hat das Unternehmen den pass@1-Wert von Qwen3.8-27B im GDPval-Benchmark von OpenAI von 31,9 auf 40,7 Prozent gesteigert. Möglich wurde dies durch die Kombination von Expertendaten mit einer modifizierten Methode des bestärkenden Lernens. Die Arbeit zielt auf KI-Agenten, die professionelle Ergebnisse erstellen, statt lediglich Fragen zu beantworten.
- Qwen3.8-27B erreichte im GDPval-Gold-Datensatz von OpenAI pass@1 von 40,7 Prozent.
- Das pass@1-Ergebnis des Basismodells lag bei 31,9 Prozent.
- Das binär gesteuerte GRPO nutzte rund 102.000 Trainings-Rollouts.
- Die Leistung im Expertenvergleich stieg von 36,4 auf 44,0 Prozent.
- Der Anteil erschöpfter Antwortbudgets sank von 17,2 auf 7,0 Prozent.
Agenten für professionelle Aufgaben trainieren
Snorkel AI trainierte Qwen3.8-27B mit 1.105 professionellen Aufgaben aus seiner GDPval+-Reihe und nutzte dafür rund 102.000 Trainings-Rollouts. Im Gold-Datensatz von OpenAIs GDPval erreichte das Modell pass@1 von 40,7 Prozent, verglichen mit 31,9 Prozent beim Basismodell.
GDPval bewertet Aufgaben von erfahrenen Fachleuten aus neun Wirtschaftssektoren der USA. Jede Aufgabe endet mit einem Ergebnis, etwa einem Finanzmodell, einer behördlichen Einreichung oder einer Präsentation, die aus Quelldokumenten erstellt wurde. Zu den Aufgaben gehören ein von Menschen erstelltes Referenzergebnis und ein detailliertes Bewertungsschema, das beschreibt, was ein vollständiges Ergebnis enthalten muss.
Snorkel AI zufolge umfasste ein einzelner Versuch im Durchschnitt etwa 50.000 Antwort-Token und konnte zahlreiche Tool-Aufrufe beinhalten. Bei der Bewertung gilt ein Versuch als bestanden, wenn er mindestens 90 Prozent der Kriterien des Bewertungsschemas erfüllt. Das Unternehmen verwendet diesen Schwellenwert, weil LLM-Bewerter bei der Bewertung einzelner Kriterien uneinheitliche Ergebnisse liefern können.
Warum herkömmliches GRPO oft ins Stocken gerät
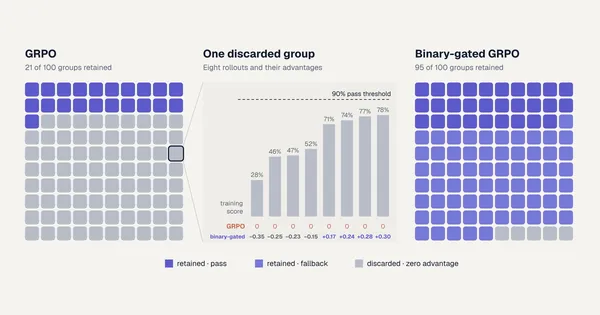
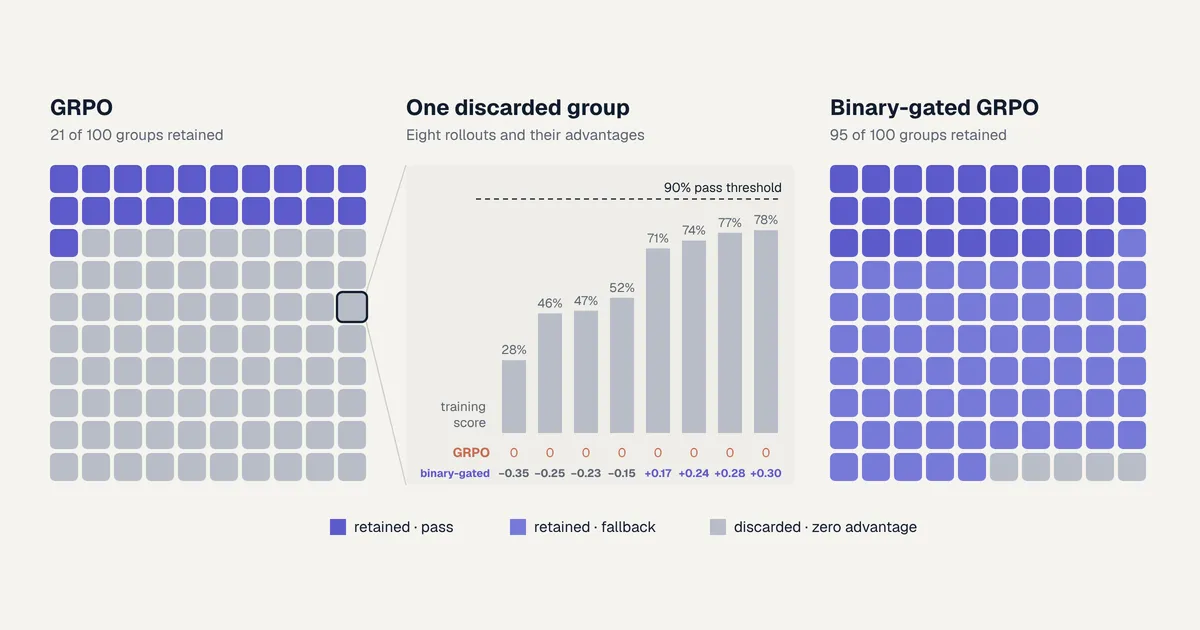
Die Trainingsmethode namens binär gesteuertes GRPO ist für Aufgaben konzipiert, bei denen erfolgreiche Versuche selten sind. Standard-GRPO erzeugt für jede Aufgabe acht Rollouts und vergleicht jedes Ergebnis mit dem Gruppenmittelwert. Wenn alle Rollouts scheitern, erhalten sie den Rückgabewert null, sodass der Gruppe kein Lernsignal zur Verfügung steht.
In den Durchläufen von Snorkel AI enthielten 79 Prozent der erzeugten Gruppen keinen erfolgreichen Rollout. Das Unternehmen betont, dass die verworfenen Gruppen nicht durchweg schlecht waren: In der mittleren verworfenen Gruppe erreichte der beste Rollout einen Trainingswert von 78 Prozent, und 66 Prozent der verworfenen Gruppen enthielten einen Rollout mit mindestens 70 Prozent.
Das binär gesteuerte GRPO behält das normale Bestanden-oder-durchgefallen-Signal bei, wenn eine Gruppe mindestens einen erfolgreichen Versuch enthält. Scheitern alle Versuche, verwendet es einen Ersatz-Trainingswert. Dieser berücksichtigt, wie viele Kriterien des Bewertungsschemas das Ergebnis erfüllt und ob seine wichtigsten Resultate und Schlussfolgerungen mit der Expertenreferenz übereinstimmen. Werte von höchstens 40 Prozent erhalten keine Ersatzgutschrift, während höhere Werte auf den Bestehensschwellenwert von 90 Prozent hochskaliert werden.
Mit diesem Ansatz enthielten 95 Prozent der erzeugten Gruppen ein Trainingssignal, verglichen mit 21 Prozent bei GRPO. Snorkel AI zufolge blieb das mit denselben Daten und einer ähnlichen Anzahl von Rollouts trainierte Standard-GRPO nahe am Basismodell.
Die Verbesserungen gingen über den Hauptwert hinaus
In direkten, von LLMs bewerteten Vergleichen wurden die Ergebnisse des trainierten Modells in 44,0 Prozent der Versuche höher bewertet als jene menschlicher Experten. Beim Basismodell waren es 36,4 Prozent. Zählt man Unentschieden hinzu, erreichte das trainierte Modell in 47,6 Prozent der Versuche mindestens das Ergebnis des Experten.
Snorkel AI berichtet, dass das binär gesteuerte GRPO das Basismodell in allen neun GDPval-Sektoren beim Bestehen nach dem Bewertungsschema und in acht von neun Sektoren beim Expertenvergleich übertraf. Die Verbesserung zeigte sich bei beiden Schwellenwerten des Bewertungsschemas sowie beim Expertenvergleich für pass@1 und pass@8. Bei pass@8 gilt eine Aufgabe als gelöst, wenn einer von acht Versuchen erfolgreich ist.
Dem Modell ging außerdem seltener das Antwortbudget aus. Dieser Anteil sank von 17,2 auf 7,0 Prozent, während er bei jeder Bewertung mit Standard-GRPO über 11 Prozent blieb. Bei einer Begrenzung auf 64.000 Token, also etwa der Hälfte des vollständigen Budgets, erreichte das trainierte Modell bereits die Erfolgsrate des Basismodells mit vollem Budget.
Für Nutzer und Entwickler, die Agenten für professionelle Arbeitsabläufe entwickeln, deuten die Ergebnisse darauf hin, dass Trainingsmethoden Teilergebnisse nützlicher machen können, wenn erfolgreiche Abschlüsse selten sind. Die Erkenntnisse von Snorkel AI beschränken sich auf die berichteten Experimente mit Qwen3.8-27B und die GDPval-Bewertungen. Sie weisen jedoch auf einen praktischen Schwerpunkt bei der Agentenentwicklung hin: Systeme darin zu trainieren, komplexe, anhand eines Bewertungsschemas beurteilte Aufgaben abzuschließen und zugleich zwischen einem fertigen Ergebnis und teilweisem Fortschritt zu unterscheiden.
Snorkel AI: Training agents for professional work when success is rare