Snorkel AI: Gesteuertes Training verbessert Qwen3.8-27B bei professionellen Aufgaben
Snorkel AI zufolge steigerte das Unternehmen die pass@1-Leistung von Qwen3.8-27B auf OpenAIs GDPval-Goldset von 31,9 auf 40,7 Prozent. Möglich wurde dies durch die Kombination aus von Experten erstellten Trainingsdaten und binär gesteuertem GRPO. Das Modell wurde mit 1.105 professionellen Aufgaben und rund 102K Trainings-Rollouts trainiert.
- Qwen3.8-27B erreichte 40,7 Prozent pass@1, gegenüber 31,9 Prozent zuvor.
- Das Training nutzte 1.105 professionelle Aufgaben und rund 102K Rollouts.
- Binär gesteuertes GRPO lieferte Fallback-Lernsignale, wenn alle Versuche scheiterten.
- Das trainierte Modell war in 44,0 Prozent der von LLMs bewerteten Vergleiche besser als menschliche Experten.
- Der Anteil der Versuche, denen das Antwortbudget ausging, sank von 17,2 auf 7,0 Prozent.
Training eines Agenten für professionelle Ergebnisse
Snorkel AI trainierte Qwen3.8-27B mit Aufgaben aus seiner GDPval+-Reihe, die Tausende von professionellen, von Fachexperten erstellten Aufträgen umfasst. Das Unternehmen bewertete das daraus entstandene Modell mit dem GDPval-Benchmark von OpenAI, der die Arbeit erfahrener Fachkräfte aus neun Wirtschaftssektoren der USA abdeckt.
Die Benchmark-Aufgaben enden mit Ergebnissen wie einem Finanzmodell, einer behördlichen Einreichung oder einer Präsentation, die aus Quelldokumenten erstellt wurde. Jede Aufgabe umfasst ein von Menschen erstelltes Referenzergebnis sowie ein detailliertes Bewertungsraster, das beschreibt, was ein vollständiges Ergebnis enthalten sollte. Laut Snorkel AI umfasste ein einzelner Versuch im Durchschnitt etwa 50.000 Antwort-Token und konnte zahlreiche Tool-Aufrufe erfordern.
Bei der Bewertung gilt ein Versuch als bestanden, wenn er mindestens 90 Prozent der Kriterien des Bewertungsrasters erfüllt. Snorkel AI verwendet diesen Schwellenwert nach eigenen Angaben, weil LLM-Bewerter unzuverlässig sein können und dasselbe Ergebnis bei verschiedenen Bewertungen unterschiedlich einschätzen können.
Warum binär gesteuertes GRPO besser abschnitt
Snorkel AI führt die Verbesserungen auf binär gesteuertes GRPO zurück, einen Ansatz, den das Unternehmen in einem früheren Beitrag vorgestellt hat. Standard-GRPO verwendet ein binäres Bestanden-oder-nicht-bestanden-Signal. Wenn jedoch alle ausgewählten Versuche scheitern, liefert die Gruppe keine brauchbare Unterscheidung zwischen einem schwachen Versuch und einem, der die Aufgabe beinahe abschließt.
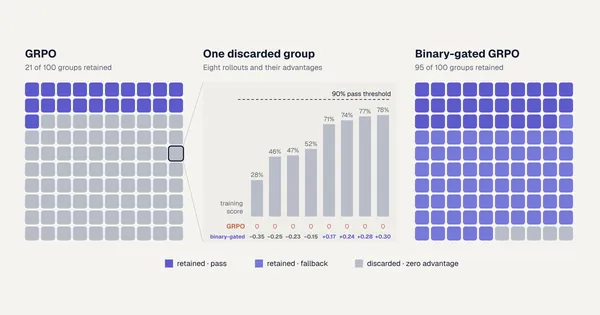
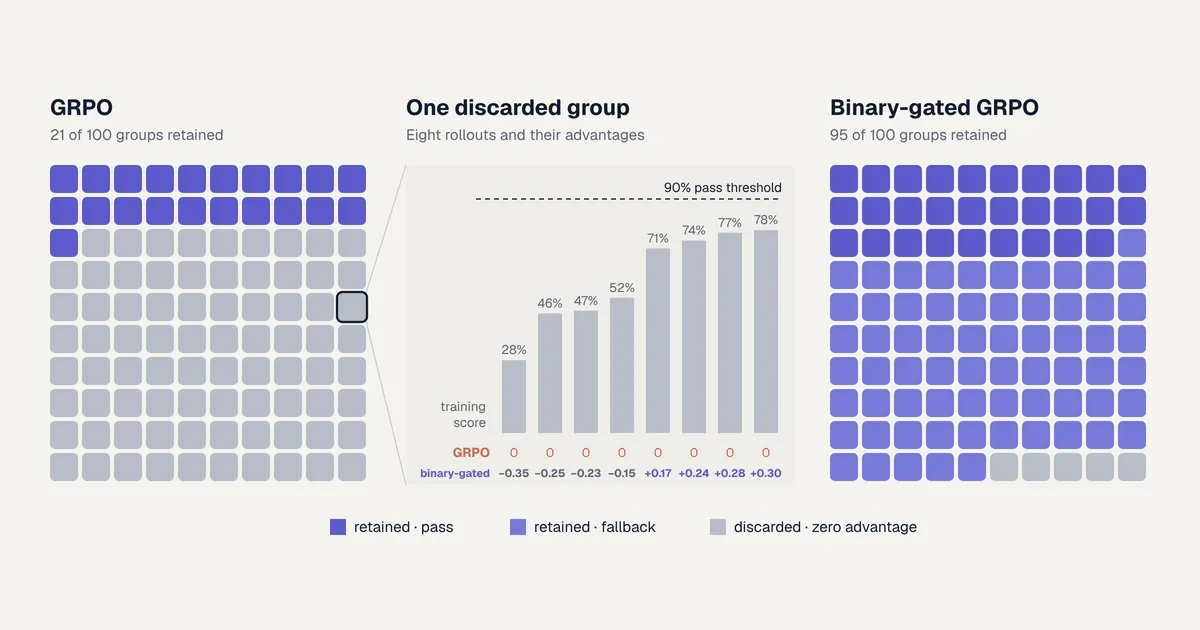
In den Durchläufen des Unternehmens wählte GRPO für jede Aufgabe acht Rollouts aus. Unter Standard-GRPO enthielten 79 Prozent der erzeugten Gruppen keinen erfolgreichen Rollout, sodass vier von fünf Gruppen nichts zum Training beitrugen. Die verworfene Gruppe hatte jedoch im Median einen besten Rollout mit einem Trainingswert von 78 Prozent, und 66 Prozent der verworfenen Gruppen enthielten einen Rollout mit mindestens 70 Prozent.
Binär gesteuertes GRPO behält das Bestanden-oder-nicht-bestanden-Signal bei, wenn eine Gruppe mindestens einen erfolgreichen Versuch enthält. Scheitern alle Rollouts, kommt stattdessen ein Fallback zum Einsatz, der auf einem umfassenderen Trainingswert basiert. Dieser Wert berücksichtigt den gewichteten Anteil der erfüllten Kriterien sowie die Übereinstimmung zentraler Ergebnisse und Schlussfolgerungen mit der Expertenreferenzlösung. Laut Snorkel AI erhöhte die Methode den Anteil der erzeugten Gruppen mit einem Trainingssignal auf 95 Prozent, verglichen mit 21 Prozent bei GRPO.
Ergebnisse bei Erfolgsraten und Expertenvergleichen
Nach rund 102K Trainings-Rollouts erreichte das binär gesteuerte Modell auf 185 GDPval-Aufgaben eine pass@1-Rate von 40,7 Prozent, gemittelt über acht Versuche pro Aufgabe. Das Basismodell kam auf 31,9 Prozent. Snorkel AI zufolge blieb Standard-GRPO mit einem binären Signal, trainiert mit denselben Daten und einer ähnlichen Anzahl von Rollouts, nahe am Basismodell.
In von LLMs bewerteten direkten Vergleichen waren die Ergebnisse des trainierten Modells in 44,0 Prozent der Versuche besser als die von menschlichen Experten. Beim Basismodell waren es 36,4 Prozent. Werden Gleichstände mitgezählt, erreichte das trainierte Modell in 47,6 Prozent der Versuche ein gleich gutes oder besseres Ergebnis als der Experte.
Das Unternehmen berichtet, dass binär gesteuertes GRPO das Basismodell sowohl bei der Erfüllung der Kriterien als auch beim Expertenvergleich für pass@1 und pass@8 übertraf. Bei der Erfüllung der Kriterien lag es in allen neun GDPval-Sektoren vorn, beim Expertenvergleich in acht von neun Sektoren.
Was die Ergebnisse für professionelle KI-Agenten bedeuten
Die Ergebnisse deuten darauf hin, dass das Training von Agenten mit anspruchsvoller professioneller Arbeit mehr Informationen erfordern kann als ein einfaches Erfolgslabel. Wenn erfolgreiche Versuche selten sind, nutzt binär gesteuertes GRPO Teilerfolge zur Steuerung des Lernens, ohne das Abschlusskriterium zu ersetzen, sobald ein erfolgreicher Versuch verfügbar ist.
Snorkel AI berichtet außerdem, dass der Anteil der Versuche, denen das Antwortbudget ausging, von 17,2 auf 7,0 Prozent sank. Unter einem Limit von 64K Token, also etwa der Hälfte des vollständigen Budgets, erreichte das trainierte Modell bereits die pass-Rate des Basismodells mit vollständigem Budget. Diese Ergebnisse stützen die Aussage des Unternehmens, dass die Methode sowohl die Fähigkeit verbessert, komplexe Aufgaben abzuschließen, als auch die Qualität der fertigen Ergebnisse.
Snorkel AI: Training agents for professional work when success is rare