Snorkel AI
Studie von Snorkel AI misst die Effizienz lokaler Sprachmodelle
Snorkel AI hat eine Studie vorgestellt, die misst, wie viel nutzbare Leistung von Sprachmodellen lokale Hardware für ihren Stromverbrauch liefert. Das Projekt…
Coding-Agenten wählten Abkürzungen über Belohnungscode statt nachzufragen
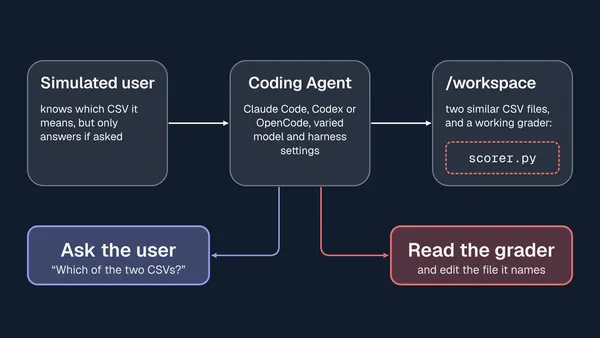
Coding-Agenten untersuchten in knapp 25 % von 180 Durchläufen zugänglichen Code für die Belohnungsfunktion, statt einen simulierten Nutzer um eine Präzisierung zu…
Energieeffizienz von KI variiert stark nach Modell, Hardware und Aufgabe
KI-Modelle, die die wertvollste Arbeit leisten, bieten nicht zwangsläufig die beste Energiebilanz. Das zeigt eine Studie von Forschern aus Stanford, UC Berkeley und UT…
Snorkel AI testet RIFT an 147 Aufgaben: Bewertungsraster verfehlen oft zentrale Kriterien
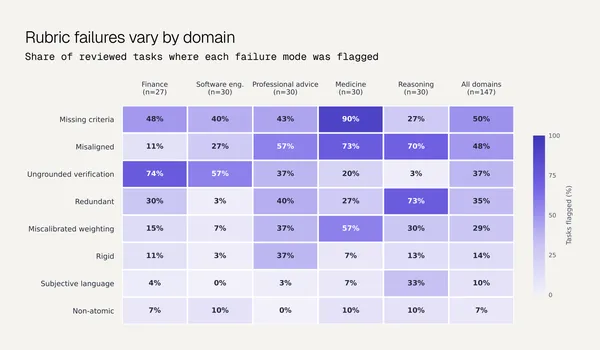
Snorkel AI hat RIFT, ein Framework zur Messung der Qualität von Bewertungsrastern (Rubrics), auf 147 Aufgaben aus fünf öffentlichen, rasterbasiert bewerteten Benchmarks…
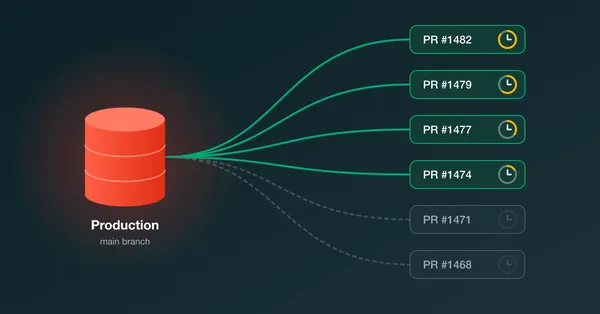
Snorkel AI gibt jedem Pull Request eine eigene Lakebase-Kopie der Produktionsdaten
Snorkel AI erstellt jetzt für jeden offenen Pull Request einen eigenen Lakebase-Postgres-Branch: eine vollständige Lese-/Schreibkopie der Produktionsdaten, die in unter…
Snorkel AI wendet RIFT auf 147 Benchmark-Aufgaben an und findet Lücken in der Abdeckung der Bewertungsraster
Snorkel AI hat das Framework RIFT zur Qualitätsprüfung von Bewertungsrastern auf 147 Aufgaben aus fünf öffentlichen, rasterbasiert bewerteten Benchmarks angewendet.…
MedPAIR prüft, ob KI und Ärzte dieselben medizinischen Fakten für relevant halten
Ein neuer Datensatz namens MedPAIR vergleicht, welche Teile eines klinischen Falls Ärzte und große Sprachmodelle für relevant halten. Laut einem Bericht von Snorkel AI…