Snorkel AI wendet RIFT auf 147 Benchmark-Aufgaben an und findet Lücken in der Abdeckung der Bewertungsraster
Snorkel AI hat das Framework RIFT zur Qualitätsprüfung von Bewertungsrastern auf 147 Aufgaben aus fünf öffentlichen, rasterbasiert bewerteten Benchmarks angewendet. Dabei traten fehlende Kriterien (50 % der Aufgaben) und fehlausgerichtete Kriterien (48 %) deutlich häufiger auf als gebündelte Anforderungen (7 %) oder subjektive Formulierungen (10 %).
- Snorkel AI wendete RIFT auf 147 Aufgaben aus fünf öffentlichen, rasterbasiert bewerteten Benchmarks aus Finanzen, Medizin, Softwareentwicklung, Fachberatung und logischem Schlussfolgern an.
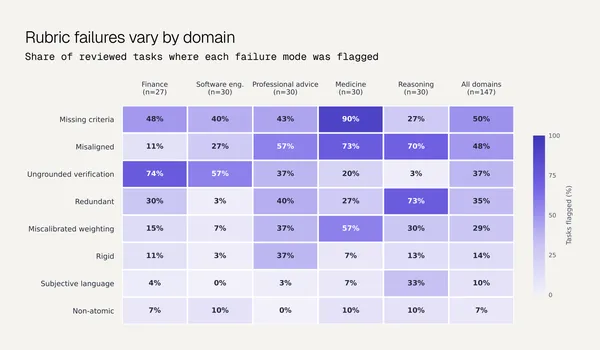
- Fehlende Kriterien traten bei 50 % der Aufgaben auf, fehlausgerichtete bei 48 %. Nicht atomare Kriterien (7 %) und subjektive Sprache (10 %) waren am seltensten.
- Fehlende Kriterien betrafen 90 % der medizinischen Aufgaben, nicht belegbare Überprüfung erreichte bei den Finanzen mit 74 % ihren Höchstwert.
- In einem Test mit eingebrachten Fehlern erkannten die RIFT-Signale den Fehlermodus mit 75,0 % Genauigkeit, ein LLM-Bewerter mit 56,7 %.
- Laut Snorkel sind Vergleiche zwischen den Bereichen bei rund 30 Aufgaben pro Bereich nur Anhaltspunkte.
Warum das Bewertungsraster selbst geprüft werden muss
Die rasterbasierte Bewertung ist ein gängiges Verfahren, um Sprachmodelle und Agenten zu benoten. Zudem liefern Raster Belohnungssignale im Training. Snorkel AI argumentiert, dass das Raster in beiden Fällen das Messinstrument ist. Die Aussagekraft eines Ergebnisses hänge also davon ab, wie gut das Raster abbildet, was die Aufgabe prüfen soll.
Laut dem Beitrag wird die Qualität von Rastern selten direkt untersucht. Meist wird sie aus der Übereinstimmung zwischen automatisierten Bewertern und menschlichen Gutachtern abgeleitet oder aus Verbesserungen bei Modellen, die mit rasterbasierten Belohnungen trainiert wurden. Snorkel merkt an, dass beide Maße das Raster mit dem Modell vermengen, das es anwendet. Ein Raster, das in sich stimmig und nachvollziehbar, aber an der Aufgabe vorbei ausgerichtet ist, lasse sich damit nicht erkennen.
Hier setzt RIFT (RubrIc Failure mode Taxonomy) an, beschrieben von Aich et al., 2026. Das Framework bewertet das Raster anhand zweier Dimensionen aus der Messtheorie: Reliabilität, also ob die Bewertung reproduzierbar ist, und Inhaltsvalidität, also ob die Bewertung die beabsichtigte Interpretation des Ergebnisses trägt.
So funktioniert RIFT
Das Framework besteht aus zwei Teilen. Der erste ist ein Satz von Qualitätssignalen, die aus dem Text des Rasters berechnet werden. Ein Gremium simulierter Experten beurteilt, ob jedes Kriterium wesentlich ist. Die Kriterien werden mit den Themen und Zielen der Aufgabe verglichen, um die Abdeckung zu messen. Außerdem wird geprüft, ob die wichtigsten Kriterien die höchste Punktzahl tragen.
Der zweite Teil ist eine Taxonomie aus neun Fehlermodi, die aus Expertenkritiken an 85 Rastern entwickelt wurde. Vier davon betreffen die Reliabilität: subjektive Sprache, nicht belegbare Überprüfung und nicht atomare Kriterien. Die übrigen betreffen die Inhaltsvalidität: fehlende Kriterien sowie fehlausgerichtete, starre, redundante, manipulierbare und falsch gewichtete Kriterien.
Snorkel berichtet von einem Validierungstest, bei dem jeder Fehlermodus in bekannter Stärke in 60 von Experten verfasste Raster eingebracht wurde. Ein multinomialer logistischer Klassifikator über die Veränderungen der Signale erkannte den eingebrachten Modus mit einer Genauigkeit von 75,0 % (Zufallsniveau 12,5 %), bei Leave-one-task-out-Kreuzvalidierung. Ein LLM-Bewerter, der dieselben Raster erhielt, kam auf 56,7 %.
Was die Untersuchung in fünf Bereichen ergab
Die Untersuchung umfasste je 27 bis 30 Aufgaben aus fünf Benchmarks: Finanzen, Medizin, Softwareentwicklung, Fachberatung und logisches Schlussfolgern. Die Manipulierbarkeit wird gesondert ausgewiesen, die Tabelle deckt daher acht Modi ab. Die zusammengefassten Raten lagen bei:
- Fehlende Kriterien: 50 %
- Fehlausgerichtet: 48 %
- Nicht belegbare Überprüfung: 37 %
- Redundant: 35 %
- Falsche Gewichtung: 29 %
- Starr: 14 %
- Subjektive Sprache: 10 %
- Nicht atomar: 7 %
Bei fehlenden Kriterien stach die Medizin mit 90 % der Aufgaben (27 von 30) hervor. Fehlausrichtung war in den urteilslastigen Bereichen am höchsten: 73 % in der Medizin, 70 % beim Schlussfolgern und 57 % in der Fachberatung, gegenüber 11 % bei den Finanzen. Bei der nicht belegbaren Überprüfung zeigte sich das umgekehrte Muster: Sie erreichte 74 % bei den Finanzen und 57 % in der Softwareentwicklung, aber nur 3 % beim Schlussfolgern.
Subjektive Sprache war nur beim Schlussfolgern ein Schwachpunkt (33 %), wo Aufgaben das Abwägen konkurrierender Gesichtspunkte verlangen. Snorkel nennt als Beispiel ein Kriterium, das fragt, ob eine Antwort "weighs the effect of following the therapist's advice", ohne zu sagen, welche Effekte gemeint sind.
Der Beitrag nennt zwei Einschränkungen. Bei rund 30 Aufgaben pro Bereich umfasst das 95-Prozent-Konfidenzintervall bei einer Rate um 50 % etwa plus/minus 18 Prozentpunkte. Vergleiche zwischen den Bereichen sind daher nur Anhaltspunkte, die zusammengefassten Werte über alle 147 Aufgaben sind belastbarer. Aufgaben, in denen ein Modus nur als geringfügiges Problem auftrat, werden nicht mitgezählt.
Was das für Verfasser von Rastern bedeutet
Snorkel deutet die niedrigen Raten bei Bündelung und subjektiver Formulierung als Zeichen dafür, dass Verfasser besser darin werden, jeweils ein Kriterium einzeln zu bewerten. Zudem scheinen Raster für überprüfbare oder objektive Aufgaben zunehmend objektiver zu werden.
Die größeren Probleme liegen darin, ob Raster die Aufgabenstellung abdecken, das richtige Ziel bewerten und auf prüfbare Quellen verweisen. Laut Snorkel machen die Qualitätssignale und die Taxonomie diese Mängel messbar und geben Verfassern ein gemeinsames Vokabular, um darüber zu sprechen. Ziel sei es, die Praxis beim Erstellen von Rastern zu verbessern. Vollständige Definitionen, Entscheidungsregeln und Beispiele stehen im RIFT-Paper.
Snorkel AI: Checking the Rubrics: RIFT Results on Five Public Benchmarks