Studie von Snorkel AI misst die Effizienz lokaler Sprachmodelle
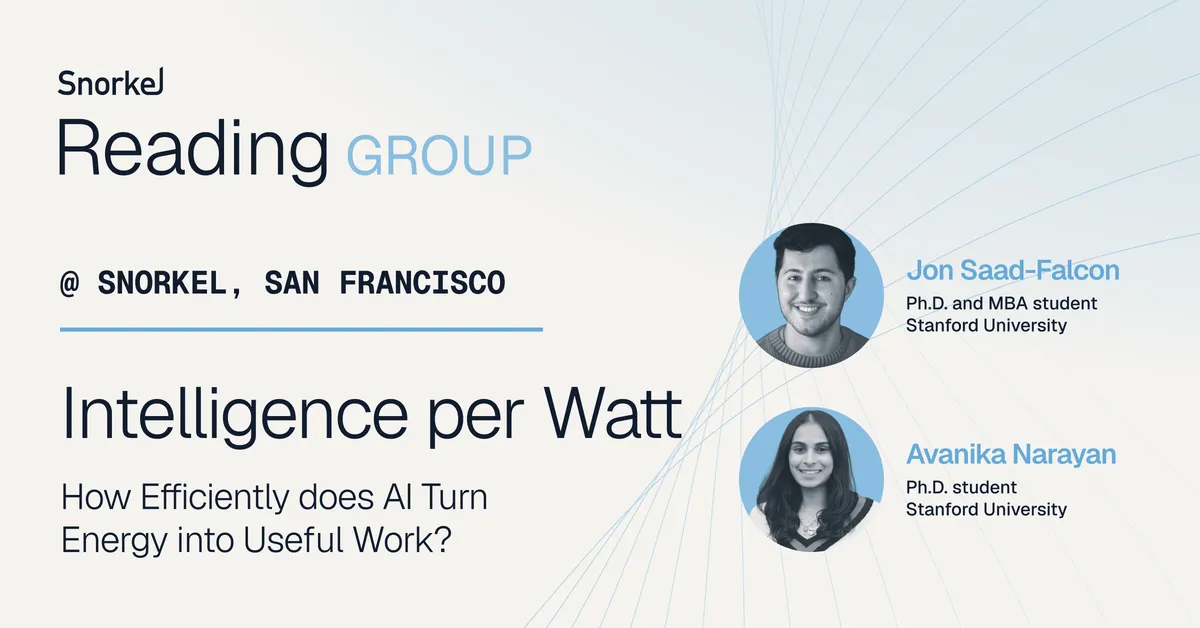
Snorkel AI hat eine Studie vorgestellt, die misst, wie viel nutzbare Leistung von Sprachmodellen lokale Hardware für ihren Stromverbrauch liefert. Das Projekt Intelligence per Watt untersucht mehr als 20 lokale Modelle anhand von 1 Million realen Chat- und Reasoning-Anfragen.
- Intelligence per Watt setzt die Aufgabengenauigkeit ins Verhältnis zur Leistungsaufnahme.
- Die Studie testete mehr als 20 lokale Modelle anhand von über 1 Million Anfragen.
- Die Genauigkeit lokaler Modelle stieg von 2023 bis 2025 um das 3-Fache.
- Intelligence per Joule verbesserte sich über 16 Monate um das 18-Fache.
- Snorkel AI erwartet zunehmend hybride Inferenz mit lokalen und Cloud-Modellen.
Eine Kennzahl für die Effizienz lokaler KI
Die von Jon Saad-Falcon und Avanika Narayan von der Stanford University und Hazy Research bei einer Snorkel-AI-Reading-Group vorgestellte Studie führt Intelligence per Watt beziehungsweise IPW ein. Die Kennzahl setzt die Aufgabengenauigkeit ins Verhältnis zur Leistungsaufnahme und ermöglicht es Forschern, Modelle und Hardware sowohl anhand ihrer Fähigkeiten als auch ihrer Energieeffizienz zu vergleichen.
Snorkel AI zufolge soll das Projekt untersuchen, wie viel der Inferenzlast von Rechenzentren auf Laptops, Workstations und andere lokale Geräte verlagert werden könnte. Die Forscher konzentrieren sich auf Chat-, Reasoning-, agentische und Coding-Aufgaben und messen neben der Genauigkeit auch Energieverbrauch, Latenz und die für den Betrieb jedes Modells erforderliche Rechenleistung.
Motiviert ist das Projekt durch die rasch steigende Nachfrage nach Inferenz. Der Quelle zufolge zeigte Google auf seiner jüngsten I/O-Konferenz, dass die Nachfrage gegenüber dem Vorjahr um mehr als das Zehnfache gestiegen ist. Außerdem heißt es, dass etwa 77 % dieser Nachfrage praktische, informationsorientierte Aufgaben betrifft, die von kleineren oder lokalen Modellen bewältigt werden können.
Modelle, Hardware und gemessene Workloads
Die Untersuchung umfasste mehr als 20 lokale Sprachmodelle aus den Modellfamilien Qwen, GPT-OSS, Gemma und IBM Granite. Darunter waren sowohl dichte Modelle als auch Mixture-of-Experts-Systeme mit 1 Milliarde bis 200 Milliarden Parametern.
Die Forscher testeten die Modelle auf 10 lokalen Beschleunigern aus den Jahren 2023 bis 2025. Die Hardware stammte von Nvidia, AMD, SambaNova und Apple. Zu den Workloads gehörten ChatGPT-ähnliche Unterhaltungen, allgemeines Reasoning und standardisierte Benchmarks für professionelle Aufgaben wie SuperGPQA und MMLU-Pro.
Die Studie betrachtet außerdem mehr als die reine Genauigkeit. Zu den Messgrößen zählen Energieverbrauch, Latenz und Leistung. Damit lassen sich die Zielkonflikte beim lokalen Betrieb von KI vergleichen, anstatt jede Anfrage an ein Rechenzentrum zu senden.
Genauigkeit und Effizienz legten rasch zu
Der Studie zufolge erzielten lokale Sprachmodelle von 2023 bis 2025 eine dreimal höhere Genauigkeit. Die Intelligenzeffizienz, definiert als die pro Watt bereitgestellte Leistung, stieg pro Jahr um etwa das 2,3-Fache beziehungsweise über den Zeitraum von zwei Jahren um das 5,3-Fache. Snorkel AI zufolge war dafür vor allem die Verbesserung der Sprachmodelle und nicht der Hardware verantwortlich.
Gemessen als Intelligence per Joule, also als pro Energieeinheit bereitgestellte Leistung, erreichte die Verbesserung über 16 Monate das 18-Fache. In diesem Fall war der Quelle zufolge die Hardware der wichtigste Treiber. Mehr Speicher und Rechenleistung, Formate mit gemischter Präzision wie FP4 sowie mit Apple und Nvidia verbundene Speichertechniken halfen dabei, größere lokale Deployments zu ermöglichen.
Als Beispiele für Hardware, die zuvor nicht mögliche Deployments ermöglicht, nennt die Quelle die DGX-Spark-Serie, Mac minis und den M5 Pro. Lokale Beschleuniger liegen jedoch weiterhin hinter Enterprise-Chips zurück, da sie üblicherweise einen Nutzer bedienen und mit kleineren Batch-Größen arbeiten als Cloud-Systeme.
Routing könnte hybride Deployments ermöglichen
Snorkel AI zufolge besteht eine praktische Möglichkeit, diese Fortschritte zu nutzen, darin, Anfragen zwischen lokalen und Cloud-Modellen weiterzuleiten. Ein Routing-System mit einer Genauigkeit von lediglich 80 % könnte den Energieverbrauch der Studie zufolge um etwa 80 %, den Rechenverbrauch um mehr als 77 % und die Kosten um mehr als 73 % senken.
In einem Vergleich zwischen einem Apple M4 Max und einem B200 lieferte der M4 Max etwa zwei- bis dreimal weniger Intelligenz pro Watt und pro Joule. Der Quelle zufolge schaffen spezialisierte Inferenzbeschleuniger wie SambaNovas SN40L einen größeren Abstand, insbesondere bei Intelligence per Joule.
Die Forscher beschreiben die wahrscheinliche Zukunft als „standardmäßig lokal, aber von Grund auf hybrid“, wobei die meisten Anfragen auf Laptops, Workstations oder On-Premises-Systemen verarbeitet werden. Die verbleibenden 5 % oder weniger, zu denen Frontier-Anfragen aus den Bereichen Coding, Mathematik und Wissenschaft gehören, würden an Rechenzentren gesendet. Snorkel AI gab außerdem einen Ausblick auf Joules to GDP, eine begleitende Studie, die den pro Joule erzeugten Dollarwert und die Expertenzeit für 220 Aufgaben in 44 Berufen misst.
Snorkel AI: Intelligence per Watt: Measuring Local AI Efficiency