Snorkel AI testet RIFT an 147 Aufgaben: Bewertungsraster verfehlen oft zentrale Kriterien
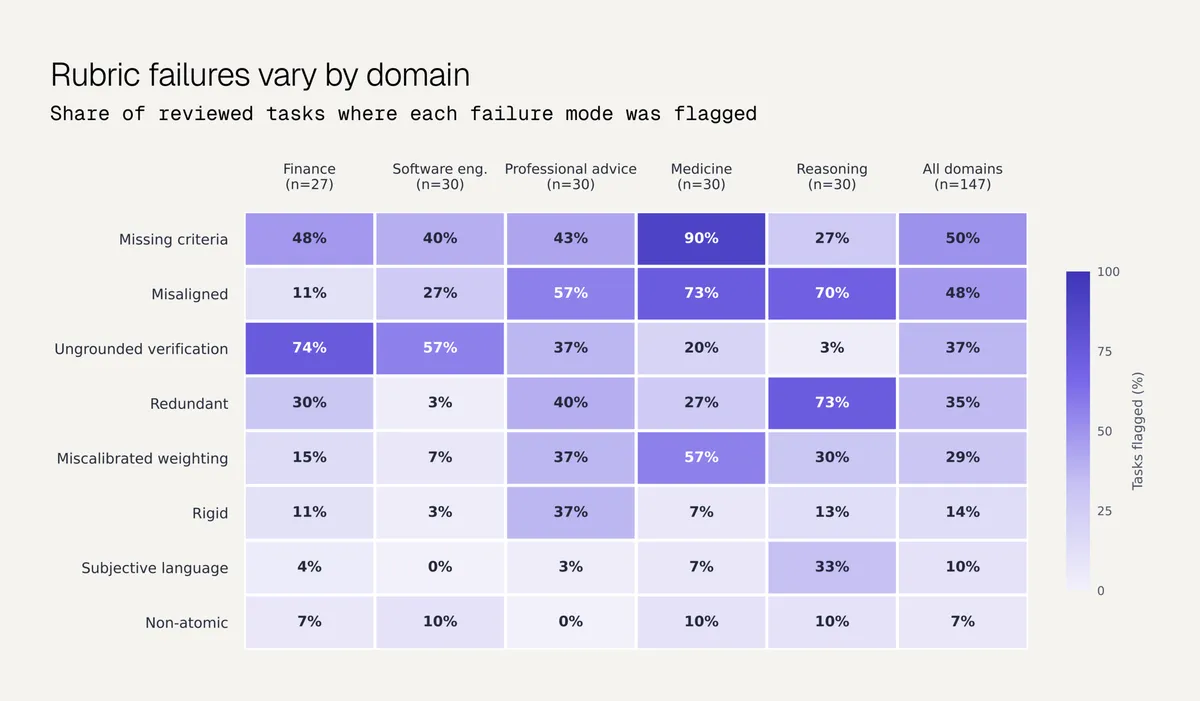
Snorkel AI hat RIFT, ein Framework zur Messung der Qualität von Bewertungsrastern (Rubrics), auf 147 Aufgaben aus fünf öffentlichen, rasterbasiert bewerteten Benchmarks angewendet. Laut dem Unternehmen fehlten in 50 Prozent der Aufgaben Kriterien, in 48 Prozent waren Kriterien nicht passend zur Aufgabe. Gebündelte Anforderungen und subjektive Formulierungen traten deutlich seltener auf.
- Snorkel AI hat sein Framework RIFT auf 147 Aufgaben aus fünf öffentlichen, rasterbasiert bewerteten Benchmarks angewendet.
- In 50 Prozent der Aufgaben fehlten Kriterien, in 48 Prozent waren sie unpassend, nicht atomare Kriterien traten in 7 Prozent auf.
- In der Medizin fehlten in 90 Prozent der Aufgaben Kriterien; nicht fundierte Überprüfung war bei Finanzen mit 74 Prozent am höchsten.
- In einem Test mit 60 Experten-Rubrics erkannten die RIFT-Signale eingefügte Defekte mit 75,0 Prozent Genauigkeit, ein LLM-Judge erreichte 56,7 Prozent.
- Snorkel weist darauf hin, dass pro Domäne nur rund 30 Aufgaben untersucht wurden, Vergleiche zwischen Domänen sind daher nur Hinweise.
Warum das Bewertungsraster selbst geprüft werden muss
Rasterbasierte Bewertung ist inzwischen ein gängiger Weg, um die Ausgaben von Sprachmodellen und Agenten zu beurteilen. Zudem liefern Rubrics Belohnungssignale im Training. Snorkel argumentiert, dass das Raster in beiden Fällen das Messinstrument ist. Die Aussagekraft eines Scores hänge daher davon ab, wie gut das Raster abbildet, was die Aufgabe eigentlich prüfen soll.
Die Qualität von Rubrics werde, so der Beitrag, selten direkt untersucht. Meist werde sie aus der Übereinstimmung zwischen automatisierten Bewertern und menschlichen Gutachtern abgeleitet oder aus den Zugewinnen von Modellen, die mit rasterbasierten Belohnungen trainiert wurden. Snorkel weist darauf hin, dass beide Maße das Raster mit dem Modell vermengen, das es anwendet. Ein Raster, das in sich stimmig und verständlich ist, aber nicht zur Aufgabe passt, könne keines von beiden erkennen.
RIFT (RubrIc Failure mode Taxonomy), beschrieben in einem Paper von Aich et al., 2026, setzt hier an und bewertet das Raster unmittelbar. Das Verfahren lässt kein Modell ein Qualitätsurteil vergeben. Stattdessen berechnet es quantitative Signale aus dem Inhalt des Rasters, gestützt auf Ansätze aus der Mess- und Bildungstheorie.
So funktioniert RIFT und so wurde es validiert
RIFT berechnet vier Familien von Qualitätssignalen. Ein Gremium simulierter Experten stimmt darüber ab, ob ein Kriterium wesentlich ist. Die Kriterien werden an den Zielen der Aufgabe gemessen, um die Abdeckung zu bestimmen. Beinahe-Duplikate werden über Ähnlichkeit erkannt. Die Punktwerte werden mit der Einschätzung des Gremiums zur Wichtigkeit verglichen. Jedes Signal wird relativ zu anderen Aufgaben desselben Benchmarks ausgewiesen, und eine Taxonomie aus neun Fehlermodi ordnet jede Abweichung einem benannten Defekt zu. Die Taxonomie wurde aus Expertenkritiken an 85 Rubrics entwickelt.
Zur Validierung fügte Snorkel jeden Fehlermodus in bekannter Schwere in 60 von Experten verfasste Rubrics ein. Ein multinomialer logistischer Klassifikator über die Signaländerungen erkannte den eingefügten Modus mit einer Genauigkeit von 75,0 Prozent, bei einer Zufallsquote von 12,5 Prozent, unter Leave-one-task-out-Kreuzvalidierung. Ein LLM-Judge, dem dieselben Rubrics vorgelegt wurden, kam auf 56,7 Prozent.
Das zeigt die Analyse über fünf Domänen
Die Analyse umfasste jeweils 27 bis 30 Aufgaben aus fünf Benchmarks: Finanzen, Medizin, Softwareentwicklung, professionelle Beratung und logisches Schlussfolgern. Über alle 147 Aufgaben hinweg lag der Anteil der Aufgaben, bei denen der jeweilige Modus auffiel, bei:
- Fehlende Kriterien: 50 %
- Unpassende Kriterien (Misalignment): 48 %
- Nicht fundierte Überprüfung (Ungrounded Verification): 37 %
- Redundanz: 35 %
- Falsch kalibrierte Gewichtung: 29 %
- Zu starr: 14 %
- Subjektive Sprache: 10 %
- Nicht atomar: 7 %
Bei fehlenden Kriterien stach die Medizin mit 90 Prozent der Aufgaben (27 von 30) heraus. Unpassende Kriterien traten in den urteilslastigen Domänen am häufigsten auf: 73 Prozent in der Medizin, 70 Prozent beim Schlussfolgern und 57 Prozent in der professionellen Beratung, verglichen mit 11 Prozent bei Finanzen. Die nicht fundierte Überprüfung zeigte das umgekehrte Muster: Sie fand sich in 74 Prozent der Finanzaufgaben und 57 Prozent der Softwareentwicklungsaufgaben, aber nur in 3 Prozent der Aufgaben zum Schlussfolgern.
Snorkel zufolge bestätigten die Ergebnisse zwei von drei Ausgangserwartungen: Atomarität und sprachliche Verankerung seien weitgehend solide gewesen, Fehler bei Abdeckung, Passung und Fundierung dagegen häufiger. Nicht atomare Kriterien fanden sich in 11 von 147 Aufgaben, subjektive Sprache in 14 von 147. Eine Ausnahme bildete subjektive Sprache im Bereich Schlussfolgern mit 33 Prozent, wo Aufgaben das Abwägen konkurrierender Gesichtspunkte verlangen. Der Beitrag nennt als Beispiel ein Kriterium, das fragt, ob eine Antwort „die Auswirkungen der Befolgung des Rats der Therapeutin abwägt“, ohne zu präzisieren, welche Auswirkungen gemeint sind.
Grenzen und Folgen für Autoren von Rubrics
Snorkel nennt zwei Einschränkungen. Bei rund 30 Aufgaben pro Domäne umfasst das 95-Prozent-Konfidenzintervall für eine Rate von etwa 50 Prozent grob plus/minus 18 Punkte. Vergleiche zwischen Domänen sind daher nur ein Hinweis, die gepoolten Schätzungen sind verlässlicher. Die Manipulierbarkeit (Hackability) wird im Beitrag gesondert ausgewiesen. Aufgaben, bei denen ein Modus nur als geringfügiges Problem auftrat, fließen nicht in die Prozentwerte ein.
Das Unternehmen erklärt, es wolle die Praxis des Rubric-Schreibens insgesamt beschreiben und Autoren beim Verbessern helfen. Die Signale und die Taxonomie gäben ihnen ein gemeinsames Vokabular, um über Mängel von Rubrics zu sprechen. Für Teams, die bei Evaluation oder Belohnungssignalen auf Rubrics setzen, legen die Ergebnisse nahe: Die Prüfung, ob ein Raster die Aufgabe abdeckt und zu ihr passt, dürfte wichtiger sein, als Formulierungen zu glätten oder gebündelte Kriterien aufzuspalten.
Snorkel AI: Checking the Rubrics: RIFT Results on Five Public Benchmarks