Snorkel AI gibt jedem Pull Request eine eigene Lakebase-Kopie der Produktionsdaten
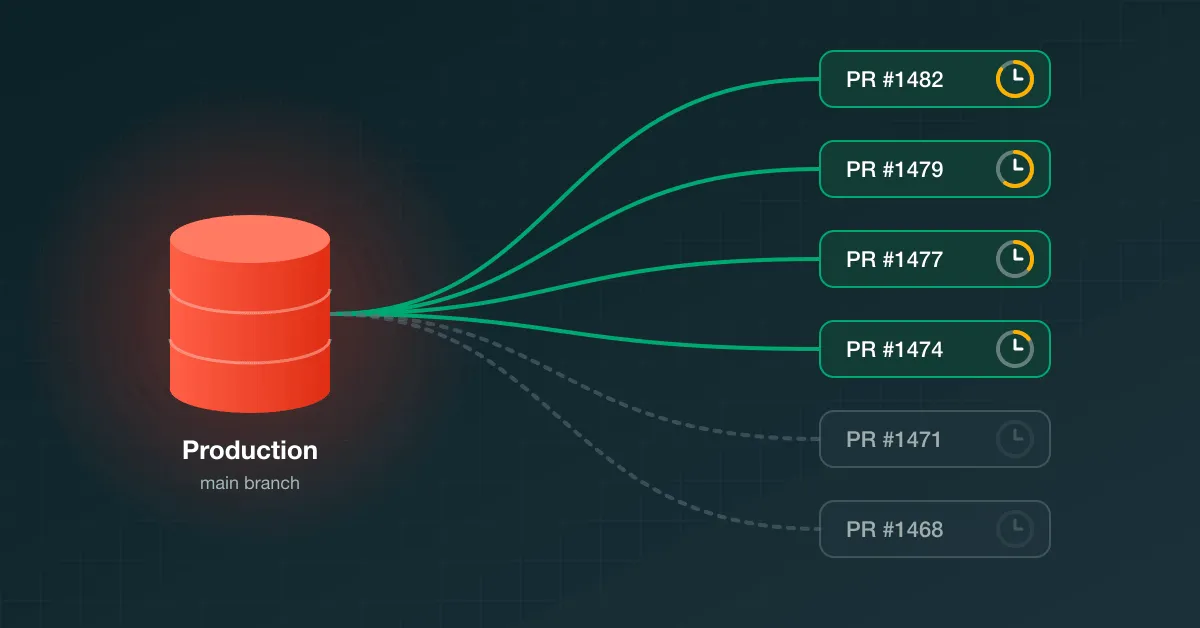
Snorkel AI erstellt jetzt für jeden offenen Pull Request einen eigenen Lakebase-Postgres-Branch: eine vollständige Lese-/Schreibkopie der Produktionsdaten, die in unter einer Minute bereitsteht. Laut Databricks ersetzt das Setup Datenbank-Restores, die pro Umgebung etwa 20 Minuten dauerten und das Team bislang davon abgehalten hatten, für jeden PR eine eigene Kopie zu aktivieren.
- Snorkel AI gibt jedem offenen Pull Request einen eigenen Lakebase-Postgres-Branch der Produktionsdaten, der in unter einer Minute bereitsteht.
- Das Wiederherstellen einer Kopie aus Aurora dauerte laut Databricks etwa 20 Minuten pro Umgebung.
- Copy-on-Write-Branches belegen nur für geänderte Daten zusätzlichen Speicher: rund 5 bis 10 GB pro PR-Branch auf einer Basis von ca. 1 TB.
- AWS DMS hält den Main-Branch höchstens etwa 2 Minuten hinter der Aurora-Produktion.
- Branch-TTLs löschen abgelaufene Branches automatisch, und die CI nutzt Service Principals mit kurzlebigen OAuth-Tokens.
Das Problem: Tests unter Produktionsbedingungen waren zu aufwendig einzurichten
Snorkel AI entwickelt Tools für die Datenaufbereitung für KI-Teams, die von professionellen Daten-Annotatoren und Anbietern von Frontier-Modellen genutzt werden. Der Code läuft durch eine CI-Pipeline auf Kubernetes-Basis, in der jeder offene Pull Request sowie Ad-hoc-Commits einen eigenen temporären Namespace erhalten. Entwickler deployen dort ihren Branch und führen vor dem Merge die vollständige Test-Suite aus.
Am aussagekräftigsten sind diese Tests mit echten Daten. Die Produktionsdatenbank von Snorkel ist ein Amazon-Aurora-PostgreSQL-Cluster, und die Wiederherstellung einer Kopie für jeden PR-Namespace dauerte laut Databricks etwa 20 Minuten. Das ist zu langsam, wenn Entwickler den ganzen Tag über PRs öffnen und die Merge-Queue für jeden Lauf eine frische Umgebung braucht. Die Alternativen wie geteilte Staging-Datenbanken, gekürzte Fixtures oder synthetische Daten bringen genau die Probleme zurück, die produktionsnahes Testen vermeiden soll: Tests, die sich gegenseitig stören, veraltete Schemas und Fehler, die nur bei realen Datenformen auftreten.
Snorkel legte mehrere Erfolgskriterien fest: ein neuer Branch in unter 60 Sekunden (p95), rund 100 gleichzeitige PR-Branches in Spitzenzeiten, Kompatibilität mit der bestehenden Anwendung über Standard-Postgres, ein Main-Branch, der höchstens etwa 2 Minuten hinter der Produktion liegt, sowie privates Networking mit Okta-SSO.
So funktioniert das Branching-Setup
Lakebase ist die serverlose Postgres-Datenbank von Databricks. Speicher und Compute sind getrennt, und die Datenbank unterstützt Branching: Von jedem beliebigen Zeitpunkt aus lässt sich ein neuer, isolierter und beschreibbarer Branch anlegen, ähnlich wie ein Git-Branch. Die Branches arbeiten per Copy-on-Write, das Anlegen ist also eine reine Metadatenoperation. Ein Branch teilt sich Speicherseiten mit seinem Ursprung, und nur die Seiten, die er ändert, werden als neuer Speicher geschrieben.
Die Pipeline von Snorkel besteht aus vier Schritten:
- Main aktuell halten. Ein AWS-DMS-Task repliziert die Aurora-Produktionsdatenbank in den Lakebase-Main-Branch, zunächst mit einem Full Load, danach per fortlaufender Change Data Capture. So liegt Main höchstens etwa 2 Minuten hinter der Produktion. Der Full-LOB-Modus überträgt auch JSONB-Werte von 10 bis 20 MB. Das Team nutzte DMS bereits, eine neue Replikationspipeline war daher nicht nötig.
- Branch beim Öffnen des PR. Die CI-Pipeline ruft die Lakebase-API auf, erstellt einen Branch von Main, setzt eine Ablaufzeit und übergibt die Verbindungsdaten an den PR-Namespace.
- Tests auf echten Daten. Die Anwendung verbindet sich über Standard-Postgres und kann Migrationen ausführen, Daten schreiben und Schemas ändern, ohne Produktion, Main oder andere PRs zu beeinflussen.
- Aufräumen. Die Pipeline löscht den Branch, sobald der PR gemergt oder geschlossen wird. Läuft dieser Schritt nicht, verfällt der Branch, wenn seine TTL abläuft.
Jeder Branch hat eigenes Autoscaling-Compute, das zwischen den CI-Läufen auf null herunterskaliert. Selbst bei 100 bereitgestellten Branches erwartet Snorkel, dass nur etwa 20 bis 30 gleichzeitig Traffic verarbeiten, mit jeweils rund 5 Abfragen pro Sekunde in Spitzenzeiten.
Sicherheit: privates Networking und getrennte Identitäten
Zwei Sicherheitsanforderungen prägten das Design. Die Produktionsdaten wandern von Aurora zu Lakebase und von Lakebase zum CI-Cluster über privates Networking und nicht über das öffentliche Internet.
Bei den Identitäten gibt es bei Snorkel zwei Arten von Datenbanknutzern. Entwickler, die eine PR-Umgebung debuggen, melden sich mit ihrer gewohnten Okta-Identität an, die mit dem Databricks-Konto föderiert und per SCIM bereitgestellt wird. CI-Pipelines laufen ohne menschliches Zutun, daher läuft jeder PR-Namespace als Databricks-Service-Principal, der pro Team oder Repository zugeschnitten und ebenfalls per SCIM bereitgestellt wird. Der PR-Pod nutzt die Zugangsdaten des Service Principals, um über das Databricks SDK kurzlebige Lakebase-OAuth-Tokens zu beziehen, und erneuert sie bei langen Testläufen. Laut Databricks gibt es in der CI keine langlebigen Datenbankpasswörter. Die Postgres-Auditlogs erfassen für jede Abfrage die Identität des Service Principals, sodass sich jede Abfrage der Pipeline zuordnen lässt, die sie ausgeführt hat.
Kosten, Ablauf und Einsatz durch KI-Agenten
Da Branches die meisten Daten mit Main teilen, wächst der Speicherbedarf mit den Änderungen jedes Branches und nicht mit der Größe der Datenbank. Die PR-Branches von Snorkel schreiben auf einer Basis von ca. 1 TB etwa 5 bis 10 GB an Änderungen. Databricks zufolge fällt bei 100 gleichzeitigen PR-Datenbanken auf einem Produktionsdatensatz von ca. 2,5 TB nur für die Daten zusätzlicher Speicher an, die jeder Branch ändert.
Der Ablauf ist wichtig, weil ein Branch den Datenstand behält, der bei seiner Erstellung existierte. Während DMS Main laufend aktualisiert, hält ein langlebiger Branch ältere Seiten vor, und sein Speicher wächst. Eine TTL für jeden CI-Branch sorgt dafür, dass er nach Abschluss des PR automatisch entfernt wird. Der Speicherbedarf bleibt so nahe an der Größe der Produktion plus den Änderungen aktiver PRs.
Databricks argumentiert, dass dasselbe Muster auch für KI-Agenten taugt, die SQL schreiben, Migrationen ausführen oder Daten verändern. Jede Agentenaufgabe könnte einen eigenen Branch von Main erhalten, Teams könnten prüfen, was ein Agent geändert hat, oder den Branch einfach löschen, und TTLs würden verwaiste Branches aufräumen. Agenten könnten zudem als Service Principals mit kurzlebigen OAuth-Tokens laufen, sodass sich ihre Abfragen in den Auditlogs nachverfolgen lassen.
Für Teams mit großen Produktionsdatenbanken zeigt das Beispiel, wie Branching Tests pro PR auf echten Daten praktikabel machen kann, ohne Restores, die Dutzende Minuten dauern. Die Zahlen stammen aus der Darstellung von Databricks zum eigenen Einsatz bei Snorkel.
Databricks: Lakebase branching for CI/CD: lessons from 100 PR databases