MedPAIR prüft, ob KI und Ärzte dieselben medizinischen Fakten für relevant halten
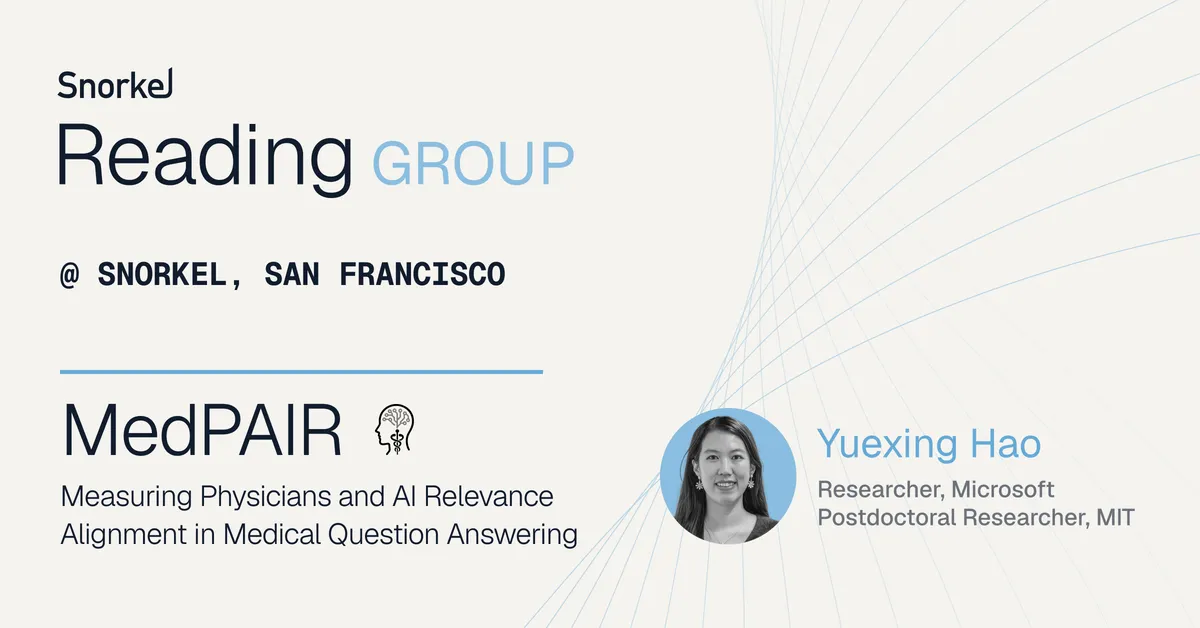
Ein neuer Datensatz namens MedPAIR vergleicht, welche Teile eines klinischen Falls Ärzte und große Sprachmodelle für relevant halten. Laut einem Bericht von Snorkel AI über einen Vortrag in einer Lesegruppe haben Ärzte in Weiterbildung und Fachärzte mit Facharztprüfung jeden Satz in 933 medizinischen Prüfungsfragen bewertet, sechs LLMs bewerteten dieselben Sätze.
- MedPAIR vergleicht, welche Sätze in 933 medizinischen Prüfungsfragen Ärzte und sechs LLMs als relevant einstufen.
- An der Annotation beteiligten sich 52 Ärzte in Weiterbildung und sieben Fachärzte, die gemeinsam mit Snorkel AI gewonnen wurden.
- Die Modelle lieferten selbstberichtete Relevanzlabels und Kontextwerte, die für Open-Source-Modelle mit ContextCite berechnet wurden.
- Der Datensatz ist auf Hugging Face verfügbar und wurde durch das Open-Benchmarks-Grants-Programm von Snorkel gefördert.
- Hao stellt am 8. Oktober auf dem Frontier Data Summit von Snorkel ein Poster vor.
Was MedPAIR misst
MedPAIR steht für Measuring Physician-AI Relevance Alignment. Vorgestellt wurde das Projekt von Yuexing Hao, Mitgründerin und COO von MatrAIx und zuvor Postdoc in der Healthy ML Group am MIT, bei einer Snorkel AI Reading Group. Die Studie stellt eine einfache Frage: Wenn ein Modell eine klinische Frage richtig beantwortet, stützt es sich dann auf dieselben Belege wie ein Arzt?
Hao sagte, die Motivation reiche ins Jahr 2024 zurück. Damals hätten sie und ihre Kollegen sich gefragt, ob große Sprachmodelle einsetzbar seien und warum man ihnen vertrauen sollte. Sie verwies auf eine Veröffentlichung in Nature Medicine aus dem Jahr 2024, nach der zusätzliche Patienteninformationen wie Laborwerte, Bildgebung und Ergebnisse der körperlichen Untersuchung die diagnostische Genauigkeit mitunter sogar senken konnten. Daraus entstand die Frage, ob Ärzte und Modelle bei demselben Patientenkontext auf dieselben Informationen achten.
MedPAIR wurde durch das Open-Benchmarks-Grants-Programm von Snorkel gefördert. Hao hat an der Cornell University promoviert und nach eigenen Angaben in den letzten zwei Jahren ihrer Promotion am MIT EECS bei Professorin Marzyeh Ghassemi gearbeitet. Zu den von ihr genannten Mitwirkenden zählen auch Forscher aus Oxford, von Google Research und vom HPI in Deutschland.
So funktioniert die Studie
Der Aufbau ähnelt Multiple-Choice-Fragen im Stil des USMLE. Jeder Fall besteht aus einem Patientenprofil, einer Frage und mehreren möglichen Antworten. In einem Beispiel umfasst das Profil sechs Sätze über einen zuvor gesunden 40-jährigen Mann mit einer seit drei Monaten langsam wachsenden Raumforderung in der rechten Brust und damit verbundenen Schmerzen. Gefragt wird nach der Diagnose.
Die Bewerter stuften jeden Satz des Profils als hoch relevant, gering relevant oder irrelevant ein. Auf der menschlichen Seite habe das Team laut Hao gemeinsam mit Snorkel AI 52 Ärzte in Weiterbildung und sieben Fachärzte gewonnen. Die Annotatoren mussten zunächst die Frage richtig beantworten, andernfalls floss ihre Bewertung nicht ein. Die Labels wurden per Mehrheitsentscheid aggregiert.
Sechs Sprachmodelle, sowohl Open-Source- als auch proprietäre, allesamt nicht feinabgestimmt, lieferten zwei Arten von Relevanzurteilen:
- Selbstberichtete Urteile, die per Prompt erzeugt wurden.
- Kontextwerte, die zeigen, wie stark das Modell jeden Satz bei seiner Vorhersage gewichtet hat, berechnet mit ContextCite für die Open-Source-Modelle.
Für einen fairen Vergleich verwendete das Team pro Frage dasselbe Satzbudget. Es nahm die Top-Sätze nach dem Mehrheitsvotum der Ärzte in Weiterbildung und anschließend dieselbe Zahl an Top-Sätzen nach den Kontextwerten des jeweiligen Modells.
Die Studie hat eine zweite Runde, in der geprüft wird, ob die als relevant markierten Sätze tatsächlich notwendig sind. Bleiben nur diese Sätze erhalten und der Rest wird entfernt, kann dann ein Arzt oder ein Modell die Frage noch richtig beantworten? Die Forscher definieren außerdem eine Spurious Rate, die untersucht, ob das Entfernen von Sätzen, die als gering relevant oder irrelevant eingestuft wurden, die Antwort eines Modells verändert.
Datensatz und Ausblick
Der entstandene MedPAIR-Datensatz kombiniert Originalfragen aus öffentlichen Benchmarks mit Annotationen von Ärzten in Weiterbildung, Kontextwerten der Modelle und selbstberichteten Relevanzlabels der Modelle. Er ist auf Hugging Face verfügbar.
In dem Vortrag testete Hao mit dem Publikum drei Hypothesen: ob hoch relevante Sätze durchgängig länger und einheitlicher sind, ob Menschen und Modelle bei der Relevanz uneins sind und ob sich die Modellleistung durch menschliche Relevanzurteile verbessern lässt. Das Publikum antwortete auf die erste Frage mit Nein, auf die zweite mit Ja und gab bei der dritten gemischte Antworten. Der hier vorliegende Quelltext endet vor der Präsentation der Ergebnisse, weshalb er nicht wiedergibt, wie die Daten tatsächlich ausfielen.
Hao wird die Arbeit am 8. Oktober auf dem Frontier Data Summit von Snorkel in einem Poster vorstellen. Snorkel unterstützt außerdem am 9. Oktober einen Workshop bei der COLM mit dem Titel DAIH: LLM/VLM Deployment Opportunities and Risks in Healthcare.
Für alle, die medizinische KI bewerten, verschiebt das Projekt den Fokus von der Genauigkeit der Endantwort auf die Belege hinter einer Antwort. Der Datensatz gibt Forschern die Möglichkeit zu prüfen, ob eine richtige Antwort auf denselben Sätzen beruht, auf die sich auch ein Arzt stützen würde.