Deepgram erweitert medizinisches Spracherkennungsmodell Nova-3 auf 10 Sprachen
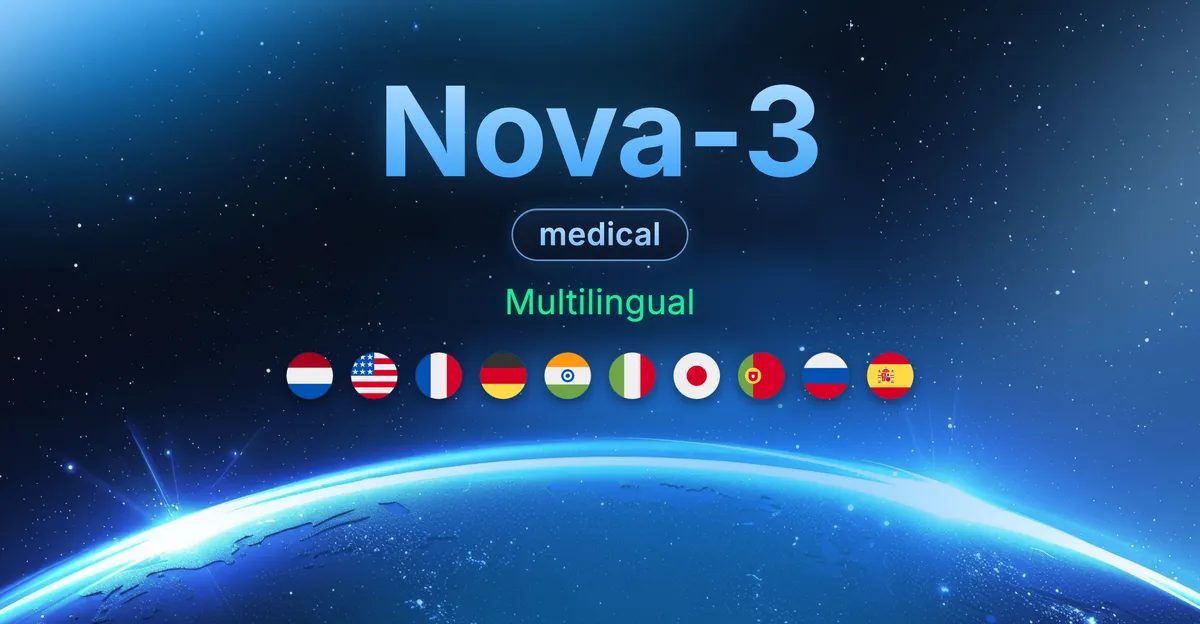
Deepgram hat Nova-3 Medical Multilingual vorgestellt, ein auf Medizin spezialisiertes Spracherkennungsmodell für Niederländisch, Englisch, Französisch, Deutsch, Hindi, Italienisch, Japanisch, Portugiesisch, Russisch und Spanisch. Laut Unternehmen senkt es die Wortfehlerrate bei der Batch-Transkription um 25 % gegenüber dem allgemeinen mehrsprachigen Modell.
- Deepgrams Nova-3 Medical Multilingual deckt Niederländisch, Englisch, Französisch, Deutsch, Hindi, Italienisch, Japanisch, Portugiesisch, Russisch und Spanisch ab.
- Gegenüber Nova-3 Multilingual sank die WER im Batch-Modus von 6,62 % auf 4,96 % und im Streaming von 8,32 % auf 5,86 %, so Deepgram.
- Die Entity Error Rate sank im Batch-Modus um 37 % und im Streaming um 40 %, bei Dosisfehlern im Batch-Modus um 64 %.
- Deepgram meldet die niedrigste durchschnittliche WER im Batch-Modus im Vergleich zu ElevenLabs Scribe v2 Medical, Scribe v2 und Microsoft MAI 1.5.
- Ab sofort über die Deepgram-API mit model=nova-3-medical&language=multi sowie für selbst gehostete Installationen verfügbar.
Ein Modell für 10 Sprachen, mit Code Switching
Nova-3 Medical, das Deepgram 2025 auf den Markt brachte, beruht auf der Idee, dass medizinische Sprache ein Modell braucht, das auf die Fachsprache der Medizin trainiert ist. Die neue Version überträgt diesen Ansatz über das Englische hinaus. Sie funktioniert sowohl im Batch- als auch im Streaming-Modus und enthält ein automatisches Code Switching zwischen den unterstützten Sprachen.
Deepgram argumentiert, dass die Unterstützung einer Sprache nicht gleichbedeutend mit der Unterstützung von Medizin in dieser Sprache ist. Ein allgemeines mehrsprachiges Modell kann ein Gespräch transkribieren und dennoch den Arzneimittelnamen, die Dosis oder die Diagnose verfehlen, auf die nachgelagerte Systeme angewiesen sind. Das Unternehmen nennt Beispiele wie einen Patienten in Madrid, der Brustschmerzen beschreibt, einen Arzt in München, der eine Metformin-Dosis von 500 auf 850 Milligramm ändert, und einen Angehörigen, der bei der Aufnahme zwischen Hindi und Englisch wechselt.
Entwickler wählen das Modell mit einer einzigen Einstellung aus: model=nova-3-medical&language=multi. Das Modell erkennt die gesprochene Sprache und folgt dem Gespräch, wenn die Sprechenden wechseln. Die Sprache muss also nicht bekannt sein, bevor das Audio eintrifft.
Was Deepgrams Benchmarks zeigen
Deepgram verglich Nova-3 Medical Multilingual mit seinem allgemeinen Nova-3 Multilingual anhand von mehr als 115 Stunden kuratierten medizinischen Audiomaterials in allen 10 Sprachen und mittelte die Ergebnisse. Bei der Batch-Transkription sank die durchschnittliche Wortfehlerrate (Word Error Rate, WER) von 6,62 % auf 4,96 %, eine Reduktion um 25 %. Beim Streaming sank sie von 8,32 % auf 5,86 %, eine Reduktion um 30 %.
Die WER war im Batch-Modus in 8 von 10 Sprachen und im Streaming in 9 von 10 Sprachen deutlich niedriger. Die größten Verbesserungen im Batch-Modus gab es bei Russisch, Spanisch und Hindi mit 58 %, 32 % und 30 %. Beim Englischen, für das bereits ein eigenes Nova-3-Medical-Modell existierte, blieb das Ergebnis im Wesentlichen unverändert.
Deepgram erfasst zudem die Entity Error Rate (EER), da die WER jedes Wort gleich gewichtet. Ein fehlendes „der“ und ein fehlendes „Metformin“ zählen jeweils als ein Fehler, obwohl ihre Auswirkungen sehr unterschiedlich sind. Die EER konzentriert sich auf Erkrankungen, Medikamente, Dosen, Datumsangaben, Zahlen und Namen. Laut Unternehmen sank die EER im Batch-Modus von 14,46 % auf 9,11 % (eine Reduktion um 37 %) und im Streaming von 16,31 % auf 9,78 % (eine Reduktion um 40 %).
- Dosen: 64 % weniger Fehler im Batch-Modus, 81 % weniger im Streaming
- Erkrankungen: 43 % weniger Fehler im Batch-Modus
- Medizinische Verfahren: 41 % weniger Fehler im Batch-Modus
- Medikamente: 31 % weniger Fehler im Batch-Modus
Vergleich mit anderen Anbietern
Deepgram ließ außerdem andere Spracherkennungsmodelle über deren APIs auf demselben medizinischen Datensatz laufen. Unter den Modellen, die in allen 10 Sprachen getestet wurden, erzielte Nova-3 Medical Multilingual laut Unternehmen die niedrigste durchschnittliche WER im Batch-Modus:
- Nova-3 Medical Multilingual: 4,96 %
- ElevenLabs Scribe v2 Medical: 5,49 %
- ElevenLabs Scribe v2: 5,58 %
- Microsoft MAI 1.5: 7,80 %
Bei 7 der 10 einzelnen Sprachen hatte das Modell die niedrigste WER. Deepgram räumt ein, dass kein Modell, auch das eigene nicht, in jeder Sprache vorn liegt, und erklärt, man berichte über den gesamten Satz, weil eine Anwendung, die Patientinnen und Patienten in fünf Sprachen versorgt, in allen fünf Genauigkeit benötigt.
Im Streaming erreichte das Modell über die 10 Sprachen hinweg im Schnitt 5,86 % WER und 9,78 % EER. Deepgram zufolge erzielte es in jeder Sprache die niedrigste WER im Vergleich zu den jeweils getesteten konkurrierenden Streaming-Modellen.
Einsatzszenarien und Verfügbarkeit
Deepgram nennt drei Anwendungsfelder, die von Echtzeit-Genauigkeit profitieren. Die ambiente Dokumentation erfasst einen Besuch, während er stattfindet, sodass Notizentwürfe die besprochenen Medikamente, Dosen und Erkrankungen widerspiegeln. Sprachagenten im Gesundheitswesen, die Terminplanung, Rezeptverlängerungen und Aufnahme übernehmen, müssen Medikamentennamen und Dosis korrekt erfassen, bevor sie den nächsten Schritt ausführen. Beim Diktat können Ärztinnen und Ärzte in ihrer eigenen Sprache arbeiten und wechseln, wenn ein Gespräch es erfordert, ohne das Modell zu wechseln.
Nova-3 Medical Multilingual ist ab sofort über die Deepgram-API verfügbar, sowohl für aufgezeichnete Audiodateien als auch für Streaming-Anfragen. Das Modell wird zudem für selbst gehostete Installationen angeboten, die Kunden über ihren Deepgram-Ansprechpartner anfragen können.
Für Teams, die Anwendungen im Gesundheitswesen für mehrsprachige Patientengruppen entwickeln, bedeutet die Veröffentlichung, dass ein einziges Modell mehrere Sprachen abdecken kann, ohne die medizinische Spezialisierung aufzugeben. Die Zahlen stammen aus Deepgrams eigener Auswertung, die Ergebnisse auf anderen Datensätzen können daher abweichen.