ExecuTorch erhält Cortex-M-Backend: PyTorch-Modelle laufen auf Mikrocontrollern
PyTorch hat ExecuTorch um ein Cortex-M-Backend erweitert. PyTorch-Modelle laufen damit direkt auf Arm-Cortex-M-CPUs, beschleunigt durch CMSIS-NN. Laut dem PyTorch-Team entfällt dadurch die Umwandlung der Modelle in Formate anderer Frameworks, bevor sie auf Mikrocontrollern eingesetzt werden.
- ExecuTorch hat jetzt ein Cortex-M-Backend, das PyTorch-Modelle mit CMSIS-NN-Beschleunigung auf Arm-Cortex-M-CPUs ausführt.
- Ein Workflow deckt die Stufen Scalar, DSP und MVE (Helium) ab, von Cortex-M0 bis M85.
- Auf dem Alif Ensemble E8 laufen laut PyTorch vier von fünf MLPerf-Tiny-Modellen in höchstens 21,5 ms und belegen auf einem Cortex-M55-Kern weniger als 90 KiB RAM.
- Die ExecuTorch-Kern-Runtime beansprucht laut PyTorch weniger als 20 KiB Flash-Speicher.
- Das Backend kann CPU-Operationen zusammen mit der Delegation an die Ethos-U-NPU im selben Graphen verarbeiten.
Schluss mit der Konvertierung für Mikrocontroller
Mikrocontroller stecken in Wearables, Industriesensoren, Sprachschnittstellen und Smart-Home-Geräten. PyTorch beschreibt diese Geräte als Systeme mit extremen Einschränkungen: oft weniger als 1 MB SRAM, nur einstellige Megabyte Flash-Speicher und Leistungsbudgets im Milliwatt-Bereich.
Bisher bedeutete der Einsatz von ML auf Cortex-M, so heißt es in dem Beitrag, das PyTorch-Ökosystem zu verlassen. Entwickler mussten Modelle in alternative Formate konvertieren, getrennte Toolchains für Training und Deployment pflegen und numerische Abweichungen beheben, die bei der Konvertierung entstehen. PyTorch weist darauf hin, dass es für über 90 % des Codes aus Veröffentlichungen auf führenden ML-Konferenzen verwendet wird. Für Teams, die damit trainieren, bedeutet der Übersetzungsschritt daher Reibung in jedem Iterationszyklus.
Arm-MCU-Unterstützung gab es in ExecuTorch bereits über die Ethos-U-NPU. Das neue Backend erweitert sie auf Cortex-M-CPUs, sodass ein Modell auf Chips mit und ohne Beschleuniger laufen kann. Das Modell wird in demselben Stack exportiert, quantisiert und heruntergebrochen (Lowering), der auch Modelle auf Mobilgeräten, Desktops und Servern bereitstellt.
So funktioniert das Cortex-M-Backend
Das Backend ersetzt Standard-PyTorch-Operatoren über Ahead-of-Time-Compiler-Passes durch benutzerdefinierte Operatoren auf Basis von CMSIS-NN. Zur Inferenzzeit rufen diese Operatoren die Bibliothek CMSIS-NN von Arm auf, eine Open-Source-Sammlung optimierter Kernel für neuronale Netze auf Cortex-M-Prozessoren.
- Quantisierte Operationen: Linear, Conv, Add, Mul, Softmax und Aktivierungen werden durch optimierte Implementierungen ersetzt.
- Zielplattformbewusste Kompilierung: Die CPU-Variante (M0 bis M85) und die ISA-Stufe werden zur Kompilierzeit festgelegt. So wird das passende CMSIS-NN-Backend gewählt und der Overhead durch Dispatch zur Laufzeit entfällt.
- Eigens entwickelter Quantizer: Er erzeugt INT8-quantisierte Graphen, die den Anforderungen von CMSIS-NN an das Datenlayout entsprechen, und nutzt dafür das PT2E-Quantisierungs-Framework von PyTorch.
- Eine Toolchain: Das Lowering arbeitet direkt auf dem Edge-Dialekt von ExecuTorch.
Das Backend deckt in einem Workflow drei Leistungsstufen ab: Scalar (M0, M0+, M3, M23), DSP (M4, M7, M33, M35P) und MVE, auch Helium genannt (M55, M85). Laut PyTorch liegen bei Helium die größten Leistungsgewinne, weil CMSIS-NN dessen beat-basiertes Ausführungsmodell nutzt, um Datenbewegung und Berechnung zu pipelinen. Das hilft bei den Depthwise- und Pointwise-Faltungen, die im Edge-ML üblich sind.
Entscheidungen zur Kompilierzeit und der Workflow für Entwickler
Mikrocontroller-Deployments zielen auf ein festes Hardwareprofil, und der Ahead-of-Time-Stack von ExecuTorch ist darauf ausgelegt, genau das auszunutzen. Laut PyTorch sind Optimierungen auf Graphebene, Speicherplanung, Gewichtspacking und Kernel-Auswahl zur Kompilierzeit allesamt zielplattformbewusst. Für Cortex-M gehört dazu:
- Das Entfernen redundanter Dtype-Konvertierungen, Quantize/Dequantize-Paare und Transpositionen des Speicherformats beim Lowering.
- Das Vorberechnen der Arithmetik für Skalierung und Nullpunkt in Integer-Multiplikator-/Shift-Form beim Export, sodass die quantisierte Inferenz in Festkommaarithmetik bleibt.
- Das Transponieren der Faltungsgewichte vom PyTorch-Layout OIHW in das CMSIS-NN-Format OHWI beim Export, sodass die Kosten einmalig bei der Kompilierung anfallen.
- Eine statische Speicherplanung, die mehrere Speicherbereiche wie TCM und SRAM umfassen kann, ohne Heap-Allocator, ohne Fragmentierung und ohne Speicherverwaltung zur Laufzeit.
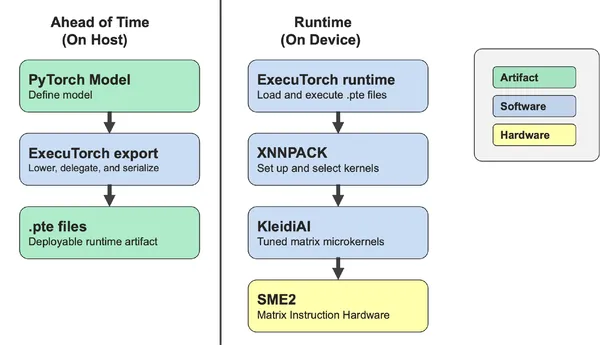
Der Workflow umfasst fünf Schritte: das Modell exportieren, es mit dem CortexMQuantizer quantisieren und kalibrieren, erneut exportieren, mit dem CortexMPassManager für ein Ziel wie den M55 auf Edge herunterbrechen und in eine .pte-Datei serialisieren. Diese Binärdatei wird zusammen mit der ExecuTorch-Runtime und der CMSIS-NN-Bibliothek in die Firmware gelinkt und anschließend auf das Gerät geflasht.
Zusammenspiel mit Ethos-U und Benchmark-Ergebnisse
Viele Cortex-M-MCUs kombinieren die CPU mit einer Ethos-U-NPU wie U55, U65 oder U85. Der EthosUPartitioner von ExecuTorch delegiert unterstützte Operationen über den Vela-Compiler an die NPU, die übrigen Operationen laufen im selben Graphen auf der Cortex-M-CPU. Erfüllt eine Operation die Anforderungen des Backends an Quantisierung, Layout und Shape, nutzt sie CMSIS-NN. Andernfalls greift sie auf die portablen Kernel von ExecuTorch zurück, die PyTorch als funktional, aber nicht beschleunigt bezeichnet.
Der praktische Vorteil liegt laut PyTorch darin, dass die Operatorabdeckung der NPU kein Alles-oder-nichts-Kriterium ist: Ein Modell mit einigen nicht delegierten Operationen kann mit gemischter CPU-/NPU-Ausführung ausgeliefert werden und mit wachsender Abdeckung mehr vom Graphen auf die NPU verlagern.
Das Team hat vier der fünf MLPerf-Tiny-Modelle auf dem Alif Ensemble E8 getestet. Laut PyTorch läuft jedes Modell in höchstens 21,5 ms und belegt auf einem einzelnen Cortex-M55-Kern weniger als 90 KiB RAM. Außerdem soll die ExecuTorch-Kern-Runtime weniger als 20 KiB Flash-Speicher beanspruchen, und selektive Builds linken nur die Operatoren, die ein Modell braucht. Der Codeumfang skaliert damit mit dem Modell und nicht mit dem Framework.
Für Teams, die bereits in PyTorch trainieren, bedeutet die Neuerung einen durchgängigen Weg vom Training zu einer breiten Palette von Cortex-M-Geräten, von einfachen Scalar-Kernen bis zu Chips mit Helium, ohne separate Konvertierungs-Toolchain.
PyTorch: Bringing ExecuTorch to Arm Cortex-M CPUs