Arm SME2 verkürzt Streaming-Spracherkennung auf dem Pixel 11 um bis zu Faktor 2,12
Eine PyTorch-Fallstudie zeigt: Die Matrixerweiterung SME2 von Arm verkürzt die Verarbeitungszeit einer gesamten Aufnahme mit dem Streaming-Sprachmodell Nemotron 3.5 auf einem Google Pixel 11 bei FP16 um den Faktor 2,12 und bei INT8 (QC8W) um den Faktor 1,61. Die Autoren leiten daraus ab, dass Chunk-Größe und Präzision gemeinsam gewählt werden sollten.
- Nemotron 3.5 wurde nach ExecuTorch exportiert und mit einem Inferenz-Thread auf einem Google Pixel 11 vermessen.
- SME2 verkürzte die Verarbeitung einer 24,9 Sekunden langen Aufnahme bei FP16 von 9,79 auf 4,61 Sekunden (2,12-fach) und bei QC8W von 5,20 auf 3,24 Sekunden (1,61-fach).
- Von Chunks mit 80 auf 1.120 ms sank die WER bei FP16 von 15,2 % auf 11,5 % und bei QC8W von 15,5 % auf 11,7 %.
- Mit SME2 liegen die Echtzeitfaktoren bei 0,19 für FP16 und 0,13 für QC8W.
- Die Datenbewegung macht nun bei beiden Präzisionen 17 % der Laufzeit aus und ist ein Ziel für weitere Optimierung.
Warum Streaming-ASR eine eigene Bewertung braucht
Der PyTorch-Beitrag geht von einem einfachen Punkt aus: Nutzer erwarten, dass Text erscheint, während sie sprechen. Damit unterscheidet sich automatische Spracherkennung (ASR) im Streaming von der Batch-Transkription, bei der das Modell zuerst die komplette Aufnahme sieht. Eine hohe Genauigkeit im Batch-Betrieb überträgt sich nicht zwangsläufig auf das Streaming.
Als Beispiel führen die Autoren eine modellübergreifende ASR-Studie an. Qwen3-ASR-1.7B hatte unter den getesteten Modellen die beste Batch-Genauigkeit, doch die Wortfehlerrate (WER) stieg bei Audio-Chunks von 2,4 Sekunden um 77 Prozent. Im Streaming-Vergleich derselben Studie hatte NVIDIA Nemotron Speech Streaming 0.6B über Chunks von 560 ms die niedrigste durchschnittliche Streaming-WER. Die Lehre daraus laut Beitrag: Die Genauigkeit muss im Chunk-Takt gemessen werden, der im Einsatz tatsächlich verwendet wird.
Die Fallstudie überführt das neuere mehrsprachige Nemotron 3.5 von PyTorch nach ExecuTorch, dem Edge-Inferenz-Framework von PyTorch, und vermisst es auf einem Pixel 11.
Wie das Modell läuft und was die Chunk-Größe ändert
Nemotron 3.5 basiert auf einer RNN-T-Architektur mit einem Encoder (FastConformer), einem LSTM-Predictor und einem kleinen Feedforward-Joiner. Der Encoder reduziert die Zeitpositionen um den Faktor 8, sodass jede Ausgabeposition 80 ms Audio abdeckt. Bei Lookahead 13 sammelt ein Aufruf 1.120 ms Audio und erzeugt 14 Encoder-Positionen. Die Lookaheads 0, 3 und 6 ergeben Chunks von 80, 320 und 560 ms. Längere Chunks bedeuten eine längere Wartezeit auf den ersten Text und auf spätere Aktualisierungen.
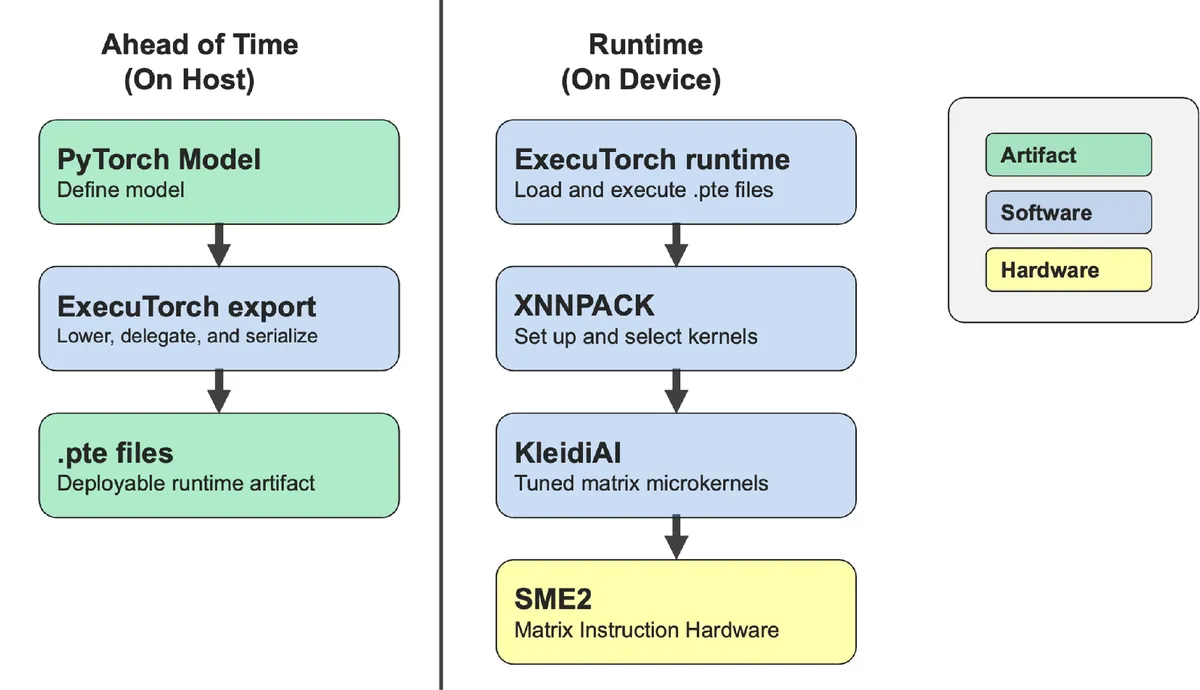
Softwareseitig exportiert ExecuTorch ein Modell in eine .pte-Datei. Unterstützte Operationen gehen an XNNPACK, und unter Android kann XNNPACK Mikrokernel aus Arm KleidiAI auswählen. Operatoren, die nicht an XNNPACK delegiert werden, nutzen die portablen CPU-Kernel von ExecuTorch.
Die Genauigkeit wurde auf einem Host-Rechner mit dem XNNPACK-Backend gemessen, und zwar mit dem Harness des Hugging Face Open ASR Leaderboard. Jeder Datenpunkt umfasst 14.019 Äußerungen aus vier Korpora. Längere Chunks verbesserten die Genauigkeit des finalen Transkripts: Von 80 auf 1.120 ms sank die WER bei FP16 von 15,2 % auf 11,5 % und bei QC8W von 15,5 % auf 11,7 %. FP16 wich bei jeder Chunk-Größe um weniger als 0,03 Prozentpunkte von FP32 ab. QC8W, das dynamische INT8-Aktivierungen und kanalweise INT8-Gewichte verwendet, erhöhte die WER gegenüber FP32 um 0,21 bis 0,31 Prozentpunkte.
SME2-Ergebnisse auf einem Pixel 11
Für den Geschwindigkeitstest verarbeitete das Team eine Aufnahme von 24,9 Sekunden mit Chunks von 1.120 ms und einem Inferenz-Thread, der an einen mittleren CPU-Kern gebunden war. Verglichen wurden zwei Builds von ExecuTorch 1.3.1, einmal mit und einmal ohne SME2, beide mit XNNPACK und KleidiAI.
- FP16: von 9,79 Sekunden auf 4,61 Sekunden (2,12-mal schneller).
- QC8W: von 5,20 Sekunden auf 3,24 Sekunden (1,61-mal schneller).
Mit aktiviertem SME2 liegen die Echtzeitfaktoren bei 0,19 für FP16 und 0,13 für QC8W. Das lässt nach Angaben der Autoren Spielraum für andere CPU-Arbeit zwischen den Chunks und kann helfen, die thermische Belastung im Griff zu behalten, beseitigt aber nicht die Verzögerung durch das Sammeln des Audios.
Die ETDump-Operatorzeiten zeigen, woher der Gewinn kommt. Die GEMM-Zeit sank bei FP16 von 8,2 auf 3,1 Sekunden und bei QC8W von 4,1 auf 2,0 Sekunden. GEMM bleibt der größte Anteil am Lauf, doch sein Anteil fiel bei FP16 von 84 % auf 67 % und bei QC8W von 78 % auf 62 %. Die Datenbewegung benötigt in beiden Builds etwa gleich viel Zeit, ihr Anteil stieg daher bei FP16 von 8 % auf 17 % und bei QC8W von 9 % auf 17 %. Der Beitrag bezeichnet diese verbleibende Arbeit als Ziel für weitere Optimierung.
Das Profiling mit Arm Streamline auf dem Pixel 11 ergab eine SME-Auslastung von 38,4 % bei FP16 und 53,7 % bei QC8W. Die Autoren betonen, dass dies zeigt, wie viel jeder Aufzeichnung der Matrix-Hardware zugewiesen war, und nicht, wie viel Prozent des maximalen Rechendurchsatzes erreicht wurden.
Was das für Entwickler bedeutet
Die Studie legt nahe, dass Entwickler Spracherkennung auf dem Gerät nach Genauigkeit und Latenz gemeinsam beurteilen sollten statt nach Batch-Werten. Längere Chunks senken die WER, verzögern aber den Text, während FP16 und QC8W einen kleinen Genauigkeitsunterschied gegen unterschiedliche Verarbeitungszeiten tauschen. Auf dem getesteten Smartphone verschaffte SME2 beiden Präzisionen auf einem einzelnen Thread viel Spielraum bei der Verarbeitung. Der Beitrag weist zudem darauf hin, dass das Aktivieren von SME2 die Pfade nur verfügbar macht; ob tatsächlich die passenden Kernel liefen, lässt sich nur mit nativem Profiling prüfen.