PyTorch 2.15 macht neu geschriebenes NCCL-Backend zum Standard und bringt FP8 auf Apple Silicon
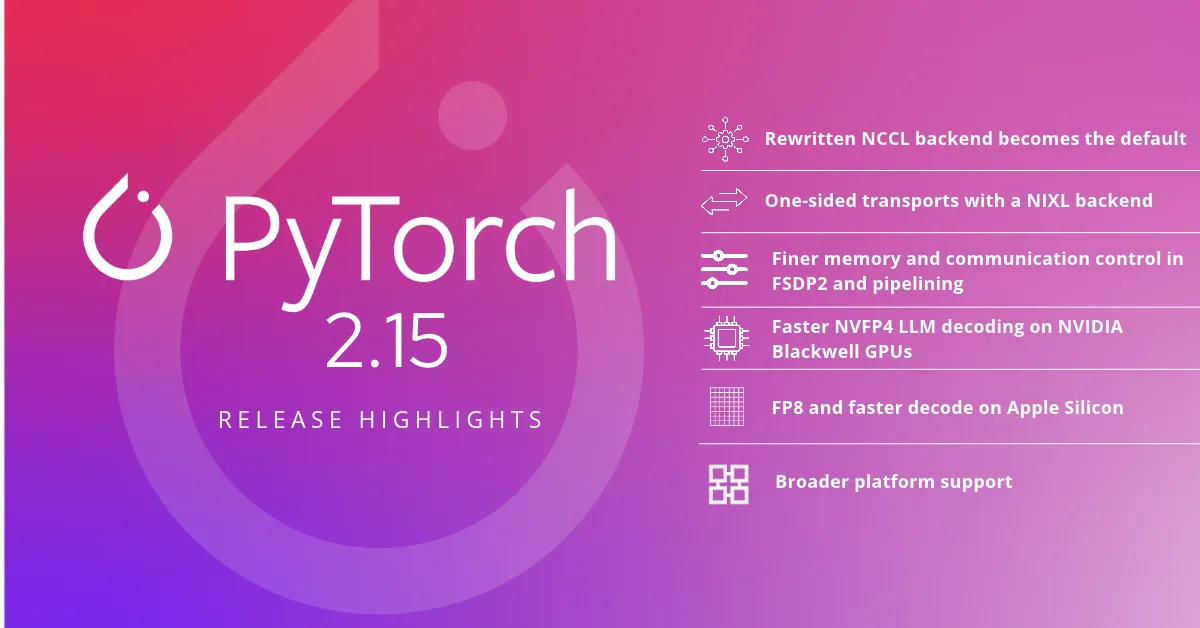
PyTorch 2.15 ist erschienen, und das neu geschriebene NCCL-Backend läuft jetzt standardmäßig für jede nccl-Prozessgruppe. Das Release ergänzt außerdem einseitige Transports in torch.distributed, feinere Speicherkontrolle in FSDP2 und beim Pipelining, FP8-Unterstützung auf Apple Silicon und eine breitere Hardwareabdeckung.
- Das neu geschriebene NCCL-Backend ist jetzt der Standard für jede nccl-Prozessgruppe, mit TORCH_DIST_USE_NCCL2=0 und nccl-legacy als Rückfalloptionen.
- torch.distributed erhält einseitige Transports mit NIXL als erstem Backend, aufzeichenbar in CUDA-Graphs.
- Apple Silicon bekommt FP8 und schnelleres Decoding, darunter 1,32- bis 1,34-fachen MoE-Decode-Durchsatz auf einem M3 Ultra.
- CUDA 13.2 wird zum Standard-Wheel, zusätzlich erscheinen CUDA-13.4- und ROCm-10.0-Wheels.
- Das Release umfasst 3.117 Commits von 583 Beitragenden seit PyTorch 2.14.
Neuer Standard für verteiltes Training
Laut dem PyTorch-Team läuft jeder Job, der nccl nutzt, jetzt standardmäßig auf dem neu geschriebenen Backend. PyTorch 2.14 hatte es als optionales nccl2-Backend vorgestellt, portiert aus torchcomms. In 2.15 liegt es jeder nccl-Prozessgruppe zugrunde, wobei TORCH_DIST_USE_NCCL2=0 und der Backend-Name nccl-legacy als Rückfallwege zur Verfügung stehen.
Kommunikatoren werden nun gemeinsam mit der Prozessgruppe sofort (eager) angelegt. Bei einer Rekonfiguration lässt sich ein Shrink/Grow-Schnellpfad aktivieren (ab NCCL 2.29), sodass die verbleibenden Ranks kein vollständiges Bootstrapping durchlaufen müssen. Reconfigure for fault tolerance ist zudem auf ROCm mit RCCL 2.30.7 aktiviert.
Für das Debugging im Produktivbetrieb schreibt ein backend-unabhängiger Flight Recorder ein Post-mortem auf die Festplatte, wenn eine Collective-Operation hängt. Der Zustand des Watchdogs wird an den Debug-Server gemeldet, sodass ein Timeout auf einem beliebigen Rank Flight-Recorder-Dumps von allen Ranks auslöst. Das Team weist darauf hin, dass im Cluster-Maßstab eine einzelne blockierte GPU einen ganzen Lauf stoppen kann und die Ursachensuche oft bedeutete, den Fehler von Hand nachzustellen.
Außerdem erhält torch.distributed eine Python-Transport-API für einseitige Datenübertragung, mit NIXL als erstem Backend. Transports verbinden sich über einen Store mit einem Peer, ohne Prozessgruppe oder Collectives. Transport.read_stream und write_stream reihen Übertragungen in einen CUDA-Stream ein, sodass sie sich mit torch.cuda.graph aufzeichnen lassen. Sowohl die NCCL-Arbeiten als auch die Transport-API sind als API Unstable gekennzeichnet.
FSDP2 und Pipeline-Parallelismus mit feinerer Steuerung
FSDP2 erlaubt es nun, präzisionskritische Parameter wie MoE-Router-Gates und Norm-Gewichte in fp32 zu halten, während der Rest des Modells in bf16 trainiert, weiterhin mit einem All-Gather pro fully_shard. Konfiguriert wird das über MixedPrecisionPolicy(param_dtype_override_fn=...). Ein vollständiger Gradient-Accumulation-Schritt lässt sich in einem einzigen CUDA-Graph aufzeichnen, und die Gradientengenauigkeit kann pro Parameter festgelegt werden. Gradienten werden direkt in .grad akkumuliert und folgen dem grad_dtype des jeweiligen Parameters, was das Standardverhalten bei reduce_dtype=None ändert. Die Release Notes führen dies unter den abwärtsinkompatiblen Änderungen auf.
Der Pipeline-Parallelismus legt Empfangspuffer jetzt unmittelbar vor jedem Empfang an, statt vorab für jeden Microbatch, und gibt Forward-Ausgaben frei, sobald ihre Sends abgeschlossen sind. Schedules akzeptieren ein max_outstanding_sends-Budget, und FSDP-Unshards werden über die Startup-Bubble jedes Ranks gestaffelt. Jede eindeutige Verbindung zwischen Pipeline-parallelen Ranks erhält einen eigenen P2P-Kommunikator, und die FSDP-Gradientenreduktion kann sich mit späteren Berechnungen überlappen. Laut dem Team machen diese Änderungen das PyTorch-Pipelining cudagraph-fähig und deterministisch, bei optimiertem Speicherprofil.
Apple Silicon, NVIDIA Blackwell und weitere Hardware
Auf Apple Silicon wandern weitere MPS-Operatoren von MPSGraph zu nativen Metal-Kernels. Das Team berichtet, dass ein Single-Row-Softmax über ein Vokabular mit 128.256 Einträgen 8-mal schneller läuft, Upsample-Backward bis zu 21,7-mal schneller und vollständige Norm-Reduktionen mehr als 100-mal schneller. F.linear nutzt nun vorhandene gemv-Kernels, mit einem geometrischen Mittel von 1,23x Beschleunigung und bis zu 5x bei kleinen Projektionen. Das neue MPS grouped_mm hat einen gemv-Pfad, der auf einem M3 Ultra einen um das 1,32- bis 1,34-Fache höheren MoE-Decode-Durchsatz liefert. Die QR-Zerlegung einer 512 x 512-Matrix sinkt von rund 7 Sekunden auf 1,5 ms. Das Release bringt außerdem float8_e4m3fn, _scaled_mm und öffentliche torch.mps.Stream-APIs.
Auf NVIDIA-Blackwell-GPUs rechnet NVGEMM, das in 2.14 eingeführte CuTeDSL-GEMM-Backend, den skalaren Dequantisierungsfaktor von ModelOpt-NVFP4-Linear-Layern jetzt in die GEMM-Operation ein. Das spart beim Decoding einen separaten Pointwise-Launch pro Layer. Eine begrenzte, shape-bewusste Kandidatenstrategie deckt Blackwell-NVFP4-Decode-Shapes ab, die nvMatmulHeuristics nicht erfasst.
Weitere Plattformänderungen umfassen FlyDSL-Kernels auf AMD gfx950, Unterstützung für den Tensor Data Mover bei gfx1250 (MI450) sowie einfachere SYCL-Kernel-Entwicklung und Multi-GPU-Profiling auf Intel-GPUs.
Paketierung und Folgen für Anwender
Das Standard-Wheel von PyTorch wechselt auf CUDA 13.2 (Toolkit 13.2.2). Parallel dazu erscheinen CUDA-13.4-GA-Wheels für Linux x86_64, Linux aarch64 und Windows, die experimentelle Unterstützung für NVIDIA-Rubin-GPUs ergänzen. ROCm-10.0-Wheels kommen neben die ROCm-7.14-Wheels aus 2.14. Alle ROCm-Wheels werden nun auf AMDs TheRock-Paketen gebaut und installieren ROCm als pip-Abhängigkeit, statt die Bibliotheken mitzuliefern. PyTorch 2.15 unterstützt Python 3.11 bis 3.15, einschließlich der Free-Threaded-Builds 3.14t und 3.15t, und Dynamo ergänzt Unterstützung für Python 3.15.
Für Teams, die Multi-GPU-Training auf NVIDIA-Hardware betreiben, greift die NCCL-Änderung ohne Codeanpassungen, und bei Problemen stehen die Rückfalloptionen bereit. Das Release umfasst 3.117 Commits von 583 Beitragenden seit PyTorch 2.14. Ein Q&A-Webinar ist für Donnerstag, den 5. November 2026, um 11 Uhr PT angesetzt, bei dem Meta-Ingenieure das Release vorstellen.
PyTorch: PyTorch 2.15 Release Blog