Google gibt Pathways für das Training großer Modelle allgemein frei
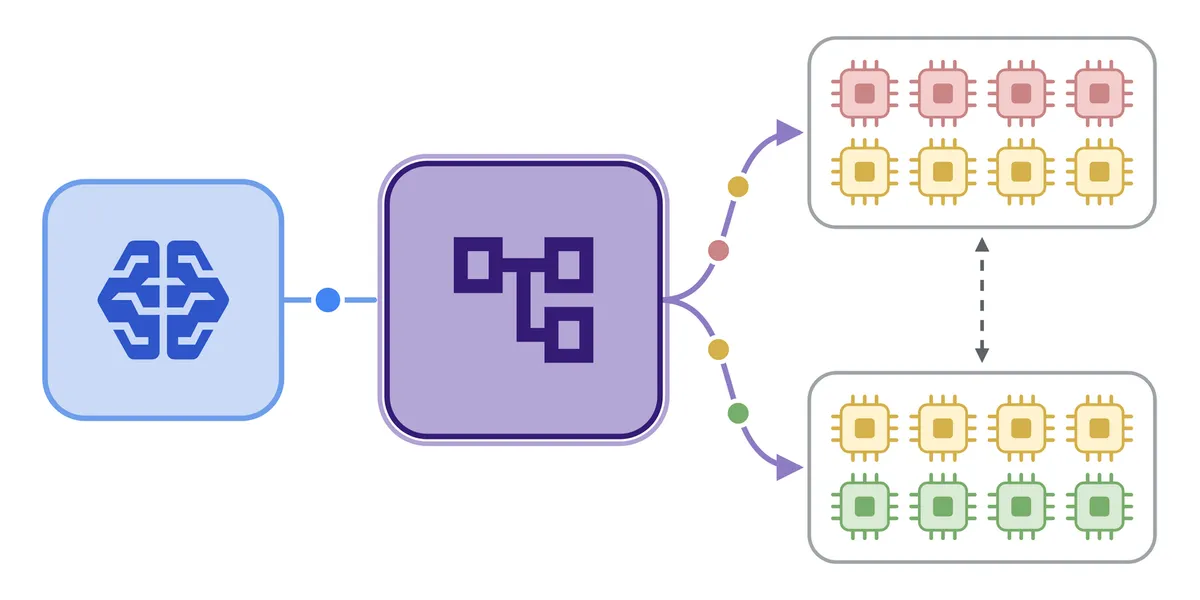
Google hat die allgemeine Verfügbarkeit von Pathways auf der Google Cloud Platform angekündigt. Das verteilte System wurde entwickelt, um große Modelle wie Gemini zu trainieren. Pathways verwendet einen einzigen Python-Client, der eine komplette Berechnung beschreibt, während die Laufzeitumgebung die Platzierung, Datenübertragungen und Ausführung auf Beschleunigern koordiniert.
- Pathways ist auf der Google Cloud Platform allgemein verfügbar.
- Google hat das System entwickelt, um große Modelle wie Gemini zu trainieren.
- Ein einziger Python-Client beschreibt die vollständige Berechnung als Graph.
- Die Laufzeitumgebung koordiniert Platzierung, Übertragungen, Abhängigkeiten und Reihenfolge.
- Pathways führt JAX-Programme auf TPUs aus.
Eine Antwort auf die Grenzen des SPMD-Trainings
Das Training großer Modelle basiert meist auf dem Modell „Single Program, Multiple Data“ (SPMD). Dabei führt jeder Beschleuniger dasselbe Programm im Gleichschritt aus und stimmt sich über kollektive Operationen wie AllReduce ab. Laut Google funktioniert das gut, wenn ein Auftrag einheitlich ist. Schwieriger wird es jedoch, wenn verschiedene Teile einer Berechnung gleichzeitig ausgeführt werden müssen.
Als Beispiele nennt das Unternehmen Pipeline-Parallelismus und das Post-Training mit bestärkendem Lernen. In einer Pipeline führen die Geräte unterschiedliche Stufen aus und können Zeit damit verbringen, auf Aktivierungen oder Gradienten zu warten. In einer RL-Schleife sind ein Sampler, ein Belohnungsmodell und ein Trainer separate Programme, die überlappend ausgeführt werden müssen. SPMD erschwert die Koordination dieser Abhängigkeiten, weil jeder Prozess nur Einblick in seine lokalen Geräte und Daten hat.
Ein Client beschreibt die gesamte Berechnung
Pathways verfolgt einen anderen Ansatz und stellt eine Berechnung von Anfang bis Ende als Graph dar. Die Arbeitsblöcke bilden Knoten, die zwischen ihnen übertragenen Tensoren die Kanten, und die Geräte sind die Orte, an denen die Knoten ausgeführt werden.
Mit Pathways definieren Entwickler diese Berechnung über einen einzigen Python-Client, ohne eigenen Koordinationscode schreiben zu müssen. Der Client läuft auf einem gewöhnlichen CPU-Rechner und arbeitet mit virtuellen Geräten, statt physische Chips direkt zu verwalten. Laut Google ordnet ein Ressourcenmanager diese virtuellen Geräte realen Beschleunigern zu, während Worker auf den Beschleuniger-Hosts die empfangenen kompilierten Programme ausführen.
Durch dieses Design werden die Beschreibung der Berechnung und die Hardware, auf der sie ausgeführt wird, voneinander getrennt. Google zufolge übernimmt die Laufzeitumgebung entlang des Graphen die Übertragung, Abhängigkeiten und Reihenfolge. Das Modell mit virtuellen Geräten ermöglicht zudem, die für eine Berechnung verwendeten Geräte zu ändern.
Für große und sich verändernde Workloads entwickelt
Google zufolge müssen große Trainingsläufe auch bei Hardwareausfällen fortgesetzt werden können. Während des Trainings von Gemini 2.5 unterbrachen Hardwareausfälle die Läufe laut dem Unternehmen mehrmals pro Stunde. In einer SPMD-Umgebung kann der Ausfall eines Rechners verhindern, dass eine kollektive Operation abgeschlossen wird, den Auftrag stoppen und einen Neustart ab dem letzten Checkpoint erzwingen.
Das Unternehmen beschreibt außerdem Einschränkungen bei der Ressourcenverwaltung. Im SPMD-Modell behalten Prozesse ihre Beschleuniger für die gesamte Dauer eines Laufs, selbst wenn eine Stufe weniger Chips benötigt als eine andere. Während der Ausführung können weder Geräte hinzugefügt noch zurückgegeben werden, und separate Aufträge erfordern separate Zuweisungen und Prozesse.
Pathways ist jetzt auf Google Cloud verfügbar und führt JAX-Programme auf TPUs aus. Für Teams, die große Modelle trainieren, bietet die Ankündigung Googles eigenes Koordinationssystem als Möglichkeit, komplexere Workloads zentral zu beschreiben, anstatt jeden Prozess und jede Datenabhängigkeit einzeln zu verwalten.
Google for Developers: What is Pathways? Single-controller training for large models- Google Developers Blog