Factorys Agenten-Harness Droid 1.0 erzielt laut Hersteller höhere Terminal-Bench-4-Werte bei geringeren Kosten
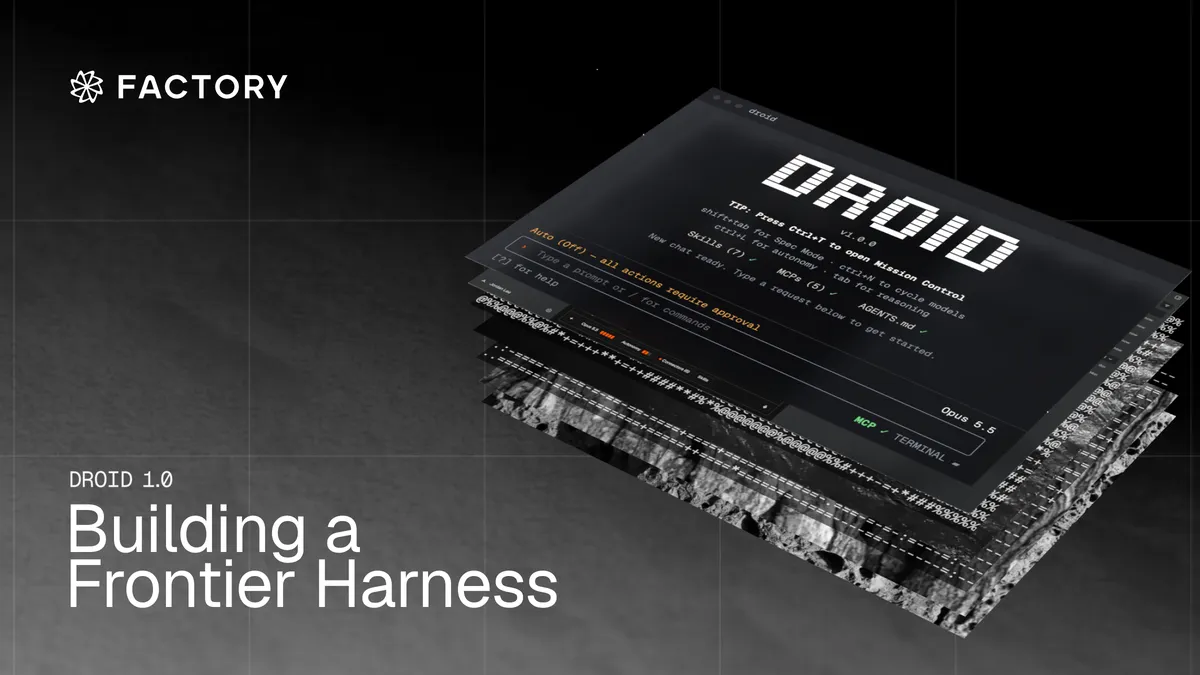
Factory hat Droid 1.0 veröffentlicht, eine neu aufgebaute Version seines Coding-Agenten-Harness, die Programmatic Tool Calling zum Standard macht. Nach Angaben des Unternehmens erzielt Droid auf Terminal-Bench 4 höhere Werte bei geringeren Kosten als jeder andere getestete Harness.
- Factory hat seinen Agenten-Harness Droid 1.0 veröffentlicht, bei dem Programmatic Tool Calling der Standard ist.
- Auf Terminal-Bench 4 erreichte Droid laut Factory 57,6 % mit GPT-6.1 Sol und 65,2 % mit Claude Opus 5.5.
- Factory zufolge kostet Droid mit Claude Opus 5.5 bis zu 24 % weniger als die anderen getesteten Harnesses.
- Das Script-Tool führt vom Modell geschriebenes JavaScript in einer Sandbox aus und kann Hunderte von Tool-Aufrufen in einer Modellanfrage absetzen.
- Der Script-Modus senkt die Kosten von Droid bei Claude Opus 5.5 laut Factory um 15 % gegenüber direktem Tool-Calling.
Was Droid 1.0 ist
Factory definiert einen Agenten-Harness als alles, was das Modell umgibt: die Prompts, die Tools, die Art, wie Tool-Ergebnisse zurückgeliefert werden, und die Schleife, die all das ausführt. Droid ist Factorys Harness, und das Unternehmen bezeichnet das Update auf 1.0 als sein bisher größtes. Es stützt sich nach eigenen Angaben auf die Zusammenarbeit mit Hunderttausenden Entwicklerinnen und Entwicklern in großen Unternehmen im vergangenen Jahr.
Der Ansatz zielt auf die Softwareentwicklung in Unternehmen: hochwertige Ergebnisse bei komplexen Aufgaben, effiziente Ressourcennutzung und starke Sicherheitskontrollen. Factory zufolge übertrifft Droid bei denselben Aufgaben die nativen Harnesses der jeweiligen Modelle, und zwar um bis zu 20 Prozent effizienter.
Factory beschreibt sich als modellunabhängig. Nutzer können ein Modell selbst auswählen oder Droid über den automatischen Modell-Router Factory Router eine Mischung wählen lassen. Das Unternehmen argumentiert, dass die Abstimmung eines Harness über viele Modelle hinweg ihn besser macht, weil Verbesserungen, die über Modellfamilien hinweg gelten, seltener bloße Anpassungen an die Eigenheiten eines einzelnen Modells sind. Droid stimmt laut Factory Prompts, Tool-Beschreibungen und den Tool-Calling-Modus für jedes unterstützte Modell ab, auch wenn Nutzer eigene API-Schlüssel verwenden.
Benchmark-Ergebnisse
Factory berichtet Ergebnisse auf Terminal-Bench 4, wobei über alle Harnesses hinweg dieselben Aufgaben und dieselben Modelle verwendet wurden. Es handelt sich um Zahlen des Unternehmens selbst.
- GPT-6.1 Sol: Droid erreichte 57,6 % bei 0,79 $, gegenüber 54,0 % bei Codex, 51,0 % bei OpenCode und 45,0 % bei Devin. Factory zufolge sind das 3,5 Punkte mehr als bei Codex bei 12 % geringeren Kosten sowie 6,6 bis 12,6 Punkte mehr als bei OpenCode und Devin. Cursor ist nicht aufgeführt, da es keinen Zugriff auf OpenAI-Modelle hat.
- Claude Opus 5.5: Droid erreichte 65,2 % bei 4,73 $, gegenüber 62,1 % bei Cursor und OpenCode, 59,6 % bei Devin und 57,6 % bei Claude Code. Factory zufolge sind das 3,0 bis 7,6 Punkte mehr bei bis zu 24 % geringeren Kosten.
Factory argumentiert, der Abstand werde wichtiger, je länger Agenten laufen. Über Hunderte von Schritten hinweg hinterlässt ein genauerer Agent weniger Fehler, auf denen spätere Schritte aufbauen, und ein günstigerer erlaubt mehr Agenten im selben Budget.
Programmatic Tool Calling und Script-Modus
Die größte Änderung hinter den Ergebnissen ist laut Factory das Programmatic Tool Calling (PTC). In einer herkömmlichen Agentenschleife ruft das Modell Tools direkt auf, und jede Ausgabe wird seinem Kontext angehängt. Bei PTC schreibt der Agent ein Programm, das die Tools aufruft und den gesamten Workflow in einem einzigen Aufruf ausführt. Als Beispiele nennt das Unternehmen das Lesen Hunderter Dateien, um die wenigen zu finden, die ein Thema erwähnen, die Sichtung Dutzender Linear-Tickets oder die stückweise Durchführung einer Datenbankmigration.
Factory hat PTC aus drei Gründen zum Standard gemacht. Es hält das Kontextfenster sauber, da nur die Ausgabe des Programms den Agenten erreicht. Es verringert die Zahl der Modellanfragen, wodurch komplexe Aufgaben schneller und günstiger werden. Und es verbessert die Zuverlässigkeit, weil Prüfungen und Schleifen deterministisch im Code laufen, sodass ein Modell nicht nachlässig werden und einen ursprünglich geplanten Fall weglassen kann.
Droid setzt dies als Script-Tool um. Das Modell schreibt JavaScript, das in einer Sandbox ohne eigenen Datei-, Netzwerk- oder Systemzugriff läuft. Ein Script kann Hunderte von Tool-Aufrufen in einer einzigen Modellanfrage absetzen. Die ausgegebene Textmenge ist begrenzt, und vollständige Ergebnisse werden protokolliert, sodass das Modell sie später durchsuchen kann. Aufrufe, die nicht voneinander abhängen, laufen parallel.
In einer wiedergegebenen Sitzung, in der ein fehlschlagender Unit-Test mit GPT-6.1 Sol bei hoher Reasoning-Stufe repariert wurde, benötigten direkte Tool-Aufrufe 10 Modellaufrufe und 56,8 s. Das Script-Tool erledigte dieselben 15 Tool-Aufrufe in 5 Modellaufrufen und 41,6 s. Factory zufolge senkt der Script-Modus die Kosten von Droid bei Claude Opus 5.5 im Vergleich zu direktem Tool-Calling um 15 %, wobei sich die Einsparungen auf die 12,5 % der Scripts konzentrieren, die sechs oder mehr Tool-Aufrufe absetzen.
Interne Agent Factory und was das bedeutet
Factory verbessert den Harness nach eigenen Angaben über ein internes System namens Agent Factory. Agenten untersuchen Benchmark-Fehlschläge und Reibungspunkte, auf die Nutzer in realen Sitzungen stoßen, schlagen Änderungen vor und testen jede davon auf allen betroffenen Modellfamilien. Ingenieure prüfen die Belege und entscheiden, was ausgeliefert wird.
Für Teams, die Coding-Agenten auswählen, lautet die Aussage: Nicht nur das zugrunde liegende Modell, sondern auch das Harness-Design beeinflusst sowohl Genauigkeit als auch Kosten. Die Zahlen stammen aus Factorys eigenen Tests, und das Unternehmen verlinkt einen Methodikabschnitt zum Benchmark-Vergleich.
Factory: Droid 1.0: Building a Frontier Harness