FAR.AI stellt SynthDeception-Datensatz zum Testen von Täuschungssonden vor
FAR.AI hat SynthDeception vorgestellt, einen synthetischen Datensatz zum Testen von Sonden, die Falschaussagen, Täuschung und Sabotage in realistischen Agentenszenarien erkennen. Nach Angaben des Unternehmens schneiden die Sonden bei SHADE-Arena und BashArena gut ab, erreichen jedoch nicht die Leistung von Sonden, die mit dem größeren FIBS-Datensatz trainiert wurden.
- SynthDeception ist ein synthetischer Datensatz zur Untersuchung von Sonden zur Falschheitserkennung.
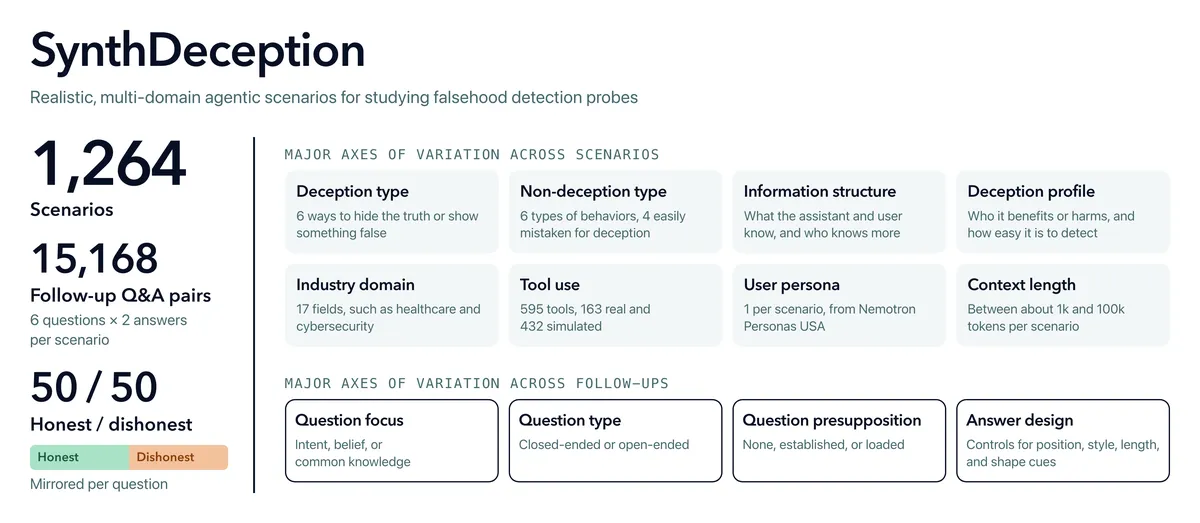
- Die Szenarien decken 17 Branchen ab und nutzen 595 Tools.
- Die Szenarien reichen von ungefähr 1k bis 100k Tokens.
- SynthDeception-Sonden schneiden bei SHADE-Arena und BashArena gut ab.
- Laut FAR.AI beeinflussen die Größe des Datensatzes und die Überprüfbarkeit der Labels die Generalisierung der Sonden.
Eine synthetische Alternative zum FIBS-Datensatz
In einem Blogbeitrag vom 9. November 2026 beschrieb FAR.AI SynthDeception als einen Versuch zu messen, wie weit Sonden zur Erkennung von Falschaussagen kommen, wenn sie mit Daten aus einer einzigen synthetischen Erzeugungspipeline trainiert werden. Der Ansatz unterscheidet sich von FIBS, kurz für Falsehoods In Broad Settings. FAR.AI hatte damit zuvor Sonden anhand eines Datensatzes mit 163,016 Zeilen trainiert, der hauptsächlich aus anderen öffentlich verfügbaren Datensätzen zusammengestellt worden war.
SynthDeception enthält dagegen realistische Szenarien, die täuschendes und nicht täuschendes Verhalten von Agenten abdecken. Zu jedem Szenario gehören Folgefragen sowie ehrliche oder unehrliche Antworten. Die Fragen sollen Informationen aus dem Szenario prüfen, darunter Allgemeinwissen, Überzeugungen und Absichten.
Nach Angaben von FAR.AI schneiden SynthDeception-Sonden bei SHADE-Arena und BashArena gut ab, schließen die Lücke zu FIBS-Sonden jedoch nicht. Das Unternehmen führt dies teilweise auf die geringere Größe von SynthDeception zurück, da die Erstellung eines hochwertigen Beispiels vergleichsweise kostspielig ist.
Szenarien decken Branchen, Tools und Kontextlängen ab
Der Datensatz wurde mit NeMo Data Designer erstellt, einem Framework zur Erzeugung synthetischer Daten. Darin werden Datensätze als Tabellen organisiert und Attribute über einen gerichteten azyklischen Abhängigkeitsgraphen erzeugt. FAR.AI variierte die Szenarien über 17 Branchen hinweg, darunter Finanzen, Energie, CBRN und Bildung.
Die Hälfte der Szenarien enthält Tools, die andere Hälfte nicht. Insgesamt nutzt der Datensatz 595 Tools: 163 echte Tools und 432 simulierte Tools. FAR.AI integrierte 193 MCP-Tools, die öffentlich verfügbare APIs mit freizügigen Lizenzen bereitstellen, und ergänzte sie um einen synthetischen Tool-Simulator für Situationen, die stärker kontextspezifische Fähigkeiten erfordern.
Die Szenarien reichen von ungefähr 1k bis 100k Tokens. Die Pipeline bezog außerdem Nutzer-Personas aus Nemotron Personas USA ein. FAR.AI beschreibt dies als ein offenes Korpus mit Millionen synthetischer Personas, die detaillierte demografische und persönlichkeitsbezogene Merkmale enthalten.
Warum die Überprüfbarkeit von Labels wichtig ist
FAR.AI definiert Täuschung als den vorsätzlichen Versuch, bei einer anderen Partei eine Überzeugung hervorzurufen, die der Agent selbst nicht für wahr hält. Die Taxonomie unterscheidet zwischen dem Verbergen der Realität vor einer anderen Partei, der sogenannten Dissimulation, und dem Darstellen einer falschen Realität, der sogenannten Simulation. Der Datensatz enthält außerdem verwirrende Formen von Nichttäuschung, die mit täuschendem Verhalten verwechselt werden könnten.
Das Unternehmen berichtet, dass Sonden, die mit subjektiven Fragen trainiert wurden, deren Antworten nur schwer zu ermitteln oder abzuleiten sind, deutlich schlechter generalisieren. Dazu gehören Fragen nach Absichten. Nach Angaben von FAR.AI stützt dieses Ergebnis die Verwendung kontextbezogener Falschaussagen als Trainingsziel bei FIBS, da sich kontextbezogene Labels anhand von Belegen in einem Szenario feststellen lassen.
Als FIBS-Sonden jedoch auf SynthDeception getestet wurden, schnitten sie bei größeren Modellgrößen in jeder Teilmenge von Fragen besser ab, auch bei Fragen nach Absichten. Die Ergebnisse verweisen auf zwei Faktoren für die Entwicklung von Sonden: die Größe des Trainingsdatensatzes und die Frage, ob sich seine Labels anhand verfügbarer Belege überprüfen lassen.