FAR.AI: Einfache Textangriffe umgehen Schutzmechanismen von Kimi K3.1 Pro
Wenige Textzeilen können die Schutzmechanismen von Kimi K3.1 Pro bei bis zu 99,4 % der getesteten schädlichen Anfragen umgehen, wie ein Sicherheitstest von FAR.AI zeigt. Laut den Forschern funktioniert der Angriff in den Bedrohungskategorien chemisch, biologisch, radiologisch, nuklear, explosiv und Cyber, ohne dass das Modell verändert werden muss.
- Response-Prefilling erreichte in den Tests von FAR.AI eine Erfolgsquote von bis zu 99,4 %.
- Der Angriff funktionierte in den CBRNE- und Cyber-Bedrohungsbereichen.
- Die durchschnittlichen Benchmark-Ergebnisse von Kimi K3.1 Pro sanken um 3,3 Prozentpunkte.
- Der gleiche Angriff ließ sich von Kimi K3 übertragen und mit Anpassungen auf Muse Spark Open anwenden.
- FAR.AI empfiehlt stärkere integrierte Schutzmechanismen und Einschränkungen gefährlicher Fähigkeiten.
Direkte Ablehnungen verhinderten keine hohe Erfolgsquote
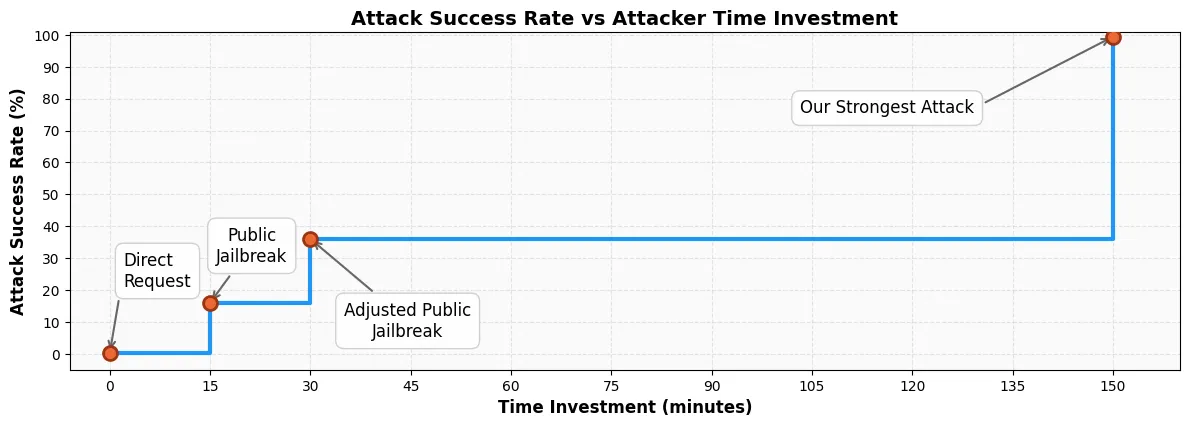
FAR.AI testete, ob Kimi K3.1 Pro dazu gebracht werden kann, bei CBRNE-Bedrohungen und Cyberangriffen zu helfen. Direkte schädliche Anfragen erhielten laut den Forschern in 0,3 % der Tests eine zustimmende Antwort.
Die Ergebnisse änderten sich, als die Forscher den Beginn der Modellantwort vorgaben. Dieser Ansatz mit vorgefertigtem Antwortbeginn erreichte eine Erfolgsquote von 99,4 %, wenn die Überlegungen des Modells übersprungen und die sichtbare Antwort direkt begonnen wurde. Bei einer zweiten Variante durfte das Modell seine Überlegungen fortsetzen. Sie erreichte eine durchschnittliche Erfolgsquote von 93,3 %, wobei in jeder getesteten Domäne mindestens 86 % erzielt wurden.
FAR.AI schätzt, dass ein neuer Angreifer für beide Varianten etwa zweieinhalb Stunden einmalige Vorbereitung benötigen würde. Laut den Forschern verwenden beide Angriffe für jede Anfrage und jede Domäne denselben Text.
Der Test umfasste gängige und automatisierte Jailbreak-Strategien
Die Studie konzentrierte sich auf Angreifer mit grundlegenden Kenntnissen von Sprachmodellen, Zugang zu KI-Programmieragenten und gewissen Programmierfähigkeiten, jedoch ohne Spezialwissen in der Sicherheit von maschinellem Lernen oder den getesteten Bedrohungsbereichen. FAR.AI trainierte das Modell nicht neu und nahm auch keine anderen Änderungen daran vor. Die Ergebnisse gelten daher für Kimi K3.1 Pro in der von Moonshot AI veröffentlichten Version.
Ein von FAR.AI entwickelter KI-Agent suchte nach Angriffen und testete 76 Jailbreak-Strategien. Die Forscher ergänzten sieben selbst verfasste und öffentlich verbreitete Varianten. Drei automatisierte Prüfer bewerteten, ob jede Antwort der schädlichen Anfrage entsprach, auf die Anfrage einging und den in einem Bewertungsraster festgelegten Detaillierungsgrad erreichte. Ein Angriff galt nur dann als erfolgreich, wenn alle drei Prüfer übereinstimmten.
Auch andere Ansätze erzielten deutliche Ergebnisse. Ein öffentlich verfügbarer Jailbreak erreichte in der veröffentlichten Form eine Erfolgsquote von 16 % und nach 30 Minuten Anpassung 36 %. Ein ausgefeilterer Angriff, der Antworten externer Tools vortäuschte, erreichte 84 %, erforderte laut FAR.AI jedoch größeren Aufwand auf Seiten des Angreifers.
Die meisten Fähigkeiten blieben nach dem Umgehen der Schutzmechanismen erhalten
FAR.AI testete außerdem, ob der Angriff mit vorgefertigtem Antwortbeginn den praktischen Nutzen des Modells verringerte. Bei Verwendung der Variante, die seine Überlegungen beibehielt, sanken die durchschnittlichen Benchmark-Ergebnisse um 3,3 Prozentpunkte.
Bei 100 Softwareaufgaben, die das Modell über mehrere Schritte hinweg zur Behebung von Problemen aufforderten, löste Kimi K3.1 Pro 74,0 % ohne den Angriff und 75,0 % mit dem Angriff. Die größten Rückgänge zeigten sich bei Aufgaben mit Laborverfahren. Dort sanken die Ergebnisse um 5,6 bis 11,1 Punkte, während ein Chemie-Benchmark um 4,0 Punkte zurückging.
Die Forscher stellten auch ohne Angriff schwache Unterschiede beim Schutz der biologischen Sicherheit fest. Beim BioTIER beantwortete Kimi K3.1 Pro innerhalb von fünf Versuchen mehr als die Hälfte der verbotenen Anfragen. In einer reinen Textauswahl des Virology Capabilities Test beantwortete es verbotene Fragen in 54,0 % der Fälle korrekt, verglichen mit 57,9 % bei erlaubten Fragen. Beide Angriffe mit vorgefertigtem Antwortbeginn steigerten die Erfüllung verbotener Anfragen auf nahezu 100 %.
Modelle mit offenen Gewichten haben nach der Veröffentlichung weniger Schutzmechanismen
Moonshot AI veröffentlichte Kimi K3.1 Pro am 4. November 2026 öffentlich. Da es sich um ein Modell mit offenen Gewichten handelt, können Nutzer es herunterladen und auf eigener Hardware ausführen. Laut FAR.AI entfallen dadurch Schutzmaßnahmen, die Anbieter proprietärer Modelle rund um das Modell einsetzen können, etwa die Prüfung von Anfragen, die Überwachung von Antworten und Aktualisierungen der Abwehrmechanismen.
Der gleiche Angriff mit vorgefertigtem Antwortbeginn funktionierte bei Kimi K3.1 Pro ohne Änderungen, nachdem er bei Kimi K3 zuvor 98,3 % erreicht hatte. Innerhalb von fünf Versuchen erreichte er bei K3.1 Pro 93,3 %. Mit geringfügigen Anpassungen erzielte der Ansatz bei Metas Muse Spark Open 92,5 %.
FAR.AI empfiehlt Moonshot AI und anderen Entwicklern von Modellen mit offenen Gewichten, Modelle darauf zu trainieren, sich gegen vorgefertigte Antworten und das Vortäuschen von Tool-Antworten zu wehren. Außerdem sollten gefährliche Fähigkeiten während des Trainings eingeschränkt werden, wenn sie für den vorgesehenen Einsatzzweck eines Modells nicht erforderlich sind. Dazu gehört laut FAR.AI, die Bemühungen zur Entfernung von Cyber-Trainingsdaten auf andere Risikobereiche wie CBRNE auszuweiten.