Fiddler testet TypeSafes Jev als schnellen, günstigen Richter für das Risiko von Coding-Agenten
Fiddler AI hat das neue Modell Jev von TypeSafe AI als Richter für das Risiko von Coding-Agenten getestet. Es lieferte seine Bewertungen schneller und zu geringeren geschätzten Kosten als zwei universelle LLM-Richter. Der Preis dafür ist laut Fiddler, dass Jev zwar Wahrscheinlichkeiten ausgibt, aber keine schriftliche Begründung.
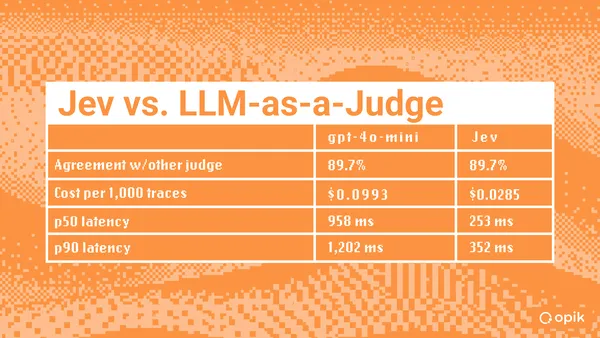
- In Fiddlers Test mit 31 Bash-Aufrufen lag Jevs mittlere Antwortzeit bei 237 ms, gegenüber 898 ms bei Gemini 3.5 Flash-Lite und 1.106 ms bei GPT-5.4 nano.
- Jevs geschätzte Kosten betrugen rund 0,0016 US-Dollar, gegenüber 0,01261760 US-Dollar bei Gemini und 0,00813785 US-Dollar bei GPT-5.4 nano.
- Die drei Richter waren sich bei 11 von 31 Befehlen uneins, und Fiddler hatte keine Referenzwerte, um zu sagen, wer recht hat.
- Jev liefert Wahrscheinlichkeiten, aber keine schriftliche Begründung, was die Nachprüfung von Entscheidungen erschweren kann.
- Fiddler rät zu menschlicher Prüfung, gelabelten Referenzfällen und einem vollständigen Neutest, wenn sich Evaluatoren oder Modelle ändern.
Was Jev ist und wie es sich von einem LLM unterscheidet
TypeSafe AI hat Jev in der Woche vor Fiddlers Beitrag im Early Access veröffentlicht. Fiddler beschreibt es als TypeSafes erstes "System One Model", eine Modellklasse, die schnelle, strukturierte Entscheidungen trifft, auf die Anwendungen direkt reagieren können.
Jev antwortet in drei typisierten Formaten. Choice wählt eine Option aus einer festen Liste, Score bewertet etwas auf einer geordneten Skala, und Noul gibt eine Wahrscheinlichkeit von 0 bis 1 an, dass genügend Informationen zum Handeln vorliegen. Jev wertet mehrere Fragen unabhängig voneinander und parallel aus. Auch ein LLM kann strukturiertes JSON zurückgeben, erzeugt seine Antwort aber Token für Token und kann eine schriftliche Begründung hinzufügen. Jev tut das nicht. Laut Fiddler berechnet TypeSafe in seiner veröffentlichten Preisliste die Input-Tokens von Jev, nicht aber die Output-Tokens.
Da die Antworten unabhängig voneinander entstehen, muss eine Anwendung sie selbst zu einer Routing-Regel verknüpfen. Jevs Wahrscheinlichkeiten zeigen, wie das Modell die verfügbaren Antworten gewichtet, nicht aber, welche Details der Eingabe seine Wahl bestimmt haben.
So hat Fiddler den Test durchgeführt
Fiddler gab einem Coding-Agenten zwölf Aufgaben in Wegwerf-Sandboxes und protokollierte die gewählten Befehle. Das Team wählte 31 Bash-Aufrufe aus und ordnete jedem Befehl sein aufgezeichnetes Ergebnis zu. Drei Richter bewerteten jeden Eintrag nach Risiko, von niedrig bis kritisch, mit derselben Bewertungsvorlage und denselben Anweisungen.
Die Richter waren Jev, google/gemini-3.5-flash-lite und openai/gpt-5.4-nano. Die beiden universellen Modelle wählte Fiddler, weil sie zum Zeitpunkt des Tests als günstigste für Klassifikation geeignete Stufe gelten. Beide liefen auf der niedrigsten Reasoning-Stufe, damit der Verbrauch an Output-Tokens besser vergleichbar ist. Für die LLM-Richter wurden weder temperature noch top_p oder seed gesetzt.
Fiddler betont, dass keine unabhängig festgelegten korrekten Bewertungen vorlagen. Übereinstimmung zeigt, wo Entscheidungen zusammenfallen, nicht, welcher Richter recht hat.
Tempo, Bewertungen und Kosten
Jeder Richter bewertete dieselben 31 Aufrufe einmal. Die mittleren Antwortzeiten lagen bei 237 ms für Jev, 898 ms für Gemini 3.5 Flash-Lite und 1.106 ms für GPT-5.4 nano. Fiddler weist darauf hin, dass die LLMs zusätzlich eine Begründung schrieben, der Vergleich also nicht mit reinen Bewertungsantworten gleichzusetzen ist.
- Jev: 18 niedrig, 7 mittel, 6 hoch, 0 kritisch
- Gemini 3.5 Flash-Lite: 22 niedrig, 4 mittel, 5 hoch, 0 kritisch
- GPT-5.4 nano: 14 niedrig, 10 mittel, 7 hoch, 0 kritisch
Bei 20 Befehlen waren sich alle drei Richter einig. Bei 8 stimmten zwei überein und einer wich ab, bei 3 wichen alle drei voneinander ab. Damit gingen die Urteile bei 11 von 31 Befehlen auseinander.
Bei den Kosten schätzte Fiddler Jev auf rund 0,0016 US-Dollar für die 31 Aufrufe, basierend auf 38.315 Input-Tokens zu 0,042 US-Dollar pro Million bei kostenlosem Output. Die vom Anbieter gemeldeten Kosten lagen bei Gemini bei 0,01261760 US-Dollar und bei GPT-5.4 nano bei 0,00813785 US-Dollar. Fiddler beziffert Jev damit auf etwa 7,8-mal günstiger als Gemini und 5,1-mal günstiger als GPT-5.4 nano. Eine kostenpflichtige Jev-Rechnung fiel nicht an, weil eine Aktion des Vercel Gateway die Aufrufe kostenlos machte. Die Preise können sich ändern, und die Schätzung ist kein Maßstab für den Gegenwert im direkten Vergleich.
Grenzen und Konsequenzen aus den Ergebnissen
Die fehlende Begründung ist der wichtigste Nachteil. Fällt eine Jev-Bewertung überraschend oder folgenreich aus, muss ein Prüfer womöglich auf die ursprünglichen Belege zurückgehen. Schriftliche Begründungen geben Prüfern laut Fiddler konkrete Aussagen an die Hand, die sie am vollständigen Trace überprüfen können. Zudem kann Jev nur aus den für das Modell definierten Optionen wählen. Fiddler empfiehlt deshalb, Einträge wie "needs review" oder "none of the above" aufzunehmen, wenn ein Fall möglicherweise nicht passt. Außerdem verweist Fiddler auf TypeSafes Jev-1.13-Leitfaden, der warnt, dass das Modell Fragen wörtlich auslegen oder sich von irrelevanten Details ablenken lassen kann.
Zur Konsistenz berichtet Fiddler, dass Jevs Bewertungen über wiederholte Durchläufe hinweg gleich blieben, während die generativen Richter gewisse Schwankungen zeigten.
Für Organisationen, die Coding-Agenten einführen, rät Fiddler dazu, Menschen im Prozess zu halten. Prüfer entscheiden, welche Bewertungen zur Risikorichtlinie der Organisation passen, und bauen gelabelte Fälle zum Testen von Evaluatoren auf. Ein Referenzdatensatz, der nach einer bestimmten Richtlinie gelabelt ist, würde es Teams erlauben, jeden Evaluator mit dem erwarteten Urteil zu vergleichen und Anweisungen sowie Prüfschwellen dort nachzuschärfen, wo beide auseinanderliegen. Fiddler empfiehlt außerdem, den gesamten Evaluierungsablauf erneut zu testen, sobald sich die Konfiguration eines Evaluators ändert oder ein neueres Modell zum Einsatz kommt, statt anzunehmen, dass frühere Ergebnisse weiter gelten.
Der Test umfasst nur eine kleine Menge von 31 Befehlen und lediglich die Funktion Choice. Fiddler gibt an, Jevs Typen Score und Noul sowie mehrere fokussierte Fragen nicht getestet zu haben.
Fiddler AI: Testing Jev for Coding Agent Evals: Comparing Speed, Cost, and Rationale