Jev-Modell stimmt bei 897 von 1.000 Gesprächsrunden mit gpt-4o-mini-Judge überein, bei geringeren Kosten
Ein Modell, das bei Ja/Nein-Fragen Wahrscheinlichkeiten ausgibt, statt Text zu schreiben, war bei 1.000 realen Produktionsrunden 3,5-mal günstiger und 3,8-mal schneller als ein gpt-4o-mini-Judge, so Comet. Die beiden Judges stimmten in 897 dieser Runden überein.
- Bei 1.000 realen Ollie-Gesprächsrunden stimmten Jev und ein gpt-4o-mini-Judge in 897 Fällen (89,7 %) überein.
- Jev kostete $0,0285 pro 1.000 Traces gegenüber $0,0993, bei einer p50-Latenz von 253 ms gegenüber 958 ms.
- Jev wird mit $0,042 pro Million Tokens abgerechnet und gibt eine Wahrscheinlichkeit statt generierten Texts aus.
- Abweichungen häuften sich dort, wo Jevs Wahrscheinlichkeit im mittleren Bereich lag; im Band von 0,4 bis 0,6 sank die Übereinstimmung auf 63,5 %.
- Comet stellte nicht fest, welcher Judge richtig lag, da dafür gelabelte Daten und eine schriftlich festgelegte Richtlinie zum Anwendungsbereich nötig sind.
Was Jev ist und wie es sich von LLM-as-a-Judge unterscheidet
Teams, die ein LLM in der Produktion betreiben, bewerten ihren Traffic meist mit einem LLM-as-a-Judge-Ansatz: Jeder Austausch geht an ein Frontier-Modell, aus dessen Antwort ein Urteil herausgelesen wird. Comet nennt dabei zwei Probleme. Die Preise für Frontier-Modelle zwingen die meisten Teams dazu, ihren Traffic nur stichprobenartig zu prüfen, sodass seltene Fehler im unbewerteten Teil untergehen können. Und nur wenige Teams überprüfen, ob der Judge selbst richtig liegt, bevor sie seinem Dashboard vertrauen.
Jev von TypeSafe AI zielt auf das erste Problem. Das Modell beantwortet typisierte Fragen zu einem Text, statt über ihn zu schreiben. Bekommt es eine Nutzernachricht und eine Antwort und soll beurteilen, ob die Antwort die Frage beantwortet hat, liefert es eine Wahrscheinlichkeit statt eines Absatzes. Laut Comet muss dadurch nichts geparst, kein Schema erzwungen und weder Temperature noch Seed festgelegt werden. Abgerechnet werden nur die gelesenen Tokens, zu $0,042 pro Million.
Comet sieht in dem Ansatz ein bekanntes Muster: Embeddings wanderten zu kleinen spezialisierten Encodern, Reranking zu Cross-Encodern und Moderation zu Klassifikatoren wie Llama Guard. Jev ist das erste Modell dieser Art, das Opik, die Open-Source-Plattform von Comet für LLM-Observability und -Evaluierung, direkt unterstützt.
Der Test mit Ollie
Comet führte den Vergleich mit Ollie durch, einem KI-Assistenten in Opik, der Traces liest und analysiert, Probleme diagnostiziert und Korrekturen vorschlägt. Für Ollie gab es bereits eine LLM-J-Regel auf Basis von openai/gpt-4o-mini, die bewertete, ob eine Antwort den Nutzer erreicht. Das Team zog 1.000 reale Gesprächsrunden aus 578 Threads seines Produktions-Monitoring-Projekts und loggte sie in einem eigenen Projekt erneut ein, sodass beide Judges dieselben Runden bewerteten, ohne die Live-Traces anzutasten. Beide liefen als Online-Regeln mit 100 % Sampling, mit einem booleschen Score und derselben Frage: "The answer addresses the question that was asked."
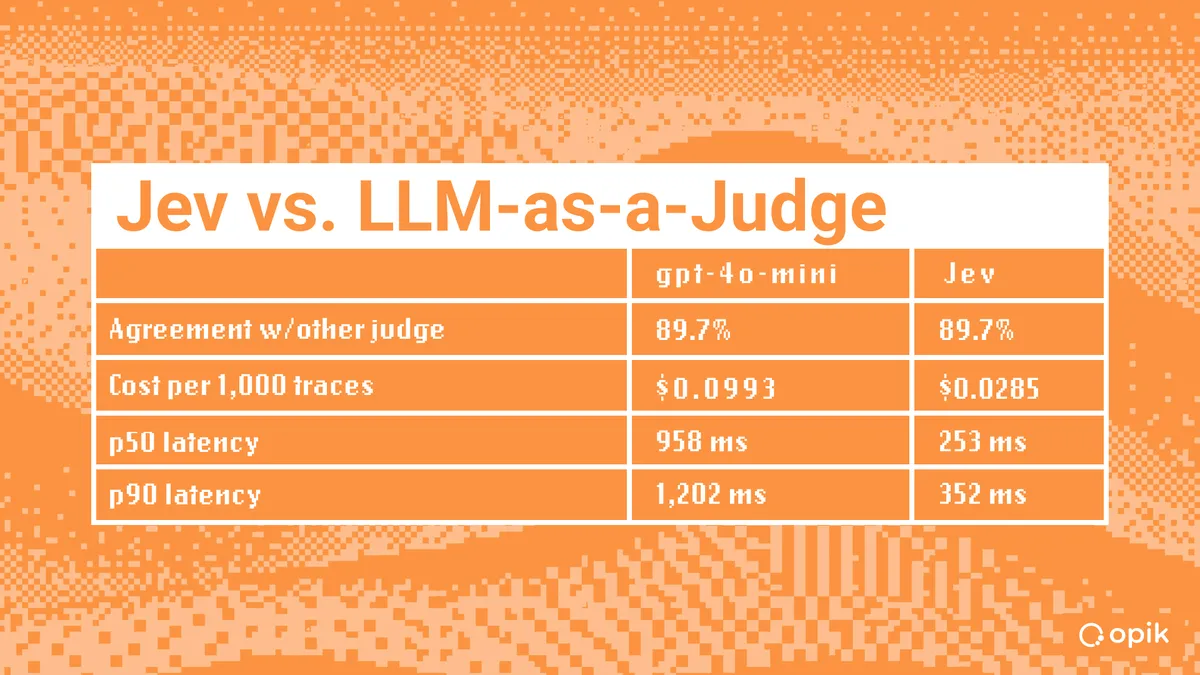
- Übereinstimmung mit dem jeweils anderen Judge: 89,7 % bei gpt-4o-mini und Jev
- Kosten pro 1.000 Traces: $0,0993 bei gpt-4o-mini, $0,0285 bei Jev
- p50-Latenz: 958 ms bei gpt-4o-mini, 253 ms bei Jev
- p90-Latenz: 1.202 ms bei gpt-4o-mini, 352 ms bei Jev
Jev war im Median günstiger und schneller, obwohl es 1,5-mal so viele Input-Tokens verarbeitete, weil die Decisions API die Fragestruktur zusammen mit dem Text kodiert, so Comet. Bei diesem Preis, schreibt das Unternehmen, wird die Bewertung von 100 % des Traffics zum Standard statt zu etwas, wofür man erst argumentieren muss.
Wo die Judges uneins waren
Die 103 Runden, in denen die Judges auseinanderlagen, häuften sich dort, wo Jev selbst unsicher war. Davon lagen 64,1 % bei Jevs Wahrscheinlichkeit zwischen 0,3 und 0,7, bei den übereinstimmenden Runden waren es 16,7 %. Sortiert man die Runden nach Jevs Konfidenz, ergibt sich ein U-förmiges Muster: Unter 0,2 stimmten die Judges zu 100 % überein (n=118), über 0,8 zu 95,6 % (n=568), im Bereich von 0,4 bis 0,6 sank die Übereinstimmung auf 63,5 % (n=115).
Jevs Ausgaben waren sicher, aber nicht binär: 568 von 1.000 lagen über 0,8, 115 im Bereich von 0,4 bis 0,6, verteilt auf 97 verschiedene Werte. Comet schlägt vor, das mittlere Band als Prüfwarteschlange zu nutzen, die an einen Menschen geht, statt blind zu samplen. Ein Judge, der nur wahr oder falsch ausgibt, kann eine sichere Entscheidung nicht von einem Münzwurf unterscheiden.
Comet benennt eine Grenze ausdrücklich: Es wurde nicht festgestellt, welcher Judge recht hatte. Dafür braucht es gelabelte Daten, und beim Labeln stellte sich die Frage, wo Ollies Zuständigkeit endet. Die gemeinsame Frage wertete eine höfliche Ablehnung bereits als Fehlschlag. Bevor man einen Judge evaluiert, so das Unternehmen, muss jemand die Richtlinie aufschreiben, an der er messen soll.
Jev in Opik nutzen
Comet beschreibt drei Integrationspunkte. Erstens eine native Tracing-Integration, da der typesafe-sdk-Client nicht OpenAI-kompatibel ist: Jeder system_one-Aufruf wird zu einem LLM-Span mit Zustand und Fragen als Input, Antworten als Output sowie Token-Verbrauch, Provider und Kosten.
Zweitens lässt sich Jev unter dem OpenRouter-Provider mit dem vorhandenen Schlüssel des Workspaces als Modell hinter einer Online-LLM-as-a-Judge-Regel auswählen. Das Modell heißt typesafe/jev-1.13, der Evaluations-Span hält die ausgelieferte Version fest, typesafe/jev-1.13-20260917. Der Prompt enthält nur die Daten (INPUT und OUTPUT), die Beschreibung jedes Scores ist die Frage. Unterstützt werden nur boolesche Scores. Eine Wahrscheinlichkeit ab 0,5 speichert eine 1, und die Wahrscheinlichkeit wird in der Begründung abgelegt, damit sich der Schwellenwert später überprüfen lässt.
Drittens: Da Jev weder Temperature noch Few-Shot-Beispiele kennt, ist die Formulierung der Frage die gesamte Konfigurationsfläche. Der Agent Optimizer von Opik kann diese Formulierung anhand eines gelabelten Datensatzes iterativ verbessern, mit der Übereinstimmung mit dem Label als Metrik.
Was das für Teams bedeutet
Laut Comet passt Jev dort, wo eine Zahl das ganze Produkt ist. Es liefert keine schriftliche Kritik, keine Tool-Aufrufe, keine nicht-booleschen Scores und keine Bewertungen auf Thread-Ebene. Liest ein Mensch die Begründung, rät das Unternehmen zu einem generativen Judge; speist der Score ein Dashboard, einen Filter oder eine Weiterleitung, genügt eine Wahrscheinlichkeit.
Comet versteht die übergeordnete Erkenntnis nicht als "Jev einführen", sondern als wiederholbare Methode: auf dem eigenen Traffic testen, ob ein neues Modell die Aufgabe besser erledigt, wobei beide Judges dieselben Traces sehen und Kosten und Latenz neben den Urteilen erfasst werden. Liegt ein Modell nah dran, aber nicht ganz richtig, empfiehlt das Unternehmen, die Frage zu schärfen, und falls das nicht reicht, mit den gelabelten Daten ein eigenes Modell zu trainieren.
Comet: Jev vs. LLM-as-a-Judge for AI Evals