Jev: System-One-Modell zielt auf schnelle Ja-Nein-Entscheidungen, die LLMs nur langsam treffen
Das AI-Literacy-Team von Amii hat einen Erklärtext zu Jev veröffentlicht, einem Modell von TypeSafe AI, das schnelle, strukturierte Entscheidungen mit Wahrscheinlichkeiten treffen soll, statt Text zu generieren. Laut Amii eignet es sich für kleine, wiederkehrende Urteile, etwa ob eine E-Mail Spam ist, also für Aufgaben, für die ein großes Sprachmodell überdimensioniert ist.
- Jev ist ein System-One-Modell von TypeSafe AI, das statt generierten Texts strukturierte Entscheidungen mit Wahrscheinlichkeiten liefert.
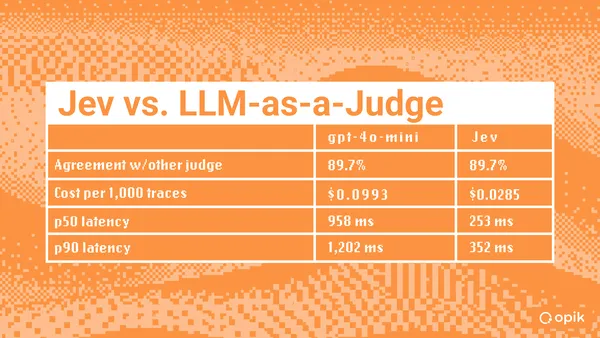
- Amiis Tabelle nennt Antwortzeiten von 70 ms bis 500 ms für Jev gegenüber 3 bis 329 Sekunden bei LLMs sowie Input-Tokens für 0,042 $ gegenüber 0,20 bis 10 $.
- Jev bietet drei Entscheidungsprimitive: Choice, Score und eine Ja-Nein-Bedingung.
- TypeSafe behauptet, Jev könne nicht halluzinieren, weil seine Ausgaben vordefiniert sind, doch Amii weist darauf hin, dass es trotzdem falsch liegen kann.
- Vorgeschlagene Einsatzfelder sind Support-Routing, Feedback-Triage, Fragen von Lernenden und die Tool-Auswahl für Agenten.
Ein System-One-Modell für kleine Entscheidungen
Amii argumentiert, dass große Sprachmodelle wie Claude oder ChatGPT oft für kleine, wiederkehrende Entscheidungen eingesetzt werden, obwohl das unnötig ist. Der Vergleich: Für jede Kleinigkeit ein LLM zu bemühen, sei, als würde man "Einstein engagieren, um die Glühbirne zu wechseln". Typische Beispiele sind die Frage an einen Agenten, ob eine Nachricht Spam ist oder ob eine E-Mail eine Antwort braucht.
Jev ist für solche kurzen Ja-Nein-Fragen konzipiert. Amii beschreibt es als System-One-Modell, also als Modell für schnelle, automatische, im Kern intuitive Entscheidungen innerhalb eines größeren Workflows, und beruft sich dabei auf TypeSafe AI (2026). Seine Aufgabe sei nicht, menschenähnliches Denken nachzuahmen, sondern schnelle Entscheidungen zu liefern, jeweils mit Wahrscheinlichkeits- und Konfidenzwert.
Jev im Vergleich zu LLMs
Beide erhalten denselben Kontext, doch Jev gibt strukturierte Werte aus, während ein LLM generierten Text ausgibt. Amiis Vergleichstabelle nennt Folgendes:
- Antwortzeit: 70 ms bis 500 ms bei Jev, 3 bis 329 Sekunden bei LLMs.
- Input-Tokens: 0,042 $ bei Jev, 0,20 bis 10 $ bei LLMs.
- Sampling: Jev sampelt parallel und erzeugt alle Ausgaben in einer einzigen Abfrage, LLMs generieren ein Token nach dem anderen.
- Trainingsansatz: Reinforcement Learning for Calibrated Decisions (RLCD) bei Jev, Reinforcement Learning with Human Feedback (RLHF) bei LLMs.
Jev unterstützt drei Entscheidungsprimitive. Eine Choice wählt aus bekannten Optionen aus, etwa bei der Zuordnung zu einem Team. Ein Score ordnet die Eingabe auf einer geordneten Skala ein, zum Beispiel niedrig, mittel oder hoch. Das dritte, im Artikel als Noul bezeichnet, prüft eine Ja-Nein-Bedingung und gibt die Wahrscheinlichkeit zurück, dass sie zutrifft.
Kalibrierte Wahrscheinlichkeiten und die Behauptung, es halluziniere nicht
Die Ausgaben lassen sich direkt in Software einspeisen, die Informationen klassifiziert, Aufgaben priorisiert oder den nächsten Schritt auswählt. Weil Jev Wahrscheinlichkeiten liefert, kann eine Anwendung automatisch handeln, wenn die Beleglage stark ist, und bei Unsicherheit einen Menschen oder ein anderes Modell hinzuziehen.
Amii erklärt, dass Wahrscheinlichkeiten nur dann aussagekräftig sind, wenn sie kalibriert sind: Von vielen Vorhersagen mit 80 Prozent sollte das vorhergesagte Ergebnis in etwa 80 Prozent der Fälle eintreten. TypeSafe AI hat Jev auf dieses Ziel hin trainiert, doch Amii betont, dass Kalibrierung nicht garantiert, dass jede einzelne Entscheidung richtig ist.
In einer Demo zur E-Mail-Triage wies Jev einer Beispielnachricht eine Wahrscheinlichkeit von 78 Prozent für ein Meeting, 14 Prozent für eine Anfrage und 8 Prozent für Spam zu. 80 Prozent entfielen auf die Bearbeitung in dieser Woche, 70 Prozent auf die Wahrscheinlichkeit, dass eine Antwort nötig ist.
Laut Amii ist eine der stärksten Behauptungen von TypeSafe, dass Jev nicht halluzinieren kann. Die Begründung: Die Ausgaben sind im Voraus festgelegt, daher kann es keine fünfte E-Mail-Kategorie erfinden. Amii vergleicht das mit einer Multiple-Choice-Frage: Ein Schüler kann keine Option E erfinden, aber trotzdem die falsche Antwort wählen. Jev könnte etwa eine Meeting-Anfrage als Spam einstufen und dabei dennoch eine gültige Ausgabe erzeugen.
Mögliche Einsatzfelder
Laut Amii ist Jev vor allem dann relevant, wenn eine Aufgabe darin besteht, Informationen wiederholt anhand klar definierter Optionen oder Kriterien zu bewerten. Genannt werden vier Bereiche:
- Kundensupport: Anfragen klassifizieren und an das richtige Team weiterleiten.
- Projektmanagement: Feedback kategorisieren, die Dringlichkeit von Tickets bewerten und Nachrichten markieren, die nachverfolgt werden müssen.
- Aus- und Weiterbildung: Fragen von Lernenden nach Thema klassifizieren oder Antworten zur Prüfung durch Lehrende markieren.
- Softwareentwicklung: entscheiden, ob ein Agent Dokumente durchsuchen, eine Datenbank abfragen, ein Tool aufrufen oder eine Anfrage an ein leistungsfähigeres Reasoning-Modell weitergeben soll.
Für Teams mit automatisierten Workflows lautet die Botschaft des Artikels, dass Routineklassifizierung und Routing nicht immer über ein vollwertiges LLM laufen müssen. Die Angaben zu Geschwindigkeit und Preis stammen aus Amiis Vergleichstabelle, und der Artikel selbst warnt, dass gültige Ausgaben nicht zwangsläufig richtige sind.