Fireworks AI startet FireRouter mit Opus und senkt Coding-Kosten um 57 Prozent
Fireworks AI hat FireRouter mit Opus vorgestellt, einen cachebewussten Router, der jeden Coding-Schritt an das dafür am besten geeignete Modell weiterleitet. Laut Unternehmen erreicht er 98,1 Prozent der Genauigkeit von Opus allein und arbeitet dabei 57 Prozent günstiger.
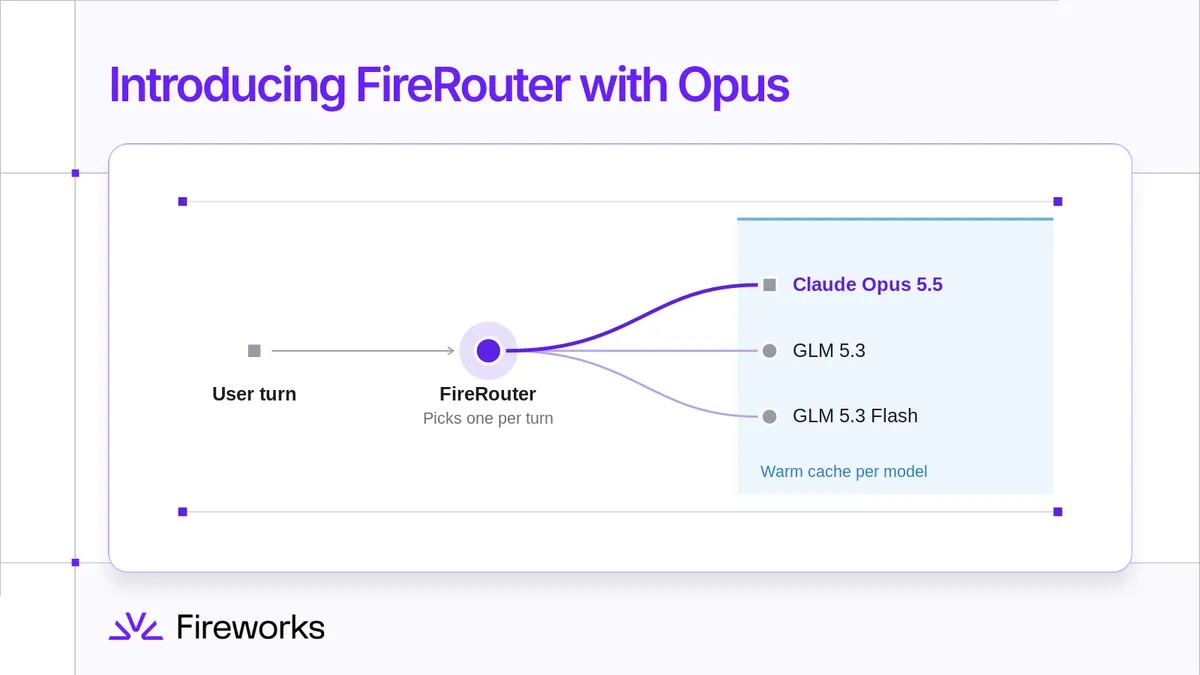
- FireRouter mit Opus routet zwischen Claude Opus 5.5, GLM 5.3 und GLM 5.3 Flash.
- Fireworks meldet 98,1 % der Genauigkeit von reinem Opus bei 57 % geringeren Kosten pro Sitzung, von 15,36 auf 6,63 US-Dollar.
- Die Cache-Trefferquote lag bei 94,2 % gegenüber 97,8 % bei Opus allein, laut Fireworks ein bewusster Kompromiss.
- Verfügbar als Serverless-Endpunkt und in Harnesses wie Claude Code, Codex und Cursor IDE.
Das leistet FireRouter mit Opus
FireRouter mit Opus ist auf die Opus-Familie optimiert und steht ab sofort in der Fireworks CLI sowie erstmals als eigenständiges Router-Modell zur Verfügung. Laut Fireworks kann jedes Fireworks-Konto es wie jedes andere Modell als Serverless-Endpunkt ansprechen.
Der Router ist Teil von Fireworks Nexus. Damit können Engineering-Teams nach Angaben des Unternehmens führende offene Modelle in die Harnesses einbinden, die sie ohnehin nutzen, und ihre Ausgaben halbieren, ohne bei Geschwindigkeit oder Qualität Abstriche zu machen. Fireworks bezeichnet FireRouter als den ersten cachebewussten Router am Markt.
Derzeit wird jeder Nutzerschritt zwischen Claude Opus 5.5, GLM 5.3 und GLM 5.3 Flash verteilt. Fireworks zufolge wird sich die Modellauswahl ändern, sobald neue Modelle und Versionen erscheinen.
So funktioniert das Routing
Jeder Nutzerschritt, der bei FireRouter ankommt, wird daraufhin bewertet, wie gut die einzelnen Modelle der Auswahl zur Aufgabe passen. Anschließend schätzt der Router, was es kosten würde, wenn das jeweilige Modell den Schritt übernimmt. In diese Schätzung fließen die Kosten des Prompt-Caches ein und die Frage, ob es sich lohnt, den Cache durch den Wechsel auf ein anderes Modell zu verlieren.
Am Ende leitet er den Schritt an das Modell weiter, das Qualität und Kosten am besten ausbalanciert. Die Cache-Awareness ist dabei der zentrale Gedanke: Ein günstigeres Modell wird nur gewählt, wenn die Ersparnis den Preis für den Verlust des zwischengespeicherten Kontexts übersteigt.
Testergebnisse laut Fireworks
Fireworks führte über mehr als einen Monat interne A/B-Tests durch. Interne Coding-Sitzungen wurden zufällig entweder FireRouter mit Opus oder einer reinen Opus-Kontrollgruppe zugewiesen, bei denselben Workloads und Nutzern.
- Kosten: Die Kosten pro Sitzung sanken um 57 % (±19 Prozentpunkte), von 15,36 auf 6,63 US-Dollar.
- Genauigkeit: FireRouter mit Opus erzielte bei bewerteten Schritten 78,7 % gegenüber 80,2 % bei reinem Opus, also 98,1 % der Gesamtgenauigkeit.
- Cache-Treffer: Die Trefferquote lag mit FireRouter und Opus bei 94,2 %, mit Opus allein bei 97,8 %.
Zur Bewertung der Genauigkeit prüfte Fireworks, ob der Agent die Arbeit abgeschlossen hat, ob die richtige Antwort erreicht wurde und ob der Nutzer im nächsten Schritt Korrekturen vornehmen musste. Die niedrigere Cache-Trefferquote bezeichnet das Unternehmen als kleinen, bewussten Kompromiss, der die Gesamtkosten erheblich gesenkt habe. Außerdem weist es darauf hin, dass der Großteil des Traffics aus interner Coding-Arbeit stammte, bei der offene Modelle viele Routineschritte bewältigen konnten.
Verfügbarkeit und Bedeutung für Teams
FireRouter mit Opus ist in mehreren Harnesses verfügbar, darunter Claude Code, Codex und Cursor IDE. Um es mit Claude Code auszuprobieren, melden sich Nutzer mit fireconnect login an und führen dann fireconnect claude --model firerouter/opus aus. Fireworks zufolge zeigt die Anmeldung auf der Plattform zudem die geschätzten Einsparungen bei den Claude-Opus-Ausgaben eines Teams an.
Für Teams, die bei Coding-Agenten stark auf Opus setzen, deuten die berichteten Ergebnisse darauf hin, dass sich Routineschritte mit geringem Genauigkeitsverlust von günstigeren offenen Modellen erledigen lassen. Die Zahlen stammen aus dem eigenen internen Traffic von Fireworks, bei anderen Workloads können die Ergebnisse abweichen.
Fireworks AI: Introducing FireRouter with Opus