GLM 5.3
Entwickler nutzen mehr Modelle und eigene Hardware
Entwicklungsteams verteilen ihre Arbeit auf eine wachsende Zahl von Modellfamilien und führen mehr Aufgaben auf eigener Hardware aus. Laut Kilo Code treiben Kosten…
DigitalOcean macht Prompt Caching für Serverless Inference allgemein verfügbar
DigitalOcean hat Prompt Caching auf seiner Plattform Serverless Inference allgemein verfügbar gemacht. Gecachte Eingaben werden mit bis zu 90 % Rabatt abgerechnet, die…
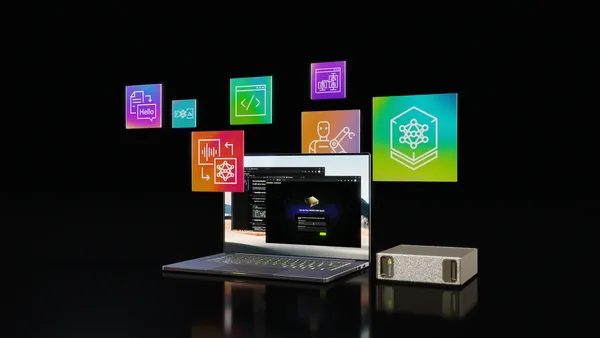
NVIDIA DGX Spark: Offizielle Acht-Knoten-Cluster mit 1 TB Speicher
NVIDIA hat die offizielle Unterstützung für Acht-Knoten-Cluster mit DGX Spark angekündigt. Damit steigt der Unified Memory auf 1 TB, und Entwickler können Modelle der…
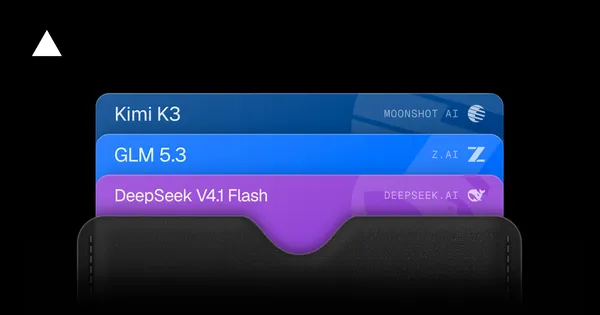
Vercel nimmt DeepSeek V4.1 Flash in sein Abo Token Pass auf
Vercel hat DeepSeek V4.1 Flash in Token Pass aufgenommen, sein über AI Gateway laufendes Abo für Pro-Teams. Das Modell reiht sich neben Kimi K3 und GLM 5.3 ein, weitere…
Goodfire: Sonden-basierte Cyber-Monitore schlagen LLM-Judge bei 50-fach geringeren Kosten
Goodfire Research hat nach eigenen Angaben Cybersicherheits-Monitore für Kimi K3 und GLM 5.3 entwickelt, die einen LLM-Judge bei rund 50-fach geringeren Kosten…
GitLab Transcend: zielgesteuerte Flows, Orbit und Artifact Central für agentenbasierte Softwareauslieferung
GitLab hat auf seiner Veranstaltung Transcend mehr als ein Dutzend neue Funktionen für agentenbasiertes Software Engineering vorgestellt, darunter zielgesteuerte Flows…
GLM 5.3 von Z.ai ist auf Amazon Bedrock als verwaltete API verfügbar
Amazon Web Services stellt GLM 5.3, ein Open-Weight-Modell von Z.ai (Zhipu AI), über vollständig verwaltete APIs auf Amazon Bedrock bereit. Laut AWS steht der Zugang…
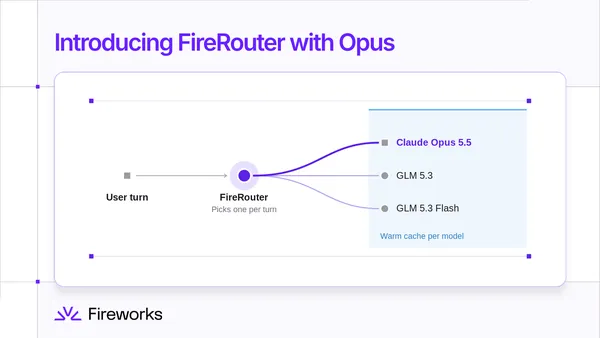
Fireworks AI startet FireRouter mit Opus und senkt Coding-Kosten um 57 Prozent
Fireworks AI hat FireRouter mit Opus vorgestellt, einen cachebewussten Router, der jeden Coding-Schritt an das dafür am besten geeignete Modell weiterleitet. Laut…