Forethought: Automatisierung der KI-Alignment-Forschung gliedert sich in drei unterschiedliche Typen
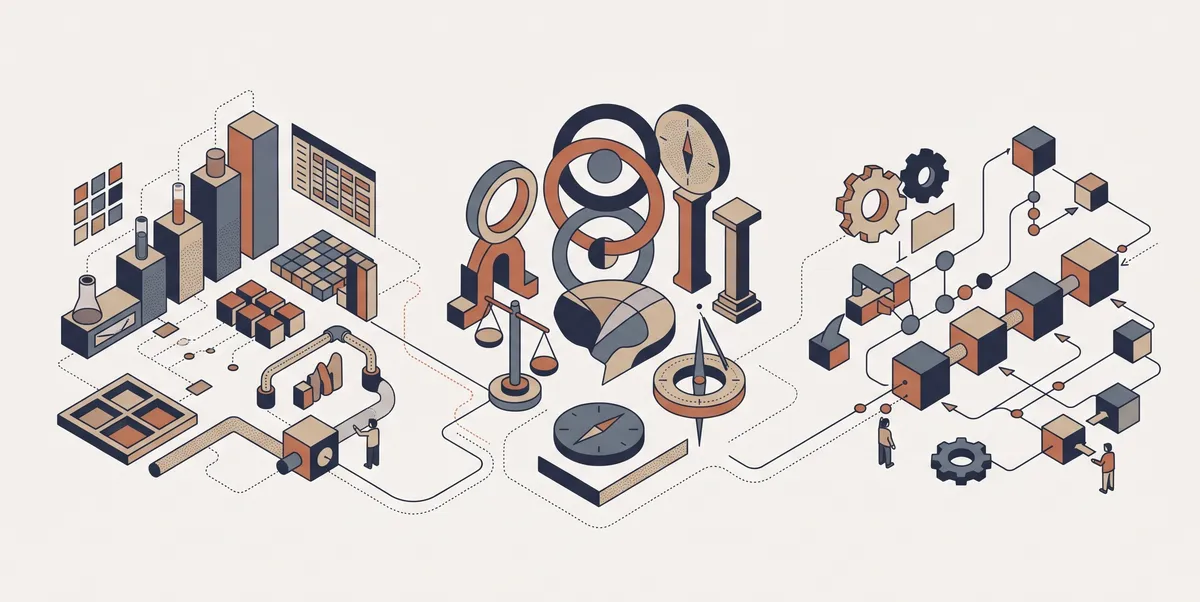
Owen Cotton-Barratt von Forethought argumentiert, dass die Bemühungen zur Automatisierung von KI-Alignment in drei Kategorien unterteilt werden sollten: empirische Forschung, konzeptionelle Forschung und direkte Alignment-Arbeit. In einem Beitrag vom 4. November 2026 schreibt er, die Kategorien unterschieden sich darin, was die Automatisierung erfordert, was sie bewirkt und wie viel Schaden subtile Fehlausrichtung anrichten könnte.
- Owen Cotton-Barratt von Forethought unterteilt automatisierte Alignment-Arbeit in empirische Forschung, konzeptionelle Forschung und direkte Alignment-Arbeit.
- Empirische Alignment-Forschung passt am besten zu den aktuellen KI-Fähigkeiten und überlappt stark mit der Automatisierung der Capabilities-Forschung, weshalb ihre Beschleunigung keine Priorität sei.
- Konzeptioneller Forschung fehlt ein überprüfbares Signal für Fortschritt, doch ihre beschleunigte Automatisierung hält er, wenn möglich, wahrscheinlich für gut.
- Direkte Alignment-Arbeit beschreibt er als Ingenieurwesen, etwa mit RLAIF und der Überwachung des Trainings.
- Ziel des Beitrags ist es, Katastrophen lange genug zu vermeiden, um konzeptionelle Alignment-Forschung in sehr hoher Qualität zu automatisieren.
Drei Bereiche mit unterschiedlichen Anforderungen
Die erste Kategorie, empirische Alignment-Forschung, definiert Cotton-Barratt als Entwurf und Durchführung alignmentrelevanter Experimente für eine gegebene Vorstellung davon, was die Forschenden anstreben. Konzeptionelle Alignment-Forschung ist die theoretische oder urteilsgestützte Arbeit, die das Verständnis des Ziels und des Wegs dorthin verbessert, einschließlich der Frage, wie man es misst. Direkte Alignment-Arbeit bedeutet, konkrete KI-Systeme besser auszurichten, auch über Inputs wie Trainingsdaten.
Diese Bereiche seien sich "tatsächlich ziemlich unähnlich", schreibt er, was die Anforderungen an die Automatisierung, ihre Auswirkungen und den möglichen Schaden durch subtile Fehlausrichtung in den automatisierten Systemen angehe. Deshalb sollten sie seiner Ansicht nach getrennt betrachtet werden.
Empirische Arbeit passt natürlich, konzeptionelle ist schwieriger
Laut dem Beitrag passt die empirische Alignment-Forschung am besten zu den KI-Fähigkeiten, die gerade entstehen. Ein KI-Agent könne bereits ein Experiment zum Zusammenhang zwischen alignmentrelevanten Variablen entwerfen und durchführen, und Agenten dürften bald Trainingsmethoden finden können, die das Ergebnis in einem Alignment-Benchmark verbessern. Der Autor erwartet, dass die automatisierten Capabilities-Forscher, auf die das Feld zusteuert, vieles davon leisten können.
Das Design von Benchmarks, Metriken und Evals nimmt er bewusst aus diesem Bereich heraus. In der heutigen Praxis sei es eng mit der empirischen Arbeit verwoben, für die Automatisierung ordnet er es aber eher der konzeptionellen Arbeit zu. Weil die benötigten Fähigkeiten stark mit denen für die Automatisierung der KI-Capabilities-Forschung überlappen, sieht er keine Priorität darin, diese Art der Automatisierung zu beschleunigen. Stattdessen steige die Priorität ergänzender Arbeit, vor allem einer besseren Spezifikation der Größen, die Forschende messen oder anstreben möchten.
Konzeptionelle Forschung lässt sich schwerer automatisieren, weil es an überprüfbaren Signalen dafür fehlt, was als Fortschritt gilt. Cotton-Barratt nennt ihre Beschleunigung "etwas heikel", unter anderem weil sie in manche gefährlichen Technologien einfließt, kommt aber zu dem Schluss, dass sie wahrscheinlich gut sei, wenn sie möglich ist. Als Methoden führt er unter anderem auf: Trainingsdaten für das Finetuning kuratieren, Scaffolds bauen, die den Modellen mehr Forschungsfortschritt entlocken, mehr Signal aus bestehenden Daten konzeptioneller Forschung gewinnen und Benchmarks für konzeptionelle Forschungsfähigkeiten entwickeln. Schon gute Ideen für Benchmarks, auch ohne vollständige Umsetzung, würden helfen.
Direkte Alignment-Arbeit: eher Ingenieurwesen als Wissenschaft
Der Autor stellt beides gegenüber: Empirische Alignment-Arbeit sei Wissenschaft, direkte Alignment-Arbeit dagegen Ingenieurwesen. Ihre Automatisierung könne die sorgfältige Prüfung bestimmter RL-Umgebungen oder Trainingsdaten umfassen sowie die direkte Überwachung oder Beaufsichtigung von Systemen während des Trainings. Als eine Form nennt er RLAIF für Alignment-Eigenschaften. Als weiteres Beispiel führt er die offenkundige Selbstausrichtung von Claude 3 Opus an, die in diesem Fall allerdings zufällig entstanden sei; sie könnte aber gezielt geschehen, wenn sich das Verhalten reproduzieren oder verallgemeinern ließe.
Im Grenzfall beschreibt er eine Form von System-2-Lernen, bei der Aktualisierungen reflektiert von einem bereits hinreichend ausgerichteten KI-System vorgenommen werden, das noch ausgerichteter werden will, statt blind auf ein Trainingsziel hin. Er räumt ein, ein solcher Weg könne heikel sein, weil schwer zu sagen sei, ob die Ausgangsbedingungen im richtigen Attraktionsbereich liegen. Der Vorteil: Er könnte die volle Stärke der KI-Kognition nutzen, sodass Selbstverbesserung eher der Meditation gleiche als einer Neurochirurgie am eigenen Kopf.
Zur Beschleunigung nennt er das Entwerfen von Setups, die KI-Arbeitskraft für direkte Alignment-Arbeit einsetzen, das Entwerfen von Paradigmen, in denen die KI aktiver an ihrer eigenen Ausrichtung mitwirken kann, sowie das Erzeugen von Daten oder Scaffolds, die das Gespür der KI für die jeweiligen Aufgaben verbessern.
Wechselwirkungen und Prioritäten
Die Kategorien beeinflussen einander. Automatisierte Techniken des direkten Alignments können Gegenstand empirischer Experimente sein, auch ohne gute Alignment-Metriken. Automatisiertes Hill-Climbing könnte starke direkte Ansätze hervorbringen, hängt aber von geeigneten Metriken ab. Der Beitrag warnt: Wenn Überlegung und Umsetzung schneller vorankommen als die Messung, könnte die Optimierung auf die besten verfügbaren Metriken schlechtere Ergebnisse liefern als das Befolgen des nach bestem Wissen gewählten direkten Vorgehens.
Cotton-Barratt argumentiert, wer die Automatisierung konzeptioneller Alignment-Forschung gut hinbekomme, sei damit ungefähr fertig, da sie die anderen Typen vorbereiten und das Vertrauen in deren Techniken stärken könne. Starkes direktes Alignment könnte Systeme im Prinzip vollständig sicher machen, doch er hält es für schwierig, sich dessen sehr sicher zu sein, bevor die konzeptionelle Automatisierung besser ist. Jede neue KI-Generation könnte daher die Frage aufwerfen, ob sich Alignment-Techniken übertragen lassen oder das Glück endet.
Aus Sicht existenzieller Risiken sei das Hauptziel der Automatisierung empirischer und direkter Arbeit, Systeme sicher genug zu machen, um Katastrophen robust zu vermeiden, also "nicht zu verlieren", und zwar lange genug, um die konzeptionelle Alignment-Forschung in sehr hoher Qualität zu automatisieren. Für die Prioritäten nennt er zwei große Unsicherheiten. Fällt ein großer Teil des Risikos eines Kontrollverlusts früh an, sollte mehr Energie in das "Nicht-Verlieren" fließen. Kommt das Hauptrisiko der Fehlausrichtung dagegen mit Systemen, die selbst bei Aufgaben ohne überprüfbare Belohnung gut abschneiden, etwa bei langfristiger Strategie, ist es sinnvoll, den Teil des "Gewinnens" zu beschleunigen und zeitlich vorzuziehen.
Forethought: Three types of automated alignment work