Forethought definiert Compute-Extrapolation beim Testzeit-Skalieren
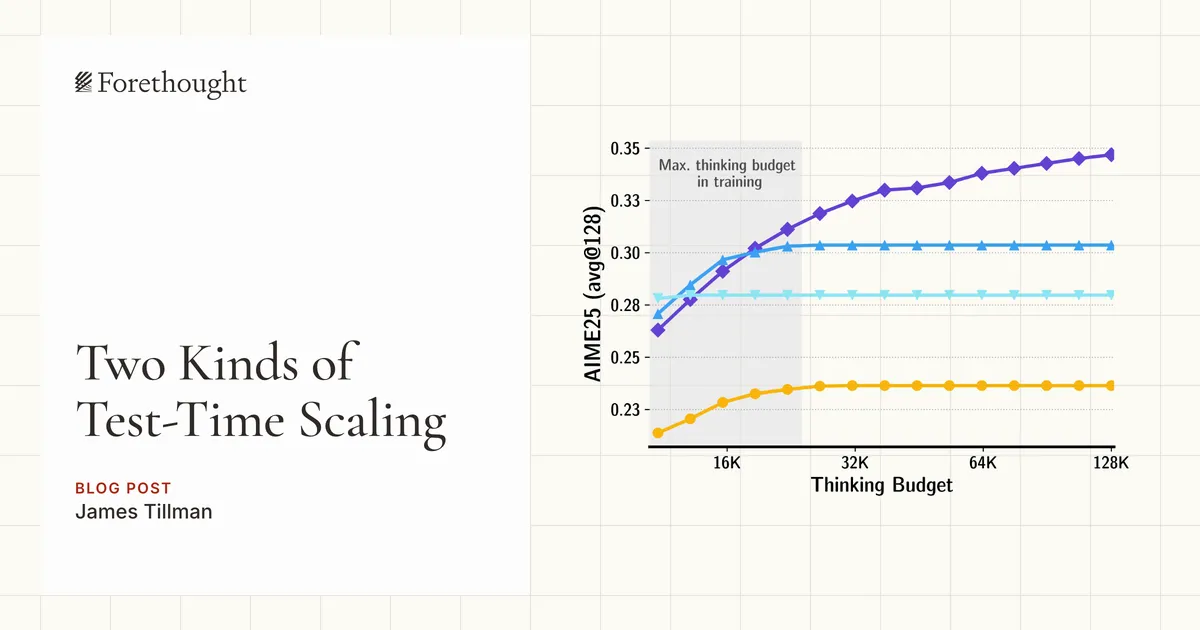
Ein neuer Essay von Forethought unterscheidet zwei Formen der Testzeit-Skalierung. Demnach können manche KI-Systeme weiter besser werden, wenn ihnen pro Aufgabe deutlich mehr Rechenleistung zur Verfügung steht als während des Trainings. James Tillman bezeichnet diese Fähigkeit als „Compute-Extrapolation“ und erklärt, dass sie den Fortschritt bei KI, Evaluierungen und die Dynamik des Wettbewerbs beeinflussen könnte.
- Forethought unterscheidet gewöhnliche Testzeit-Skalierung von Compute-Extrapolation.
- Compute-Extrapolation ermöglicht weitere Leistungssteigerungen über die typische Rechenleistung zur Trainingszeit hinaus.
- Der Essay schlägt vor, Extrapolation anhand einer Obergrenze und einer Steigung zu messen.
- Tillman zufolge könnte sie den Fortschritt bei KI, Evaluierungen und die Dynamik des Wettbewerbs beeinflussen.
Zwei Wege zur Skalierung von Rechenleistung zur Testzeit
Bei der Testzeit-Skalierung wird zusätzliche Rechenleistung gegen eine bessere Leistung bei einer Aufgabe eingetauscht. Dem Essay zufolge ist eine Form durch die maximale Rechenleistung pro Aufgabe begrenzt, die während des Trainings eingesetzt wurde. In diesem Fall kann zusätzliche Rechenleistung die Ergebnisse nur bis zu dieser Trainingsgrenze verbessern.
Die zweite Form liefert auch über diese Grenze hinaus weitere Leistungszuwächse. Tillman nennt dies Compute-Extrapolation. Das Konzept kann auf mehrere erlernte Skalierungsmethoden angewendet werden, darunter die Länge der Gedankenkette eines mit RLVR trainierten LLM, die Anzahl der Schleifen in einem Looping-Transformer und die Zahl der Agenten in einem Multi-Agenten-LLM-Schwarm.
Als Beispiel betrachtet der Essay ein LLM, das mit maximal 100k Token für die Gedankenkette trainiert wurde. Bei einer gewöhnlichen Testzeit-Skalierung würden mehr Token nur bis zu 100k helfen. Bei einer Compute-Extrapolation könnten eine Million oder eine Milliarde Token die Leistung weiter verbessern.
Eine Definition auf Basis typischer Trainingslasten
Tillman argumentiert, dass Compute-Extrapolation nicht anhand seltener Ausreißer in einem Trainingslauf definiert werden sollte. Stattdessen definiert er sie relativ zur Rechenleistung pro Aufgabe am 99. Perzentil der gesamten Rechennutzung. Wenn 99 Prozent der gesamten Trainingsrechenleistung für Aufgaben mit höchstens N FLOPs pro Aufgabe eingesetzt werden, würde eine weitere Verbesserung bei 10x N oder 1000x N zur Testzeit auf einen gewissen Grad an Compute-Extrapolation hindeuten.
Dem Essay zufolge ist der konkrete Schwellenwert von 99 Prozent weniger wichtig als die Gewährleistung, dass oberhalb der ausgewählten Aufgabengröße nur vernachlässigbar wenig Trainingsrechenleistung eingesetzt wird, während der Großteil des Lernens darunter stattfindet. Dieser Ansatz soll Messungen weniger empfindlich gegenüber einzelnen Aufgaben machen, für die ungewöhnlich viel Rechenleistung aufgewendet wird.
Tillman schlägt zwei Möglichkeiten vor, die Fähigkeit zu charakterisieren. Die Obergrenze ist das Vielfache von N, bei dem die Leistung nicht mehr steigt. Die Steigung misst, wie eng die Leistung oberhalb von N einer Funktion folgt, die an den empirischen Zusammenhang zwischen FLOPs und Leistung unterhalb von N angepasst wurde. Beide Messgrößen könnten je nach Bereich variieren.
Warum Compute-Extrapolation wichtig sein könnte
Dem Essay zufolge beschleunigt Compute-Extrapolation wahrscheinlich den Fortschritt bei den beeindruckendsten KI-Fähigkeiten, erschwert Evaluierungen gefährlicher Fähigkeiten und verändert die Dynamik des KI-Wettbewerbs. Tillman schreibt, dass sie offenbar jünger ist als die Testzeit-Skalierung im Allgemeinen und dass KI-Labore sie noch beherrschen lernen, möglicherweise nur in bestimmten Bereichen.
Dem Essay zufolge könnten sich ihre Obergrenze und Steigung durch ein besseres Kontextmanagement bei LLMs, die Skalierung mit mehreren Agenten und andere Fortschritte verbessern. Hohe Obergrenzen könnten in Bereichen wie Mathematik oder Cybersecurity leichter zu erreichen sein, weil sich schrittweise Fortschritte dort einfacher erkennen lassen als in Bereichen, in denen Qualitätsverbesserungen schwieriger festzustellen sind.
Tillman weist außerdem darauf hin, dass Compute-Extrapolation über LLM-spezifische Methoden hinausgeht. Als Beispiel nennt er AlphaGo Zero, eine nicht-allgemeine und nicht auf LLMs basierende KI, die mit 1.600 Simulationen pro Zug trainiert wurde und zur Testzeit mehr Simulationen nutzen konnte, während ihre Leistung weiter zunahm. Die Unterscheidung gibt Forschern eine Möglichkeit zu untersuchen, ob Rechenleistung zur Testzeit über die im Training abgebildeten Lasten hinaus nützlich bleibt.
Forethought: Two Kinds of Test-Time Scaling