Goodfire findet kleine Neuronengemeinschaften hinter Modellverhalten
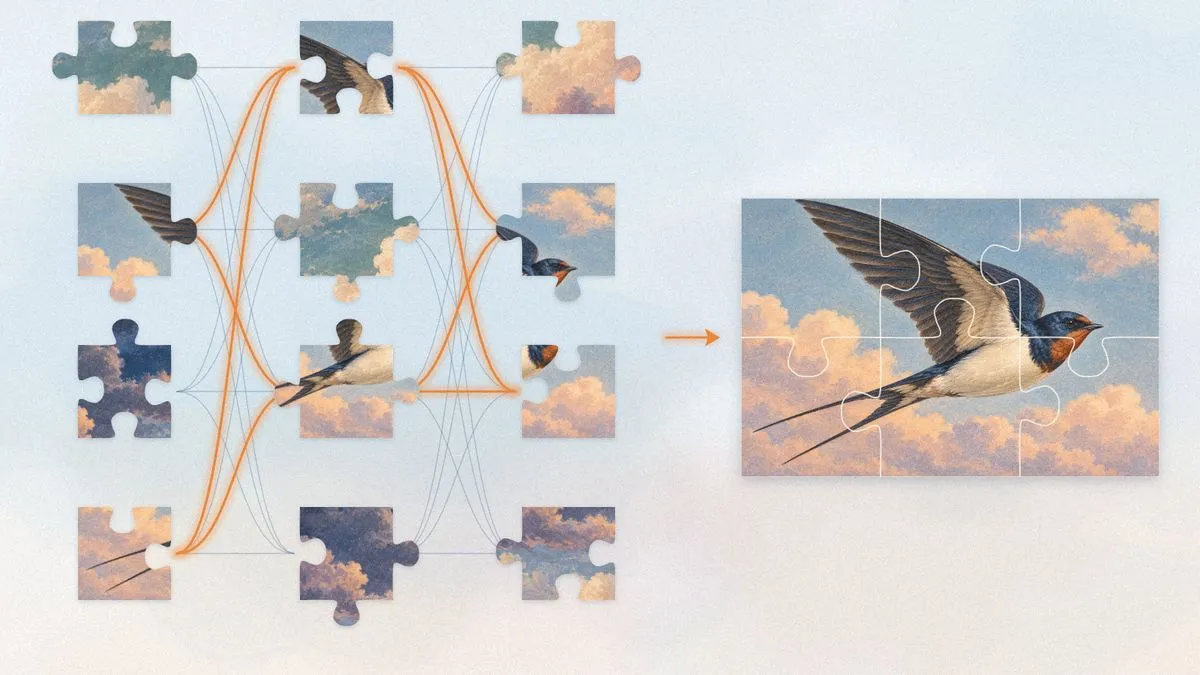
Goodfire Research zufolge können kleine Gruppen von Neuronen für bestimmte Verhaltensweisen von Sprachmodellen notwendig und ausreichend sein, darunter grammatische Kongruenz, Kopieren und Arithmetik. Die Studie des Unternehmens stellt eine unüberwachte Methode vor, um solche Gruppen zu finden, ohne ihre Funktionen zuvor festlegen zu müssen.
- Goodfire identifizierte Neuronengemeinschaften, die häufig aus weniger als zehn Neuronen bestehen.
- Die Gruppen wurden mit Verhaltensweisen wie grammatischer Kongruenz, Kopieren und Arithmetik in Verbindung gebracht.
- Die Methode nutzt Attribution, Neuronengraphen und Gemeinschaftserkennung.
- In Tests wurde gemessen, ob die Gemeinschaften für Vorhersagen notwendig und ausreichend waren.
- Der Ansatz wurde auf Llama-3.1-8B ausgeführt und mit Qwen 3.6 35B-A3B repliziert.
Kleine Gruppen können Modellverhalten erklären
Neuronen sind ein naheliegender Ausgangspunkt für die Untersuchung neuronaler Netze. Einzelne Neuronen können jedoch in scheinbar nicht miteinander verbundenen Kontexten aktiviert werden. Außerdem aktivieren Prompts oft viele Neuronen gleichzeitig, wodurch sich ihre jeweiligen Beiträge nur schwer voneinander trennen lassen.
Goodfires Forschung untersucht sogenannte Neuronengemeinschaften. Dabei handelt es sich um kleine Gruppen, die wiederholt zusammenarbeiten, um gängige Modellverhaltensweisen umzusetzen. Goodfire zufolge verändert das Entfernen dieser Gruppen die Vorhersagen eines Modells erheblich. Werden sie dagegen beibehalten, lassen sich die Vorhersagen weitgehend bewahren, selbst wenn fast alle anderen MLP-Neuronen in den betreffenden Schichten entfernt werden.
Tests mit zurückgehaltenen Prompts ergaben, dass diese Gemeinschaften häufig aus weniger als zehn Neuronen bestehen und sowohl notwendig als auch ausreichend sein können, um die Beiträge der betreffenden Schichten zu erklären. Zu den Beispielen der Studie gehören grammatische Kongruenz, Kopieren und Arithmetik.
Eine unüberwachte Methode zum Finden von Gemeinschaften
Die Forschenden wendeten ihre Methode auf Millionen von Prompts an und nutzten eine gradientenbasierte Attribution, um zu schätzen, welche Neuronen am stärksten zu jeder Vorhersage des nächsten Tokens beitrugen. Anschließend erstellten sie einen Graphen, in dem jeder Knoten ein Neuron repräsentierte. Verbindungen standen für Neuronen, die wiederholt zu denselben Vorhersagen beitrugen, korrigiert um die individuelle Häufigkeit jedes Neurons.
Mit einer Erkennung von Graphgemeinschaften wurden Gruppen von Neuronen identifiziert, die wiederholt zusammenarbeiteten. Anschließend testeten die Forschenden die ermittelten Gemeinschaften durch kausale Eingriffe an zurückgehaltenen Prompts.
Für den Notwendigkeitstest entfernten sie eine Gemeinschaft und maßen, ob sich die Vorhersagen des Modells erheblich veränderten. Für den Ausreichendheitstest behielten sie die Gemeinschaft bei und entfernten die anderen MLP-Neuronen in den betreffenden Schichten. Anschließend prüften sie, ob die ursprünglichen Vorhersagen weitgehend erhalten blieben.
Für die veröffentlichten Ergebnisse wurde der Algorithmus auf Llama-3.1-8B mit 10M Prompts aus FineWeb-Edu, der englischen Wikipedia und FineMath ausgeführt. Goodfire zufolge replizierte das Unternehmen die Methode später mit Qwen 3.6 35B-A3B.
Eine mittlere Ebene für die Interpretierbarkeitsforschung
Goodfire argumentiert, dass Neuronengemeinschaften eine Abstraktionsebene zwischen einzelnen Neuronen und übergeordneten Berechnungen bilden könnten. Die Ergebnisse ergänzen die Hinweise darauf, dass neuronale Netze interpretierbare Strukturen enthalten. Diese Strukturen lassen sich möglicherweise leichter erkennen, wenn Neuronen in wiederkehrenden Gruppen untersucht werden.
Die Forschung befasst sich außerdem mit einer langjährigen Herausforderung durch verteilte Repräsentationen. Dabei können sich Merkmale über mehrere Neuronen hinweg überschneiden und einzelnen Neuronen mehrere Rollen geben. Goodfire verweist auf frühere Arbeiten zu spärlichen Neuronenschaltkreisen, Transcoder-Merkmalen und der Ausdünnung von Modellen als Beleg dafür, dass sich manche Konzepte und Berechnungen mit überraschend wenigen Neuronen erfassen lassen.
Da der Entdeckungsprozess unüberwacht abläuft, kann das Unternehmen zufolge auch im großen Maßstab eingesetzt werden, ohne zuvor festzulegen, nach welchen Verhaltensweisen gesucht werden soll. Das könnte Forschenden konkrete Ausgangspunkte geben, um Neuronenfunktionen zu untersuchen und Erklärungen dafür zu prüfen, wie Sprachmodelle ihre Ausgaben erzeugen. Die Arbeit liefert für sich genommen noch keine vollständige Erklärung neuronaler Netze. Sie bietet jedoch eine Möglichkeit, von einzelnen Befunden zu umfassenderen Erklärungen der Modellberechnung überzugehen.
Goodfire Research: Discovering Neuron Communities in Language Models - Goodfire