MIT-Forscher entwickelt KI-Systeme, die sich selbst erklären können
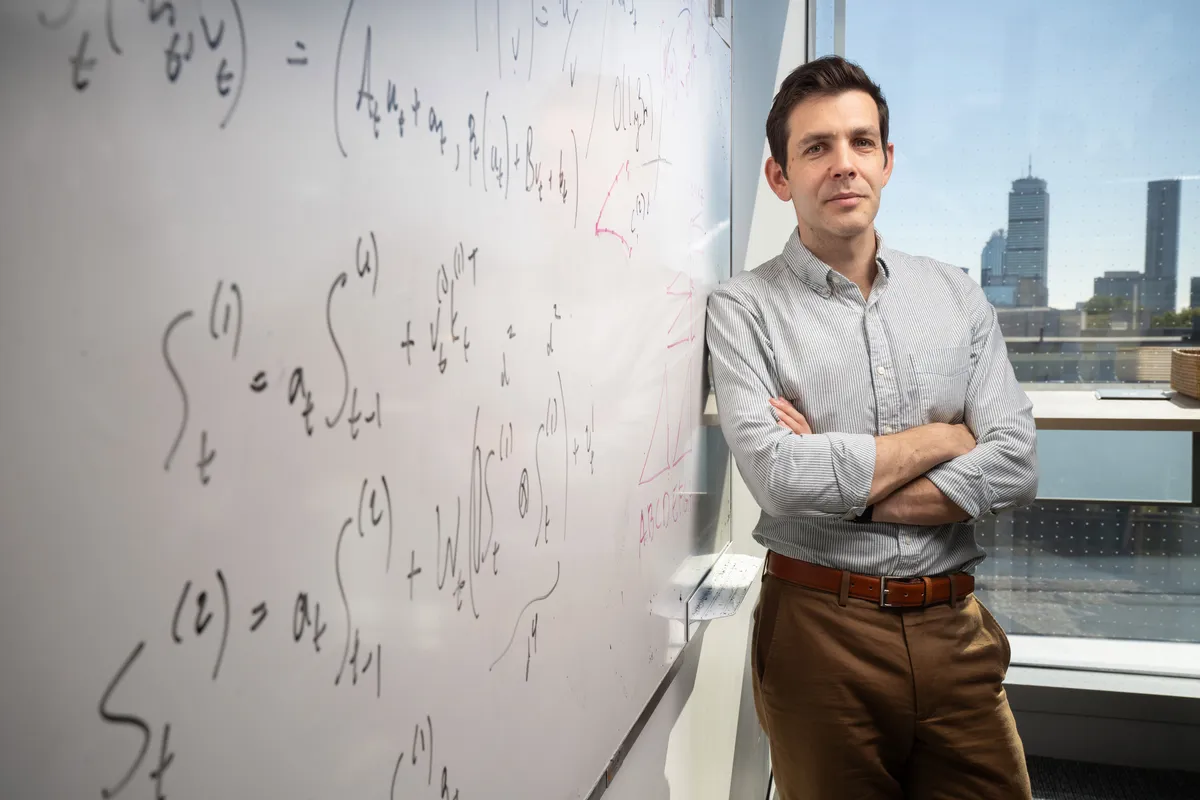
Der MIT-Associate-Professor Jacob Andreas entwickelt Methoden, mit denen Modelle künstlicher Intelligenz erklären könnten, was sie gelernt haben und wie sie in einer für Menschen verständlichen Sprache funktionieren. Seine Forschung befasst sich mit der schwierigen Interpretation von Deep-Learning-Systemen in Anwendungen mit hohen Risiken.
- Jacob Andreas entwickelt Methoden, mit denen KI-Modelle erklären können, was sie gelernt haben.
- Seine Gruppe untersucht die von großen Sprachmodellen verwendeten Algorithmen.
- Die Techniken können informationsverarbeitende Knoten in neuronalen Netzwerken beschreiben.
- Andreas kam 2019 an die Fakultät des MIT.
- Seine Forschung soll genauere und robustere Deep-Learning-Modelle unterstützen.
Komplexe Modelle verständlicher machen
Deep-Learning-Modelle enthalten riesige Netzwerke interner Verarbeitungsknoten. Werden sie in Szenarien mit hohen Risiken eingesetzt, müssen Forschende diese komplexe interne Struktur analysieren, um zu verstehen, was ein Modell weiß und wie es sich verhalten könnte.
Andreas, ein kürzlich berufener Associate Professor am Department of Electrical Engineering and Computer Science des MIT und Mitglied des Computer Science and Artificial Intelligence Laboratory, verfolgt einen anderen Ansatz. Seine Gruppe entwickelt Techniken, mit denen KI-Modelle präzise kommunizieren können, was sie aus Trainingsdaten gelernt haben.
„Statt all diese externen Werkzeuge einsetzen zu müssen, um herauszufinden, was unter der Haube passiert, könnten wir Modelle vielleicht so trainieren, dass sie auf präzise Weise über sich selbst sprechen“, sagt Andreas laut MIT News.
Ziel ist es, Forschenden Werkzeuge an die Hand zu geben, die komplexe neuronale Berechnungen in eine für Menschen verständliche Sprache übersetzen. Andreas bezeichnet sie als „Gedankenlesewerkzeuge“ für KI-Systeme. Sie sollen die Entwicklung genauerer und robusterer Deep-Learning-Modelle unterstützen.
Forschung zu Sprache, Bildverarbeitung und Interpretierbarkeit
Andreas’ Interesse an diesem Thema begann mit Sprache und Computerprogrammierung. Er studierte Informatik an der Columbia University und arbeitete dort im Labor von Michael Collins, dem Vikram S. Pandit Professor of Computer Science an der Columbia University, an maschineller Übersetzung.
Später absolvierte er ein weiterführendes Studium an der University of California at Berkeley, nachdem er an der University of Cambridge in England einen Masterabschluss erworben hatte. Seine Forschung entwickelte sich während eines grundlegenden Wandels in der Verarbeitung natürlicher Sprache, als neuronale Netzwerke statistische Methoden bei der Sprachverarbeitung zunehmend ersetzten.
In Berkeley arbeitete Andreas mit Forschenden aus der Computer Vision an Systemen, die sprachliche und visuelle Informationen kombinierten. Er schloss ein Dissertationsprojekt zu neuronalen Modulnetzwerken ab. Diese verwenden kleine Komponenten neuronaler Netzwerke für Aufgaben wie das Lokalisieren von Objekten oder logisches Schlussfolgern.
Projekte zur Interpretierbarkeit und zu natürlichsprachlichen Beschreibungen der internen Zustände von KI-Modellen wurden später zu einem zentralen Bestandteil seiner Arbeit am MIT. Seine Gruppe untersucht die Algorithmen, die große Sprachmodelle beim Lernen und Verarbeiten von Informationen verwenden, und entwickelt zugleich Methoden, um vorherzusagen, wie sich trainierte Modelle in der realen Welt verhalten werden.
Auf dem Weg zu einer natürlicheren Interaktion mit KI-Systemen
Eine von Andreas’ Gruppe entwickelte Technikfamilie trainiert große Sprachmodelle darauf, zu erklären, was im Inneren anderer neuronaler Netzwerke geschieht. Diese Methoden können jedem informationsverarbeitenden Knoten in einem großen neuronalen Netzwerk eine Beschreibung in natürlicher Sprache zuordnen. Ein Beispiel könnte einen Knoten beschreiben, der in Eingabebildern „Grasflächen in der Nähe von Tieren“ erkennt.
Die Gruppe entwickelt außerdem Algorithmen zum Trainieren von maschinellen Lernmodellen und zur Vorhersage, wie bestimmte Datensätze oder Beispiele verschiedene Aspekte des Modellverhaltens beeinflussen werden. Diese Arbeit spiegelt Andreas’ übergeordnetes Ziel wider, den Trainingsprozess natürlicher und effizienter zu gestalten, damit KI-Modelle auf eine Weise lernen, die dem menschlichen Lernen ähnlicher ist.
Für Forschende und Entwickler könnte die Arbeit eine Möglichkeit bieten, das Modellverhalten zu untersuchen, ohne sich ausschließlich auf die Parameter der Modelle oder externe Analysewerkzeuge zu verlassen. Andreas sagt, dass ein tiefes Verständnis der Funktionsweise dieser Technologie weiterhin wichtig sein wird, sobald der Zugang zu Coding-Agenten weit verbreitet ist.
MIT News: Learning the language of machine learning