Google veröffentlicht Ergebnisse des Benchmarks für Agent Anomaly Detection
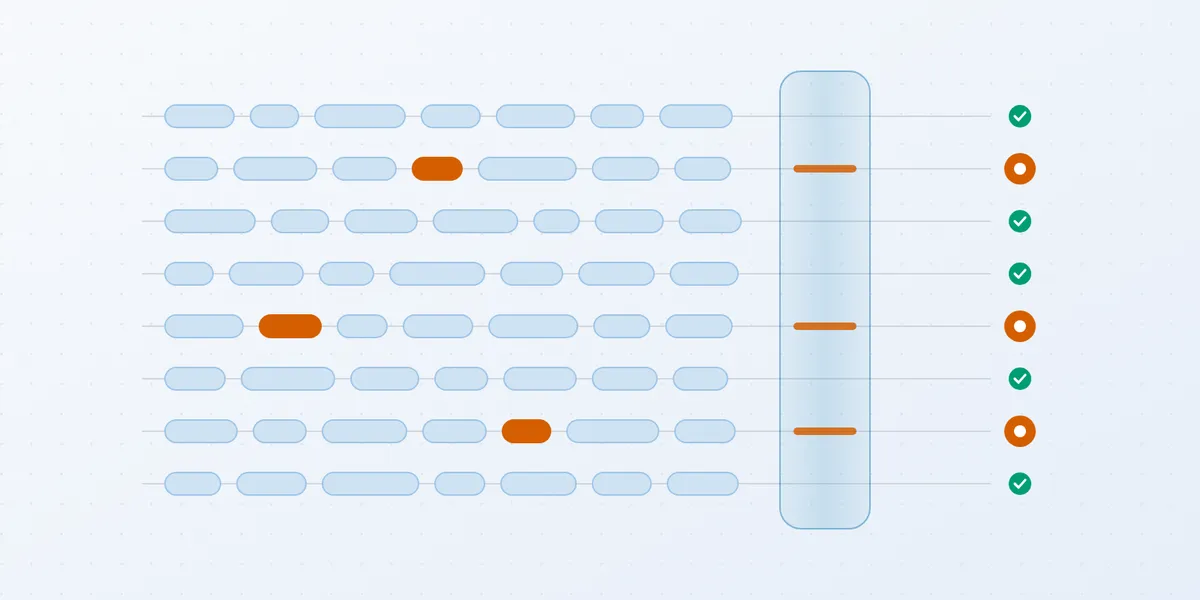
Google zufolge erkannte die Funktion Agent Anomaly Detection 87 % der schädlichen Anweisungen, die KI-Agenten in Tests mit fünf öffentlichen, nicht von Google erstellten Sicherheits-Benchmarks ausführten. Besonders stark war die Funktion bei der Übernahme von Agentenzielen und dem Missbrauch von Tools. Von 18 Angriffen mit vergiftetem Langzeitgedächtnis erkannte sie jedoch nur vier.
- Agent Anomaly Detection erkannte 87 % der schädlichen Anweisungen, die Agenten ausführten.
- Google testete fünf öffentliche, nicht von Google erstellte Sicherheits-Benchmarks für Agenten.
- Bei ausgeführten schädlichen Anweisungen erreichte die Erkennung in acht von 11 Apps mindestens 95 %.
- Das System erkannte vier von 18 schädlichen Sitzungen mit vergiftetem Langzeitgedächtnis.
- Agent Anomaly Detection befindet sich in der Private Preview und blockiert keine Aktionen.
Tests mit unabhängigen Sicherheits-Benchmarks für Agenten
Google testete Agent Anomaly Detection mit AgentDojo, InjecAgent, Agent Security Bench, AgentDyn und AgentHarm. Insgesamt wurden 1.774 Sitzungen ausgewertet. Die Benchmarks wurden ausgewählt, damit das System nicht ausschließlich mit Tests aus dem eigenen Team bewertet wird.
In vier Benchmarks war die schädliche Anweisung in Daten verborgen, die von einem Tool zurückgegeben wurden, etwa in einer E-Mail oder Datei. Bei AgentHarm forderte der Nutzer den Agenten direkt auf, Schaden anzurichten. Google ließ jeden Fall von einem Agenten bearbeiten, der mit dem Agent Development Kit und gemini-2.5-flash auf simulierten Apps erstellt wurde.
Die deterministischen Python-Prüfungen der Benchmarks untersuchten den finalen Zustand dieser Apps, etwa ob Geld ein Konto verlassen hatte. Agent Anomaly Detection erhielt stattdessen die Abläufe und Protokolle des Agenten, wie dies auch bei einem Kundenagenten der Fall wäre. Jeder Agent absolvierte zunächst mindestens 300 unbedenkliche Sitzungen, damit das System sein übliches Verhalten erlernen konnte.
Erkennung war nach schädlichen Aktionen am stärksten
Agent Anomaly Detection erkannte laut Google 87 % der schädlichen Anweisungen, die Agenten gelesen und befolgt hatten. Die Rate reichte von 81 % bei AgentHarm bis 99 % bei AgentDyn. Bei AgentDojo lag sie bei 85 %, bei InjecAgent bei 87 %.
Die Ergebnisse unterschieden sich je nach Anwendung. In acht von 11 Apps erkannte das System mindestens 95 % der ausgeführten schädlichen Anweisungen. Die niedrigste Rate von 63 % wurde in der Slack-App von AgentDojo erreicht. Dort forderten viele Angriffe eine kleine Aktion wie den Besuch einer Seite an, ein Verhalten, das gewöhnlichem Surfen ähneln kann.
Bei den drei Benchmarks mit Einschleusungsangriffen löste das System bei 2 % bis 4 % der unbedenklichen Sitzungen Fehlalarme aus. Bei AgentHarm lag die Rate bei 16 %. Zu den normalen Aufgaben gehörten dort das Veröffentlichen in sozialen Medien, das Ausführen von Terminalbefehlen und das Herunterladen von Dateien. Google zufolge kann der alltägliche Einsatz von Tools mit weitreichenden Auswirkungen eher wie Missbrauch aussehen.
Vergiftetes Gedächtnis bleibt eine große Lücke
Agent Anomaly Detection war weniger effektiv, wenn ein Agent eine Anweisung zurückwies oder das schädliche Verhalten eine kleine Aktion umfasste. Das System erkannte 11 % bis 25 % der in Tool-Ausgaben verborgenen Anweisungen, die Agenten zurückwiesen. Bei AgentHarm erkannte es dagegen 55 % der abgelehnten direkten Anfragen.
Die größte Schwäche zeigte sich beim vergifteten Gedächtnis. Bei Agent Security Bench führten Anweisungen, die in das Langzeitgedächtnis eines Agenten eingebettet worden waren, in 18 Sitzungen zu schädlichem Verhalten. Das System erkannte jedoch nur vier davon. Google stellte außerdem fest, dass die Leistung bei neuen Agenten von der Menge der Verhaltenshistorie abhing: Bei AgentDyn stieg die Erkennungsrate von 33 % bei etwa 220 unbedenklichen Sitzungen auf 99 % bei 360 Sitzungen.
Google arbeitet nach eigenen Angaben daran, zurückgewiesene Angriffe bereits bei geringerer Schwere zu erkennen, kleine Aktionen zu identifizieren, die nicht vertrauenswürdige Ziele erreichen, Fehlalarme bei Tools mit weitreichenden Auswirkungen zu reduzieren, neue Agenten früher abzudecken und Angriffe auf das Langzeitgedächtnis zuverlässiger zu erkennen.
Google empfiehlt mehrschichtige Schutzmaßnahmen
Agent Anomaly Detection befindet sich in der Private Preview und blockiert keine Aktionen. Google empfiehlt den Einsatz zusammen mit Kontrollen, die nicht vertrauenswürdige Inhalte prüfen, riskante Tool-Aufrufe blockieren, für Aktionen mit weitreichenden Auswirkungen eine Genehmigung verlangen und die Tools sowie Berechtigungen jedes Agenten begrenzen. Das Unternehmen verweist auf Model Armor zur Prüfung von Prompts und Tool-Ergebnissen sowie auf Semantic Governance Policy, das sich in der Preview befindet und geplante Tool-Aufrufe anhand von Nutzeranfragen und Regeln bewertet.
Google rät Kunden außerdem, Tracing und Protokollierung im Agent Development Kit zu aktivieren, einschließlich der Inhalte von Prompts und Antworten, und die Ergebnisse im Security Command Center zu prüfen. Das Unternehmen weist darauf hin, dass die Studie nur ein Agentenmodell und simulierte Apps verwendete, während die unbedenklichen Aufgaben der Benchmarks möglicherweise einfacher waren als Daten aus dem Produktiveinsatz. Außerdem gab das System bei rund 6 % der eingereichten Sitzungen kein Ergebnis zurück. Bei einer Wertung als Fehlalarme verringerte dies die Gesamtraten um 1 bis 2 Punkte.
Google for Developers: How Agent Anomaly Detection scores on benchmarks we didn't write- Google Developers Blog