Google beschreibt bitweise abgestimmtes TPU-Training für stabiles LLM-Reinforcement-Learning
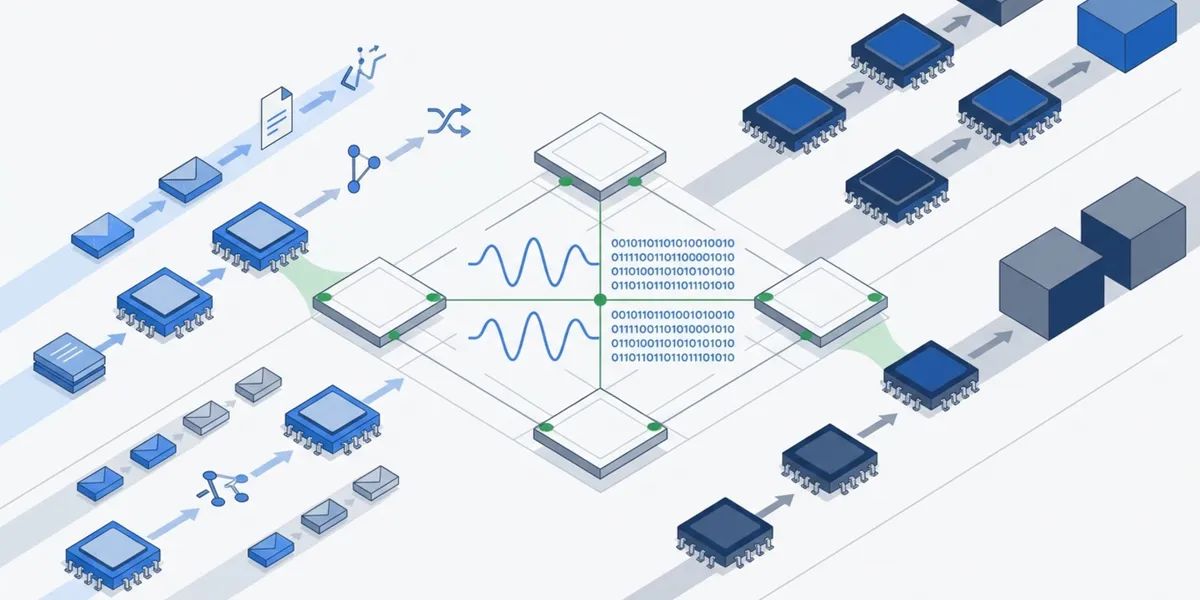
Google hat eine Open-Source-Implementierung für Tunix vorgestellt, die numerische Unterschiede zwischen Sampling und Training beim Reinforcement-Learning großer Sprachmodelle auf TPUs beseitigen soll. Nach Angaben des Unternehmens erzeugte das Zero-TIM-System bitweise identische Aktions-Log-Wahrscheinlichkeiten über getrennte Ausführungspfade hinweg, auch in Tests mit 64 TPU-v5p-Chips.
- Googles Zero-TIM zielt auf numerische Unterschiede zwischen LLM-Sampling und Training.
- Der Vertrag vergleicht Sampler-Decodierung, Serving-Prefill und Trainer-Log-Wahrscheinlichkeiten bitweise.
- Die Tunix-Implementierung verwendet Pallas-Kernel und ausdrücklich geordnete Reduktionen.
- Google verifizierte den Ansatz über 64 TPU-v5p-Chips in einem DP8×TP8-Mesh.
Die verborgene numerische Lücke beim On-Policy-Lernen
On-Policy-Reinforcement-Learning erfordert, dass Aktionen von derselben Policy erzeugt und bewertet werden. In Systemen für große Sprachmodelle nutzen Rollout-Sampling und Gradientenaktualisierungen jedoch häufig getrennte Ausführungspfade.
Der Sampler erzeugt Tokens schrittweise und protokolliert deren Verhaltens-Log-Wahrscheinlichkeit. Der Trainer bewertet diese Tokens anschließend in gebündelten Vorwärts- und Rückwärtsdurchläufen. Google zufolge können die beiden Pfade selbst bei identischen Gewichten unterschiedliche Log-Wahrscheinlichkeiten erzeugen. Dadurch entsteht eine numerische Lücke, die sich über mehrteilige Trajektorien hinweg verstärken kann, das Training weniger stabil macht oder eine Konvergenz verhindert.
Die Ursache liegt in der Gleitkommaarithmetik. Addition ist nicht assoziativ, daher verändert eine andere Reihenfolge einer Reduktion den Ort der Rundung. Google zufolge tritt das Problem bei bfloat16 besonders deutlich auf und kann bei Matrixprodukten, Normalisierung, Tensor-Parallel-Reduktionen und anderen Modelloperationen entstehen.
Ein Dreiparteienvertrag für übereinstimmende Log-Wahrscheinlichkeiten
Googles Zero Train-Inference Mismatch, kurz Zero-TIM, verlangt, dass Sampler-Decodierung, Serving-Prefill und Vorwärtsdurchläufe des Trainers für jede gesampelte Aktion bitweise identische Log-Wahrscheinlichkeiten erzeugen. Der Vergleich verwendet die unveränderten Gleitkomma-Bytes unter denselben Rollout-Gewichten, derselben Token-Historie und denselben Sampling-Einstellungen, ohne Rundungstoleranz.
Das Serving-Prefill dient als diagnostischer Prüfpunkt zwischen Sampler und Trainer. Vergleiche zwischen Sampler und Prefill prüfen, ob inkrementelle Generierung und die Neuberechnung vollständiger Sequenzen innerhalb der Serving-Engine übereinstimmen. Vergleiche zwischen Prefill und Trainer prüfen, ob Serving und Training über Kompilierungs- und Differenzierungsgrenzen hinweg übereinstimmen.
Die Implementierung hält Serving- und Trainingssysteme getrennt. Ihr Verfahren stimmt die Kernel-Akkumulation innerhalb eines Shards ab, ordnet Reduktionen über Shards hinweg ausdrücklich, standardisiert die Berechnung der Aktions-Log-Wahrscheinlichkeit und ergänzt benutzerdefinierte Differenzierungsregeln für Serving-Kernel.
So funktioniert Zero-TIM auf der TPU
Innerhalb der Tensor-Parallel-Ränge verwenden Pallas-Kernel feste Akkumulationsreihenfolgen und eine explizite Zwischenpräzision. Projektionskernel akkumulieren Teilprodukte in float32, bevor sie die Ausgaben umwandeln, während spezielle Kernel die Reduktionen von RMSNorm und die Umwandlung von SwiGLU-Zwischenergebnissen übernehmen. Google zufolge deckt der Ansatz sowohl Attention- und MLP-Projektionen als auch den Sprachmodellkopf ab.
Bei zeilenparallelen Projektionen wird die Kommunikation von der Addition getrennt. Die Implementierung überträgt Teilausgaben mit ppermute und addiert sie anschließend in einer festen Reihenfolge der Quellränge, statt sich auf die von einer Kollektivimplementierung gewählte Reihenfolge zu verlassen.
Sampler, Prefill und Trainer verwenden aufeinander abgestimmte Sampling-Transformationen sowie dieselbe Pallas-Konstruktion für Log-Softmax, um das protokollierte Aktions-Token zu bewerten. Die IDs der gesampelten Tokens werden über Umgebungsdurchläufe hinweg gespeichert, sodass jeder Pfad dieselbe Token-Historie bewertet. Der Trainer verwendet die Serving-Prefill-Berechnung für die Vorwärtsauswertung wieder, während benutzerdefinierte Vektor-Jacobi-Produkte die Regeln für den Rückwärtsdurchlauf liefern.
Google zufolge werden lange Trajektorien außerdem in Blöcken fester Größe verarbeitet, während der paged KV-Cache weitergeführt wird. Das Unternehmen setzte die Implementierung in Tunix ein und verifizierte sie über ein Multi-Host-64-TPU-v5p-Mesh mit einer DP8×TP8-Konfiguration. Google stellt die Arbeit als wiederverwendbare Vorlage für Teams dar, die verteilte JAX- und TPU-Reinforcement-Learning-Systeme entwickeln.
Google for Developers: Unlocking Stable On-Policy RL on TPU with Bitwise-Zero Train–Inference Mismatch- Google Developers Blog