Tunix
Google trainiert Gemma 4 für agentisches Reinforcement Learning über mehrere Dialogrunden
Google hat eine Pipeline für agentisches Reinforcement Learning über mehrere Dialogrunden vorgestellt. Sie trainiert Gemma 4 darin, Werkzeuge zu nutzen, auf Feedback zu…
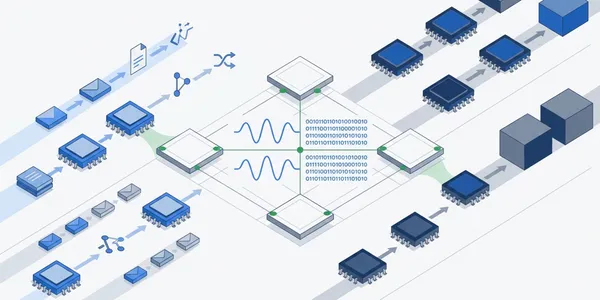
Google beschreibt bitweise abgestimmtes TPU-Training für stabiles LLM-Reinforcement-Learning
Google hat eine Open-Source-Implementierung für Tunix vorgestellt, die numerische Unterschiede zwischen Sampling und Training beim Reinforcement-Learning großer…