Harness-Zero: Studie trainiert einen Agenten-Harness in ein kleines Modell hinein
Forscher der Peking University haben das Verhalten eines spezialisierten Agenten-Harness in ein kleines Modell hineintrainiert, den Harness anschließend entfernt, und das Modell schnitt besser ab als die ursprüngliche Kombination aus Modell und Harness. In einem Blogbeitrag argumentiert Arize, dass Harnesses nicht aussterben, sich ihre Aufgabe aber verändert.
- Harness-Zero von der Peking University trainierte das Verhalten eines spezialisierten Harness in Qwen3.5-9B hinein und entfernte den Harness anschließend.
- Der durchschnittliche Aufgabenerfolg des destillierten Modells stieg um 21 Punkte, mehr als der Zugewinn des untrainierten Modells mit dem vollständigen evolved harness.
- In der Chemie lag das destillierte Modell 8 Punkte hinter der Variante mit Harness, und das Kontextmanagement ließ sich nicht vollständig übertragen.
- Nur das Training auf korrigierten Durchläufen wirkte; eigene Erfolge des stärkeren Modells, Harness-Durchläufe und Prüfungen mit Lösungskenntnis brachten nichts.
- Laut Arize bleiben Harnesses nötig, müssen aber regelmäßig neu aufgebaut werden, mit automatisierten Updates, die gegen Überanpassung abgesichert sind.
Wie Harness-Zero einen Harness in ein Modell verlagerte
Die Arbeit mit dem Titel Harness-Zero stammt von Haoran Ye und Kollegen der Peking University. Sie befasst sich mit Harness-Destillation: Dabei wird ein Modell darauf trainiert, Verhalten nachzubilden, das zuvor vom umgebenden Harness kam.
Das Team baute zunächst einen spezialisierten Harness für ein kleines Modell, Qwen3.5-9B. Eine automatisierte Schleife mit Kimi K3 analysierte, woran das kleine Modell bei Trainingsaufgaben immer wieder scheiterte, und ergänzte Komponenten, um diese Fehler zu beheben: eigene Tools, Middleware-Regeln, die riskante Aktionen blockieren, Skill-Dateien und Speicher. Das Ergebnis nannten die Forscher den „evolved harness“.
Mit diesem Harness wurden dann Trainingsdaten erzeugt. Das kleine Modell bearbeitete Trainingsaufgaben in einem minimalen Harness, während ein stärkeres Modell, GPT-5.6 Sol, jeden vom kleinen Modell vorgeschlagenen Schritt prüfte. Sol nutzte dafür eine Kopie des evolved harness, um jeden Schritt zu bewerten. Gute Schritte liefen unverändert durch, und wo das kleine Modell und die Vorgaben voneinander abwichen, nahm Sol vor der Ausführung die kleinstmögliche Korrektur vor. Die korrigierten Durchläufe wurden zu den Daten für das Fine-Tuning, danach wurden der evolved harness, der Prüfer und alles Übrige entfernt.
Ergebnisse und Grenzen
Das Team verglich den evolved harness und das destillierte Modell bei Tabellenbearbeitung, App-übergreifender Tool-Nutzung und Chemie. Laut der Zusammenfassung von Arize stieg der durchschnittliche Aufgabenerfolg des destillierten Modells gegenüber seinem untrainierten Vorgänger um 21 Punkte. Das ist mehr, als das untrainierte Modell mit dem vollständigen evolved harness hinzugewann.
Es gibt allerdings Einschränkungen. Das destillierte Modell lief weiterhin in einer minimalen Schleife mit einem Bash-Tool, und die Autoren sagen, ihre Methode verringere, was ein Harness leisten muss, statt ihn überflüssig zu machen. In der Chemie, wo es darum geht vorherzusagen, welche Moleküle zu einer Zielverbindung kombiniert werden, lag das destillierte Modell 8 Punkte hinter der Variante mit Harness. Der Harness lieferte dort Chemiewissen, Logik zur Kandidatengenerierung und ein Tool zur Validierung von Molekülen.
Die Autoren erklären das damit, dass schrittweise Abläufe, etwa erst prüfen, dann bearbeiten, und vor dem Abschluss verifizieren, sich deutlich leichter antrainieren lassen als tiefes Fachwissen. Auch das Kontextmanagement ließ sich nicht vollständig übertragen.
Entscheidend war die Art der Trainingsdaten. Fine-Tuning auf den eigenen erfolgreichen Durchläufen des stärkeren Modells ließ den Wert des kleinen Modells dort, wo er war, ebenso Fine-Tuning auf Durchläufen im evolved harness. Bekam der Prüfer die richtigen Antworten, entstanden nahezu perfekte Durchläufe, aber ein Modell, das sich kaum verbesserte, weil es überanpasste. Nur die korrigierten Durchläufe, bei denen jede Korrektur noch in Reichweite des kleinen Modells lag, steigerten den Aufgabenerfolg um 21 Punkte.
Warum Modelle immer mehr Harness-Logik aufnehmen
Der Arize-Beitrag verknüpft das Ergebnis mit Rich Suttons Essay The Bitter Lesson von 2019. Darin blickte Sutton auf 70 Jahre KI-Forschung zurück und stellte fest, dass eingebautes menschliches Wissen kurzfristig half, am Ende aber gegen allgemeine Methoden verlor, die mit billigerer Rechenleistung besser werden. Ein Harness sei genau solches eingebautes Wissen, so der Beitrag, und das Modelltraining sei das Lernen, das es aufsauge.
Andere haben ähnliche Prognosen abgegeben. Laut dem Beitrag schrieb Jesus Rodriguez von TheSequence im Januar, dass handgeschriebene Gerüste immer wieder gegen Fähigkeiten verlieren, die Modelle direkt lernen. Im Februar sagte Boris Cherny, der Schöpfer von Claude Code, bei Y Combinator, Scaffolding bringe bei einer Aufgabe vielleicht 10 bis 20 Prozent, und dann „ist der Gewinn mit dem nächsten Modell weg“. Im März sagte Vivek Trivedy von LangChain voraus, dass Planung, Selbstverifikation und Kohärenz über lange Läufe vom Harness ins Modell wandern würden.
Arize weist darauf hin, dass die meisten dieser Personen beruflich Harnesses bauen. Sie sagen nicht, dass Harnesses verschwinden, sondern nur, dass sie sich schnell weiterentwickeln müssen.
Was weiter in den Harness gehört
Kontextmanagement bleibt Aufgabe des Harness. In den Ergebnissen des ARC Prize für ARC-AGI-3 erzielt Gemini 3.8 Flash mit einem Harness einen 3,4-mal höheren Wert als mit einem anderen. Der bessere Harness bewahrt den Denkzustand des Modells zwischen Anfragen und verdichtet lange Konversationen.
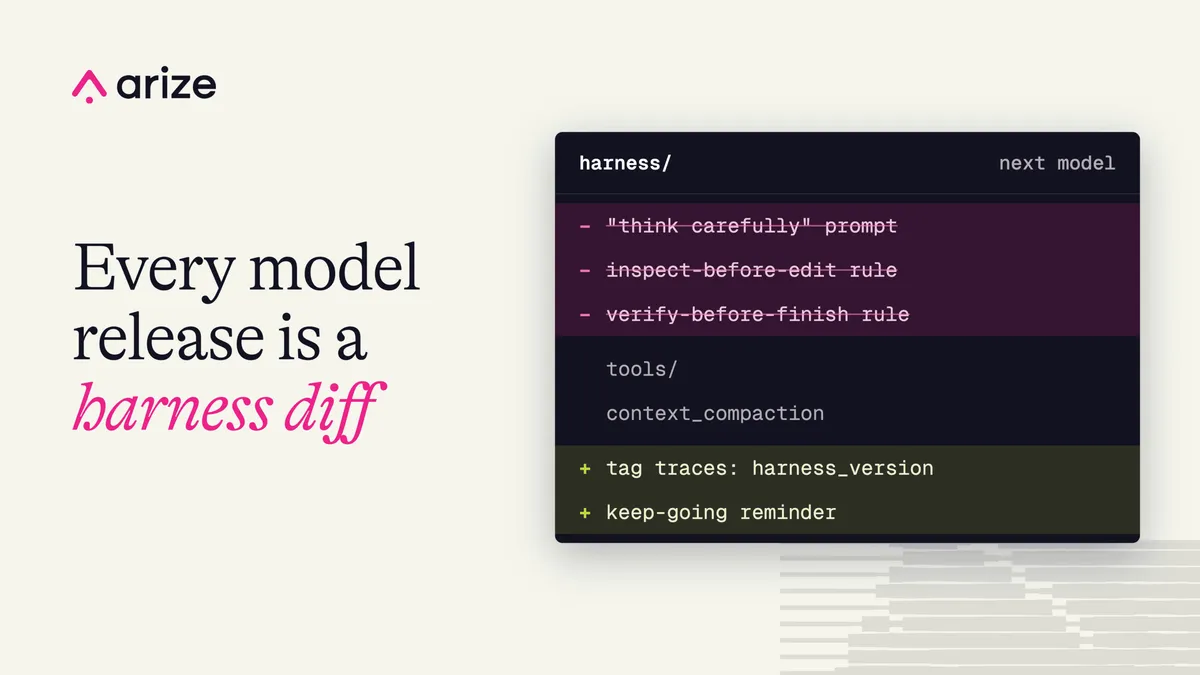
Anthropics Prompting-Leitfaden für Opus 5.5, der in der Woche des Beitrags erschien, weist in beide Richtungen. Er empfiehlt, „think carefully“-Anweisungen zu löschen, weil das Modell den Umfang seines Denkens nun selbst bestimmt, und rät, für Diagramme und Screenshots gebautes Scaffolding erneut zu testen. Zugleich fügt er Harness-Bausteine hinzu: einen Absatz im Systemprompt, der unbeaufsichtigte Agenten am vorzeitigen Abbruch hindert, eine Erinnerung, die gesendet wird, wenn ein langer Lauf verstummt, und Zeitbudgets für Multi-Agenten-Setups.
Das Automatisieren von Harness-Updates birgt eigene Risiken. Googles RRSI-Paper stellte fest, dass uneingeschränkte automatische Harness-Evolution überanpasst. In den Tests erzielte die uneingeschränkte Variante bei den Aufgaben, für die sie evolviert wurde, den höchsten Wert aller Varianten, lag aber bei ungesehenen Benchmarks innerhalb eines Punkts vom ursprünglichen, nicht evolvierten Harness. Die Lösung von RRSI ist laut Arize weitgehend Buchführung: Für jede vorgeschlagene Änderung wird festgehalten, welche Komponente sie betrifft, was sie beheben sollte, der Diff und wie sich Score und Kosten verändert haben.
Was das für Agenten-Entwickler bedeutet
Arizes Fazit lautet: Teams brauchen weiterhin einen Harness, sollten aber damit rechnen, ihn zu verwerfen und neu aufzubauen, wenn die Modelle besser werden. Bestand haben die Teile, die an die eigenen Tools, Daten, Nutzer und die Umgebung einer Anwendung gebunden sind. Verallgemeinerbare Abläufe kommen als Kandidaten dafür infrage, ins Modell hineintrainiert zu werden, während Fachwissen und Kontextmanagement eher im Harness bleiben. Der praktische Rat: den Neuaufbau mit Schutzmaßnahmen gegen Überanpassung automatisieren, statt ihn mit jeder Modellgeneration als manuelle Pflichtübung zu behandeln.
Arize AI: Are agent harnesses dying? What harness distillation changes