Inworld startet Inference-Dienst für Consumer-KI-Apps
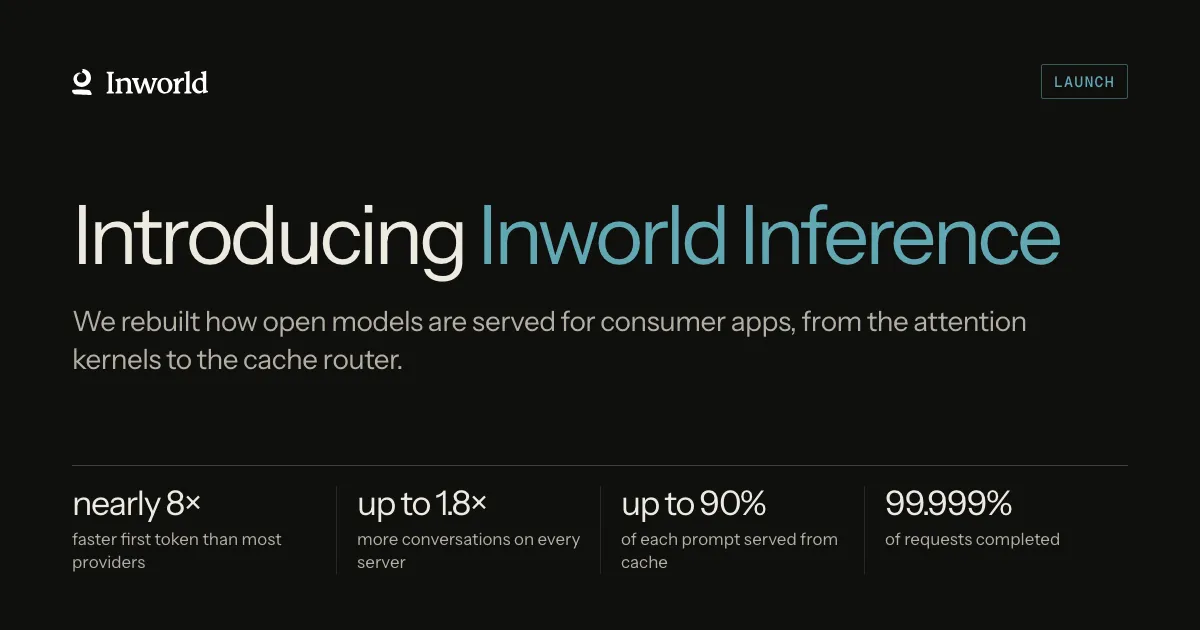
Inworld AI hat Inworld Inference für alle Entwickler geöffnet und bezeichnet den Dienst als ersten Inference-Service, der speziell für Consumer-KI gebaut wurde. Laut Unternehmen liefert er das erste Token bis zu 7,8-mal schneller als der mittlere Anbieter auf OpenRouter, bei niedrigeren Eingabepreisen und hoher Zuverlässigkeit.
- Inworld Inference steht allen Entwicklern offen und konzentriert sich auf offene Modelle für Consumer-KI-Apps, darunter Gemma 4, GLM, DeepSeek und MiMo.
- Bei Gemma 4 26B meldet Inworld ein erstes Token bei p95 von 0,31 s, das 7,8-mal schneller ist als beim mittleren OpenRouter-Anbieter.
- Eingaben für Gemma 4 26B kosten 0,07 Dollar pro 1 Mio. Tokens, gegenüber einem Median von 0,1115 Dollar bei Anbietern, die nicht auf Nutzerdaten trainieren.
- Bei GLM 5.3 Flash wurden laut Inworld 99,999 % von mehr als 20 Millionen Anfragen in 30 Tagen fehlerfrei abgeschlossen.
- Bis zu 90 % jedes Prompts kommen aus dem Cache, Eingaben aus dem Cache sind bis zu 99 % günstiger.
Was Inworld anbietet
Inworld Inference listet nicht Tausende Modelle auf. Stattdessen setzt das Unternehmen nach eigenen Angaben auf Tiefe bei den offenen Modellen, die Consumer-Apps wählen, darunter Gemma 4, GLM, DeepSeek und MiMo. Jedes Modell erhält laut Inworld einen eigenen Serving-Build.
Zu den genannten Techniken zählen neue Attention-Kernel, Echtzeit-Dekodierung, bei der ein kleines Entwurfsmodell vorausschreibt und das vollständige Modell das Ergebnis in einem Durchgang prüft, Gewichte mit geringerer Präzision, "wo immer die Evals standhalten", sowie ein Router, der jede Gesprächsrunde zu dem Server zurückleitet, der deren Kontext bereits vorhält. Inworld zufolge wird jeder Build nur ausgeliefert, wenn er die Eval-Werte des Vorgängers erreicht.
Entwickler können die gehosteten Modelle ohne Ratenbegrenzung und mit einer Service-Stufe pro Anfrage nutzen, über mehrere Modelle mit automatischem Failover routen oder ein eigenes Modell für ein dediziertes Deployment mitbringen.
Warum Consumer-KI eine andere Last ist
Inworld argumentiert, dass sich Consumer-Apps in fast jeder Hinsicht von Unternehmens- und Coding-Anwendungen unterscheiden. In Gesprächen lassen Menschen zwischen den Beiträgen 0 bis 300 ms Pause, das erste Token muss also deutlich innerhalb dieses Fensters eintreffen. Das mediane erste Token bei Gemma 4 26B liege inzwischen bei 117 ms, sodass der größte Teil des Fensters für Sprachsynthese und Netzwerkzeit bleibe.
Außerdem sind Prompts im Verhältnis zu den Antworten lang. Jede Runde sendet den gesamten Verlauf erneut, und bei den Apps, die Inworld in den 28 Tagen bis zum 23. September bediente, war der mediane Prompt 13- bis 36-mal so lang wie die Antwort. Eine einzelne Interaktion kann zudem in viele Modellaufrufe münden, etwa für Moderation, Gedächtnis, Ranking und die Antwort selbst. Weil Nutzer 5 bis 20 Dollar im Monat oder gar nichts zahlen, muss jeder Aufruf laut Inworld fast nichts kosten. Ziel seien Kosten von wenigen Cent pro Nutzer und Tag.
Inworld verweist auch auf die Marktgröße: Das Unternehmen zitiert a16z mit PNC-Daten, wonach nur 2 % der US-Haushalte und 3 % der US-Verbraucher überhaupt Geld für KI ausgeben.
Die von Inworld genannten Zahlen
Alle folgenden Angaben stammen von Inworld und beruhen auf eigenen Router-Messungen und auf OpenRouter-Daten, die das Unternehmen als Momentaufnahmen und nicht als Benchmark mit vergleichbarer Last beschreibt.
- Geschwindigkeit bei Gemma 4 26B: ein medianes erstes Token von 0,17 s und ein p95 von 0,31 s, gegenüber 0,61 s und 2,42 s beim mittleren Anbieter. Das ist bei p50 3,6-mal und bei p95 7,8-mal schneller.
- Preis bei Gemma 4 26B: 0,07 Dollar pro 1 Mio. Eingabetokens, gegenüber 0,1115 Dollar im Median der 12 OpenRouter-Anbieter, die nicht auf Nutzerdaten trainieren, zu Listenpreisen vom 12. Oktober 2026.
- MiMo 2.6 Pro: der niedrigste Eingabepreis unter den Anbietern auf OpenRouter, mit einem medianen ersten Token von 0,39 s und einem p95 von 0,91 s. Laut Inworld ist das im Median 2,6-mal und bei p95 4,6-mal schneller als beim nächstschnelleren Anbieter.
- Zuverlässigkeit: Bei GLM 5.3 Flash wurden 99,999 % von mehr als 20 Millionen Anfragen in 30 Tagen fehlerfrei abgeschlossen. Inworld zählte 98 Fehlschläge, darunter Serverfehler, Timeouts und Kapazitätsabweisungen.
- Effizienz: Dieselbe Hardware bedient das 1,8-Fache der Anfragen im Vergleich zum September, bei schnellerem medianem ersten Token.
- Caching: Bis zu 90 % jedes Prompts kommen aus dem Cache, und Eingaben aus dem Cache kosten bis zu 99 % weniger.
Inworld zufolge sind die eigenen Eingabepreise bei drei der fünf vorgestellten Modelle die niedrigsten aller Anbieter, die nicht auf Nutzerdaten trainieren.
Skalierung und Folgen für Entwickler
Nach Angaben von Inworld stammt fast jedes ausgelieferte Token aus Consumer-Apps, es seien zig Billionen Tokens im Monat und damit 25-mal so viele wie im März. Bei den meistgenutzten Gemma-4-Modellen verarbeite das Unternehmen bis zu 1,8-mal so viele Tokens pro Tag, wie OpenRouter öffentlich für alle seine Anbieter zusammen ausweist, basierend auf Daten vom 4. bis 10. Oktober 2026.
Für Entwickler von Sprachbegleitern, Tutoren oder Coaching-Apps lautet das Argument, dass Tempo, Preis und Verfügbarkeit zusammenhängen. Langsame Antworten treiben Nutzer zurück zu Schaltflächen, und ein zehnminütiger Ausfall kann sie zur Konkurrenz schicken. Ob die Zahlen für eine konkrete App gelten, hängt vom eigenen Traffic ab, denn Inworld selbst weist darauf hin, dass die Vergleiche kein Benchmark mit vergleichbarer Last sind.
Inworld AI: Introducing Inworld Inference