Furiosa SDK 2026.4 steigert Tokens pro Watt beim RNGD und bringt gestuftes KV-Caching
FuriosaAI hat das Furiosa SDK 2026.4 für seinen RNGD-Beschleuniger veröffentlicht und meldet eine höhere Token-Generierung pro Watt bei 18 Modellen im Vergleich zum SDK 2026.3. Laut Unternehmen fallen die größten Zuwächse bei Mixture-of-Experts-Modellen an, angeführt von GPT-OSS-120B mit +138 %.
- Das Furiosa SDK 2026.4 für RNGD steigert laut FuriosaAI die Tokens pro Watt bei 18 Modellen gegenüber dem SDK 2026.3.
- Die größten Zuwächse: GPT-OSS-120B (+138 %), GPT-OSS-20B (+57 %) und Qwen3-30B-A3B (+43 %).
- Ein experimenteller dreistufiger KV-Cache dehnt die Präfix-Wiederverwendung auf Host-RAM und gemeinsamen Cluster-Speicher aus, mit Mooncake als erstem Backend.
- Vision-Language-Modelle laufen nun auf dem Standard-FCFS-Scheduler, mit gebündelter Vision-Kodierung und Wiederverwendung von Bild-Embeddings.
- Modelle werden jetzt als Furiosa Executable Bundles mit vorkompilierten Kernels ausgeliefert und starten ohne Kompilierung auf dem Serving-Host.
Effizienzgewinne vor allem bei MoE-Modellen
Nach Angaben von FuriosaAI ist das SDK 2026.4 in diesem Jahr die vierte große Software-Veröffentlichung für RNGD und über das Developer Portal verfügbar. Das Unternehmen berichtet von mehr Tokens pro Watt bei 18 Modellen im Vergleich zum SDK 2026.3.
Die größten Verbesserungen gibt es laut FuriosaAI bei MoE-Modellen:
- GPT-OSS-120B: +138 %
- GPT-OSS-20B: +57 %
- Qwen3-30B-A3B: +43 %
FuriosaAI erklärt außerdem, RNGD befinde sich nun bei TSMC in Serienfertigung. Niedrigere Kosten pro Token und eine Ausführung per Drop-in-Software machten die Plattform nach Ansicht des Unternehmens zu einer starken Option für Unternehmen, die anspruchsvolle KI-Workloads in bestehenden luftgekühlten Rechenzentren betreiben wollen.
Zwei weitere Änderungen zielen auf die Decoding-Geschwindigkeit. Das profilgesteuerte Decode-Batching, das gemessene NPU-Ausführungs- und I/O-Kosten nutzt, um Decode-Batches und die Bucket-Auswahl zu optimieren, ist für generative Modelle jetzt standardmäßig aktiviert. In Benchmarks mit GPT-OSS-120B (TP=32, DP=1) steigerte es laut FuriosaAI den Durchsatz an Ausgabe-Tokens auf ShareGPT über 20 vergleichbare Konfigurationen hinweg im Median um 22,7 % und senkte die mittlere Zeit pro Ausgabe-Token im Median um 16,0 %. Die Ergebnisse hängen vom Workload ab, und beim ersten Laden eines Modells kann ein Profiling von ein bis zwei Minuten anfallen. Das SDK bringt zudem Verbesserungen beim Token-Sampling, das für die Zeit pro Ausgabe-Token auf dem kritischen Pfad liegt.
Experimenteller hierarchischer KV-Cache
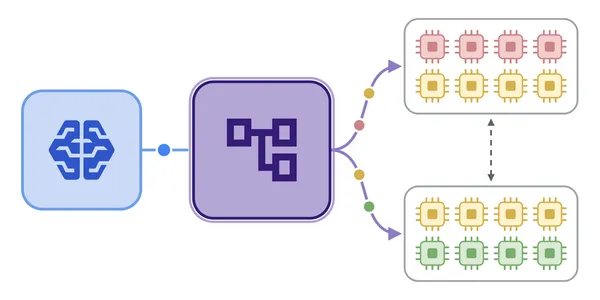
Prefix-Caching vermeidet wiederholtes Prefill bei langen, gemeinsam genutzten Kontexten, doch ein herkömmlicher Cache ist durch den NPU-DRAM begrenzt. Sobald ein Präfix verdrängt wurde, muss eine spätere Anfrage es neu berechnen. SDK 2026.4 führt einen experimentellen hierarchischen KV-Cache ein, der die Wiederverwendung auf drei Ebenen ausdehnt:
- L1, NPU-DRAM: die aktiven Blöcke mit der geringsten Latenz, die die Attention direkt nutzt.
- L2, Host-Speicher: verdrängte oder gesicherte Blöcke werden per DMA kopiert und können neu geladen statt neu berechnet werden.
- L3, externer Speicher: ein optionales Backend, das Präfixe über den lokalen Prozessspeicher hinaus vorhält. Ein gemeinsam genutztes Backend ermöglicht es anderen Furiosa-LLM-Replikaten im Cluster, sie wiederzuverwenden.
Mooncake ist das erste unterstützte L3-Backend und bietet inhaltsadressierten, clusterweiten Präfix-Speicher sowie asynchrone Transfers außerhalb des kritischen Pfads des Schedulers. Eine Backend-unabhängige Connector-Schnittstelle soll es erlauben, später weitere Speichersysteme anzubinden. Die Version ersetzt zudem die getrennten Implementierungen des rein globalen und des hybriden Prefix-Caches durch eine einheitliche Radix-Tree-Implementierung.
Für L2 gelten zwei Schreibrichtlinien. Write-through kopiert ein Präfix nach L2, sobald es eine bestimmte Anzahl von Malen wiederverwendet wurde (Standard: 2); das eignet sich für Systeme mit reichlich Bandbreite zwischen NPU und Host sowie genügend Host-Speicher. Write-back schreibt beim Verdrängen aus L1 nach L2, was doppelte Speicherung reduziert, aber möglicherweise die Latenz beim Verdrängen erhöht. Beide lassen sich gemeinsam aktivieren.
Die Funktion ist standardmäßig deaktiviert, und ihre Optionen sind in der Hilfeausgabe von furiosa-llm serve ausgeblendet, solange Richtlinien und Standardwerte abgestimmt werden. L2 wird mit einem Host-Speicherbudget aktiviert, zum Beispiel --experimental-kv-offload-host-memory-gb 64. L3 erfordert eine kompatible Mooncake-Bereitstellung und die Installation der Shared Library.
Vision-Language-Modelle und breitere Modellabdeckung
Die im SDK 2026.3 eingeführte Vision-Language-Unterstützung läuft nun durchgängig auf dem Standard-FCFS-Scheduler. Laut FuriosaAI fallen damit reine Text- und Bild-Text-Anfragen unter dieselbe Infrastruktur für Scheduling, Prefix-Cache und Datenparallelität, statt unter eine separate Proof-of-Concept-Schleife. Drei Optimierungen greifen: gebündelte Vision-Kodierung über Anfragen hinweg, überlappende Bildvorbereitung auf dem Host mit der Textgenerierung auf der NPU sowie die Wiederverwendung zwischengespeicherter Bild-Embeddings über Gesprächsrunden und datenparallele Worker hinweg.
Auch die Modellliste wächst. Neu abgedeckt oder erweitert sind unter anderem:
- Gemma 4 (31B Vision-Language) und EXAONE 4.5 (33B Vision-Language)
- Qwen3-VL 2B und 4B Instruct/Thinking
- Qwen3 Embedding und Reranker in den Größen 0,6B und 4B
- Mistral NeMo 12B (Mistral-Nemo-Instruct-2407-FP8)
- Dynamisch quantisierte FP8-Varianten von Llama 3.1 und Llama 3.3
- BGE-M3, BGE Reranker v2 M3, E5-Mistral-7B-Instruct und Harrier OSS v1 (0,6B)
In der Zusammenfassung von FuriosaAI ist zudem experimentelles MTP-Speculative-Decoding für EXAONE 4.5 aufgeführt.
Was das für RNGD-Nutzer bedeutet
Mit der Version ist der Umstieg auf Furiosa Executable Bundles (FXB) abgeschlossen. Laut FuriosaAI werden veröffentlichte Modelle nun mit vorkompilierten Kernels ausgeliefert und starten, ohne auf dem Serving-Host zu kompilieren.
Teams, die von 2026.3 aktualisieren, sollten vor dem Wechsel den Abschnitt zu Breaking Changes und Deprecations sowie die Upgrade-Anleitung lesen. Für Unternehmen, die RNGD betreiben, nennt das Unternehmen als wichtigste praktische Effekte eine bessere Effizienz bei großen MoE-Modellen, schnelleren Start und eine breitere Auswahl unterstützter Generierungs-, Multimodal- und Retrieval-Modelle. Der hierarchische Cache ist experimentell, der Produktiveinsatz hängt daher von weiterer Abstimmung durch FuriosaAI ab.