Inworlds Realtime TTS-2 denkt vor dem Sprechen: Reasoning legt fest, wie eine Zeile klingen soll
Inworld AI hat zwei Updates für Realtime TTS-2 veröffentlicht, sein Text-to-Speech-Modell. Laut Unternehmen ist es mit Reasoning das erste Sprachmodell, das vor dem Sprechen entscheidet, wie eine Zeile gesprochen werden soll. Zudem erzeugt ein überarbeitetes Modell Sprache schneller und bleibt bei langen Texten und Sitzungen konsistenter.
- Laut Inworld ist Realtime TTS-2 mit Reasoning das erste Sprachmodell, das vor dem Sprechen entscheidet, wie eine Zeile gesprochen werden soll.
- Reasoning ist optional, wird über ein Feld in der Anfrage aktiviert und funktioniert bei TTS-2-Synthese sowie Streaming- und Async-Anfragen; WebSocket, Duplex und Batch folgen demnächst.
- Im Vergleich zum bisherigen TTS-2 werden kurze Äußerungen laut Inworld etwa 13 % und mittellange etwa 9 % schneller erzeugt.
- Cekura stuft Realtime TTS-2 Flash ohne Streaming als das schnellste von 27 Modellen ein, mit einem Median von 46 ms bis zum ersten Ton.
- Realtime TTS-2 sprach im Cekura-Benchmark 93,4 % der schwierigen Testfälle korrekt.
Reasoning: eine Vortragsanweisung vor der Synthese
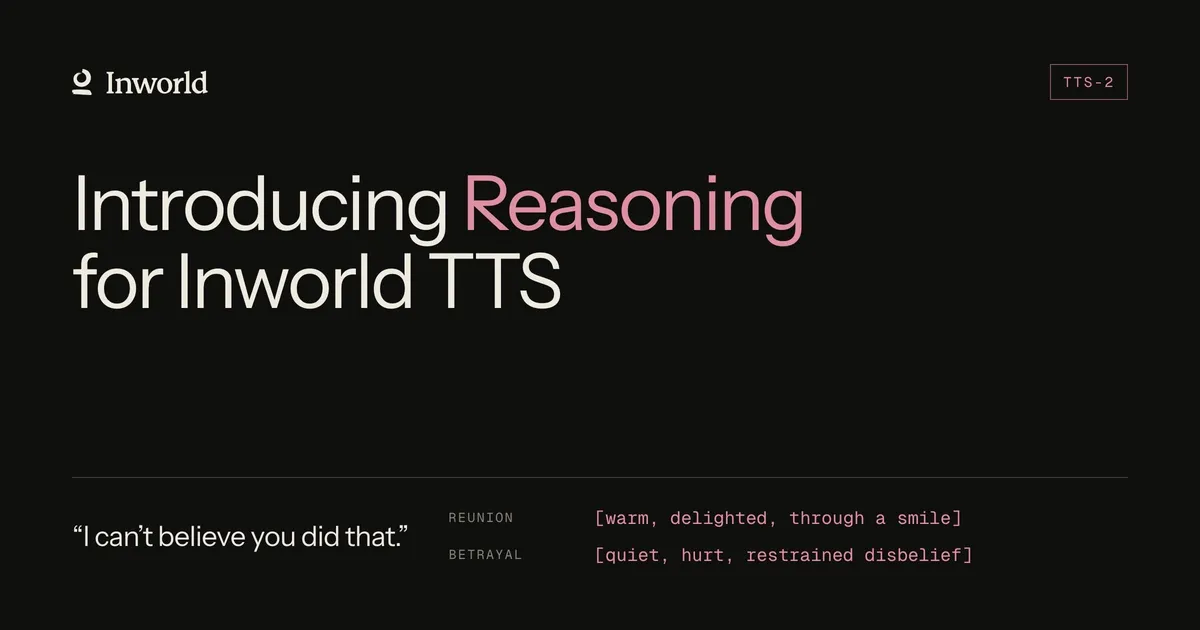
Inworld argumentiert, Sprachmodelle läsen den vorgegebenen Text, doch nichts sage ihnen, wie er klingen solle. Ein Satz wie "I can't believe you did that." kann Freude, Verletztheit oder Unglauben ausdrücken, und ohne Kontext liefert das Modell in jedem Fall dieselbe neutrale Lesart. In Verbraucher-Apps, in denen ein LLM jede Antwort zur Laufzeit schreibt, ist niemand da, der diese Anweisung von Hand ergänzt.
Reasoning fügt innerhalb derselben TTS-2-Anfrage einen Schritt hinzu. Das Modell liest den Text und jeden vom Entwickler mitgesendeten Kontext, formuliert eine kurze Vortragsanweisung und setzt sie dann um. Der Reasoning-Schritt ist ein Sprachmodell, dessen einzige Aufgabe es ist, diese Anweisung zu schreiben. In Inworlds Beispiel erhält dieselbe Zeile mit dem Kontext "A friend has arranged an unexpected reunion" die Anweisung "warm, delighted, speaking through a smile", während eine Zeile nach dem Geständnis eines Verrats durch den Partner "quiet, hurt, with restrained disbelief" bekommt.
Ausdrückliche Anweisungen und Inline-Tags des Entwicklers haben stets Vorrang vor der Anweisung, die Reasoning schreibt. Die Anweisung wird in der API-Antwort zurückgegeben, sodass sie neben der Eingabe protokolliert und der Kontext angepasst werden kann, wenn eine Lesart nicht stimmt.
Davon grenzt Inworld Emotions-Tags ab: eine feste Liste von Labels wie [happy], die jemand, meist das LLM des Entwicklers anhand von Prompt-Regeln, für jede Zeile auswählen muss. Reasoning schreibt stattdessen eine frei formulierte Anweisung, die Emotion, Tonfall und Tempo zugleich festlegen kann.
Anwendung und Verfügbarkeit
Reasoning ist optional und benötigt ein einziges Feld in der Anfrage. Entwickler setzen reasoning innerhalb von synthesisContext auf REASONING_ON und übergeben den Kontext in einem separaten Feld namens reasoningContext. Der Kontext prägt den Vortrag, wird aber nie gesprochen. Beide Updates laufen unter derselben öffentlichen Modell-ID, inworld-tts-2, und erreichen bestehende Integrationen automatisch, sobald sie nach Serverregion ausgerollt werden.
Zum Start funktioniert Reasoning bei TTS-2-Synthese sowie bei Streaming- und Async-Anfragen. Laut Inworld eignet sich das für Audio, das pro Nachricht oder vorab erzeugt wird:
- Sprachnachrichten eines Companions oder Coaches
- generierte Geschichten, Zusammenfassungen und Lektionen
- Hörbücher
- vorab generierte Figurenzeilen für Spiele und Social-Apps
WebSocket-Streaming, Duplex (einschließlich Realtime API) und Batch-Synthese sind als demnächst verfügbar angekündigt.
Schnellere und stabilere Erzeugung
Das aktualisierte Modell zielt auf Fehler, die in realen Anwendungen auftreten, etwa eine Stimme, die sich allmählich verändert, ein ausgelassenes Wort in einem langen Abschnitt oder ein verschluckter Konsonant am Satzende. Im Vergleich mit der Vorgängerversion von TTS-2 werden laut Inworld kurze Äußerungen etwa 13 % schneller und mittellange etwa 9 % schneller erzeugt. Auch die Erzeugungsgeschwindigkeit ist über verschiedene Eingabelängen hinweg gleichmäßiger, was für Agenten und Tutoren wichtig ist, deren Antworten von wenigen Wörtern bis zu einer langen Erklärung reichen.
Inworld betont, dass diese Zahlen sich nur auf die TTS-Erzeugung beziehen. Die Verzögerung, die ein Zuhörer erlebt, hängt außerdem von Turn-Erkennung, Sprachmodell-Generierung, Netzwerkübertragung und Wiedergabepufferung ab; diese sollten laut Inworld separat gemessen werden.
Bei der Stimmqualität verbessert das Update nach Angaben des Unternehmens die Stimmähnlichkeit im Stable-Modus, besonders bei Stimmen, die sich bisher schwer genau klonen ließen, und verringert das Abdriften der Stimme in langen Duplex-Sitzungen. Zudem behebt es Fälle, in denen TTS-2 in langen Äußerungen Wörter übersprang oder Plosive wie /p/, /t/ und /k/ bei manchen Wortendungen verlor. Der Creative-Modus liefert nun mit leichter integrierter Steuerung einen natürlicheren Vortrag. Inworld empfiehlt den Stable-Modus, wenn Konsistenz am wichtigsten ist, und den Creative-Modus dort zu testen, wo ein ausdrucksstärkerer Vortrag passt.
Benchmark-Werte und Folgen für Entwickler
Inworld verweist auf den unabhängigen Benchmark von Cekura mit Ergebnissen, die am 28. Oktober 2026 aktualisiert wurden. Für Realtime TTS-2 Flash maß Cekura bis zum ersten hörbaren Ton einen Median von 46 ms und ein p90 von 73 ms, wenn der vollständige Text vorab vorliegt, und stuft es in der Kategorie ohne Streaming als das schnellste der 27 getesteten Modelle ein. Wortweise Eingabe ist ein eigener Test. Für Realtime TTS-2 ermittelte der Benchmark, dass 93,4 % der schwierigen Testfälle korrekt gesprochen wurden, darunter Zahlen und Kürzel, Codes und Adressen, kontextabhängige Wörter und medizinische Begriffe.
Für Entwickler von Companions, Sprachagenten, Hörbüchern oder Spielfiguren ändert sich praktisch, dass ein ausdrucksstarker Vortrag weder ein Tag-Vokabular noch von Hand getaggte Skripte erfordert: Sie aktivieren Reasoning und übergeben den Kontext, den sie ohnehin haben. Inworld rät, die Verbesserungen an vollständigen Passagen und langen Sitzungen zu testen, geklonte Stimmen mit ihren Referenzen zu vergleichen, frühe und späte Samples auf Drift zu prüfen und die Ausgabe auf ausgelassene Wörter gegen den Quelltext abzugleichen.
Inworld AI: Realtime TTS-2 updates: reasoning, speed and consistency