MLflow-Test: Jev übersieht bei schwierigerem LLM-Judge-Test subtile Fehler
Das Judge-Modell Jev von TypeSafe stimmte in einem schwierigeren MLflow-Test bei 64 von 72 Antworten mit den menschlichen Bewertungen überein, GPT-OSS-120B dagegen bei allen 72. Jev war deutlich schneller und günstiger, und die Weiterleitung seiner unsicheren Urteile an GPT-OSS schloss in diesem Datensatz die Lücke.
- Jev stimmte in zwei Durchläufen jeweils bei 64 von 72 Antworten mit den menschlichen Bewertungen überein, GPT-OSS-120B bei allen 72.
- Die mediane Latenz von Jev lag bei 0,20 Sekunden, bei GPT-OSS-120B bei 1,44 Sekunden.
- Die geschätzten Kosten von Jev betrugen rund 0,020 US-Dollar pro 1.000 Bewertungen, ohne Gebühren für den Kauf von Guthaben.
- Die Weiterleitung von Urteilen mit Wahrscheinlichkeiten von 0,2 bis 0,8 an GPT-OSS ergab 72 von 72 Übereinstimmungen, der Bereich wurde jedoch erst nach Sichtung der Daten gewählt.
- MLflow 3.17, das noch nicht erschienen ist, wird Jev über die Modell-URI typesafe:/ unterstützen.
Ein härterer Testdatensatz aus fast richtigen Antworten
In Teil 1 der Serie verglich MLflow Jev mit GPT, Claude und DeepSeek als Judges für Antworten auf MLflow-Fragen. Laut diesem Beitrag stimmte Jev bei allen 30 menschlichen Bewertungen überein, bei der niedrigsten gemessenen Latenz und den geringsten geschätzten Kosten. Teil 2 fragt, ob das Modell auch dann noch Fehler erkennt, wenn Antworten fast richtig sind.
Jev ist das Modell von TypeSafe für strukturierte Entscheidungen. Anhand einer Frage, der passenden Dokumentation und einer Kandidatenantwort gibt es die Wahrscheinlichkeit zurück, dass die Antwort korrekt ist, und zwar ohne schriftliche Begründung. In diesem Test galt eine Wahrscheinlichkeit von mindestens 0,5 als korrekt.
Das Team erstellte 12 Fragen mit jeweils einer richtigen und zwei subtil falschen Antworten, auf Englisch und Japanisch, insgesamt also 72 Antworten. Zu den falschen Antworten zählten falsche API-Namen, vertauschte Rollen von Quelle und Ziel, fehlende Berechtigungen und korrekte Aussagen, auf die eine falsche Einschränkung folgte. Bei drei Fragen wurden die richtigen Antworten zusätzlich umformuliert, um zu prüfen, ob eine andere Wortwahl zur Ablehnung führt. Verglichen wurden typesafe/jev-1.13 und gpt-oss-120b.
Ergebnisse: Jev akzeptiert einige fast richtige Antworten
Der gesamte Datensatz wurde zweimal durchlaufen. Jev stimmte in jedem Durchlauf bei 64 von 72 Antworten mit den menschlichen Bewertungen überein, in jeder Sprache bei 32 von 36. GPT-OSS-120B stimmte bei allen 72 überein. Jev akzeptierte jede richtige Antwort, auch die Umformulierungen, und erkannte Fehler wie eine falsche Aufbewahrungsfrist oder ein vertauschtes Ja/Nein-Fazit. Seine Fehler waren fast richtige Antworten mit einem gravierenden Fehler.
MLflow zitierte drei falsche englische Antworten, die Jev akzeptierte:
- Vertauschte Bedeutung: Die Antwort nutzte WHEN NOT MATCHED THEN INSERT, behauptete aber, es gelte für Zielzeilen ohne Entsprechung in der Quelle. Tatsächlich werden Quellzeilen eingefügt, die im Ziel keine Entsprechung haben.
- Fehlende Berechtigung: Die Antwort besagte, CREATE SECRET und USE SCHEMA auf main.default genügten, doch für Nutzer, denen das Schema nicht gehört, fehlte die erforderliche Berechtigung USE CATALOG.
- Falscher Befehl: Auf die Frage, ob ein DELETE auf einer Tabelle mit Deletion Vectors die Parquet-Dateien sofort neu schreibt, lautete die Antwort korrekt Nein, nannte dann aber VACUUM ... APPLY (PURGE). Laut dem Dokumentationsauszug werden Zeilen entfernt, wenn Dateien neu geschrieben werden, etwa durch OPTIMIZE oder REORG TABLE ... APPLY (PURGE).
Tempo, Kosten und Weiterleitung unsicherer Fälle
Die mediane Latenz von Jev lag bei 0,20 Sekunden, bei GPT-OSS-120B bei 1,44 Sekunden, in diesem Aufbau also etwa siebenmal schneller. Die Werte stammen aus zwei Durchläufen mit je 144 Messungen pro Judge. Die geschätzten Inferenzkosten von Jev lagen bei rund 0,020 US-Dollar pro 1.000 Bewertungen, ohne Gebühren für den Kauf von Guthaben. GPT-OSS erzeugte im Schnitt 224 Ausgabe-Tokens pro Bewertung, einschließlich der Reasoning-Schritte.
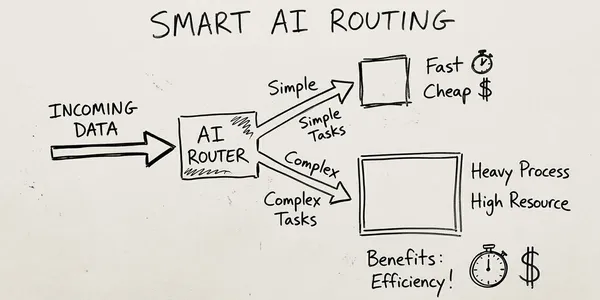
Anschließend untersuchte das Team, ob sich anhand der Wahrscheinlichkeiten von Jev Urteile markieren lassen, die eine zweite Prüfung brauchen. In beiden Durchläufen lagen alle fälschlich akzeptierten Antworten bei etwa 0,5 bis 0,8, während jede richtige Antwort mindestens 0,91 erreichte. Wären Urteile im Bereich von 0,2 bis 0,8 zur Zweitmeinung an GPT-OSS gegangen, hätten weniger als 20 Prozent diese gebraucht, und die kombinierten Urteile hätten mit allen menschlichen Bewertungen übereingestimmt. In Durchlauf 1 wurden 12 von 72 Urteilen weitergereicht, in Durchlauf 2 waren es 13 von 72. Beide erreichten eine Übereinstimmung von 72 von 72.
MLflow weist darauf hin, dass der Bereich erst nach Sichtung derselben Daten gewählt wurde und daher eher als Ausgangspunkt denn als Regel zu verstehen ist. Bei wiederholten Aufrufen mit identischen Eingaben erreichte eine falsche Akzeptanz einen Wert von 0,82 und wäre damit außerhalb des Bereichs gelandet.
Jev mit make_judge nutzen und die nächsten Schritte
MLflow 3.17 ist noch nicht erschienen. Laut dem Beitrag wird es Jev in integrierten Scorern und eigenen Judges über die Modell-URI typesafe:/ unterstützen. Das Beispiel im Beitrag definiert mit make_judge einen booleschen Judge mit dem Modell typesafe:/jev-latest und setzt TYPESAFE_API_KEY in der Umgebung voraus. MLflow speichert das Wahr/Falsch-Urteil als jev_correctness und die Wahrscheinlichkeit in den Feedback-Metadaten unter typesafe.probability. Das Beispiel läuft auf der aktuellen stabilen Version nicht, und da es jev-latest und leicht abweichende Anweisungen gegenüber dem Benchmark (typesafe/jev-1.13) verwendet, können die Ergebnisse abweichen.
Für Teams, die einen Wechsel erwägen, ist der Rat des Beitrags pragmatisch: Eine Antwort kann plausibel klingen und Nutzern dennoch den falschen Befehl oder unvollständige Berechtigungen liefern, deshalb gehören solche Fälle in jede Judge-Evaluierung. MLflow empfiehlt, mit einem bestehenden Korrektheitskriterium und einem kleinen gelabelten Datensatz zu beginnen, Jev parallel zum aktuellen Judge laufen zu lassen, falsche Akzeptanzen zu prüfen und jeden Schwellenwert für die Weiterleitung an neuen Beispielen zu testen.