Lila Sciences und Anyscale trainieren GLM-5.3-Flash mit Sequenzen aus 1 Mio. Tokens
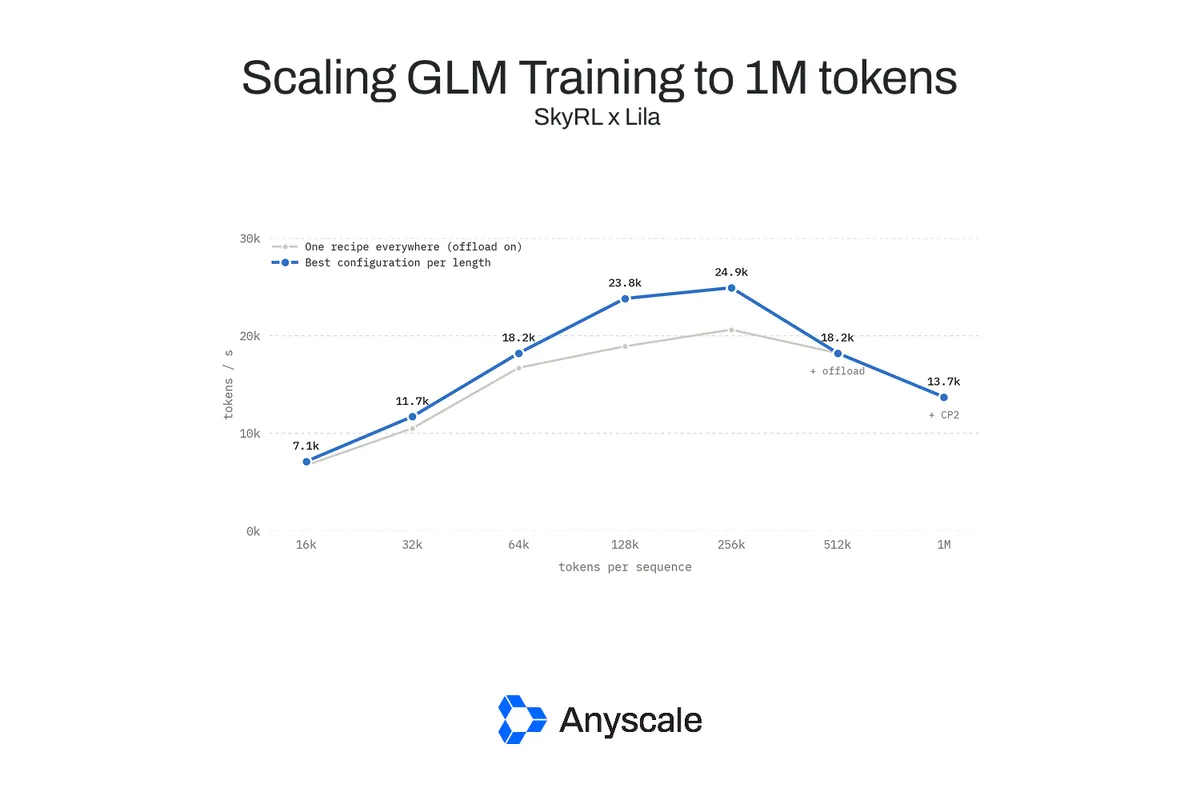
Lila Sciences und Anyscale haben das offene Modell GLM-5.3-Flash mit Sequenzen aus 1 Million Tokens auf 64 B200-GPUs trainiert. Nach Angaben der Teams erweitert die Arbeit ihren Trainings-Stack auf Sequenzen, die 64-mal länger sind als zu Beginn des Projekts.
- GLM-5.3-Flash wurde mit Sequenzen aus 1 Mio. Tokens trainiert.
- Das Training nutzte 64 B200-GPUs und den Open-Source-Stack SkyRL.
- Bei 1 Mio. Tokens belegte die Arbeitslast 144,5 GiB pro GPU.
- Das Fine-Tuning mit dem menschlichen Genom verringerte den Verlust auf zurückgehaltenen Daten in 80 Schritten um 4,8 Prozent.
- Mehrere Korrekturen sollen in Megatron-LM übernommen werden.
Ein offener Stack für lange wissenschaftliche Daten
Das Projekt zielt auf eine Herausforderung in der wissenschaftlichen KI: Wichtige Strukturen können sich über ein Genom, verwandte Protein- oder RNA-Sequenzen oder ein mehrere Tage laufendes Experiment erstrecken. In einem autonomen Labor kann der Kontext durch Hypothesen, Protokolle und Messwerte von Geräten ebenfalls auf Hunderttausende Tokens anwachsen.
Viele offene Modelle unterstützen laut Anyscale einen Kontext von 1 Mio. Tokens, liefern bei dieser Länge ohne zusätzliches Training aber möglicherweise nicht die erforderliche Leistung. Lila Sciences und Anyscale trainierten GLM-5.3-Flash mit Aufgabedaten in voller Länge, statt den Kontext zu kürzen oder stark zu verdichten. Zum Einsatz kam SkyRL, ein Open-Source-Trainings-Stack. Mehrere Korrekturen sollen zudem in Megatron-LM übernommen werden.
Speicher und Durchsatz waren die größten Einschränkungen
Bei einer Sequenzlänge von 1 Mio. Tokens belegte die Arbeitslast 144,5 GiB pro GPU und blieb damit unter den 178 GiB der B200. Die Teams meldeten auf 64 B200-GPUs einen Durchsatz von 13,7k Tokens pro Sekunde bei 1 Mio. Tokens sowie einen Spitzenwert von 24,9k Tokens pro Sekunde bei 256k Tokens.
GLM-5.3-Flash kombiniert 34 Schichten mit linearer Aufmerksamkeit und Kimi Delta Attention mit 11 Schichten, die DeepSeek Sparse Attention verwenden. Außerdem verfügt das Modell über einen viermal breiteren Residual-Stream als üblich sowie Mixture-of-Experts-Schichten. Die Forschenden mussten jede Komponente optimieren, weil der Speicherbedarf mit der Sequenzlänge steigt, während die Aufmerksamkeit quadratisch wachsen kann.
Unter anderem korrigierten sie Sparse-Attention-Schichten, die unbemerkt auf dichte Aufmerksamkeit zurückfielen, verteilten die Berechnung der Bewertungsfunktionen auf mehrere GPUs und verarbeiteten Mixture-of-Experts-Schichten in Sequenzabschnitten. Bei realen Daten mit langem Kontext erhielt die am stärksten ausgelastete GPU etwa viermal so viele Tokens wie im Durchschnitt. Dadurch ging den 512k-Token-Läufen der Speicher aus, während dies bei Tests mit zufälligen Tokens nicht der Fall war.
Training mit dem menschlichen Genom zeigte Lernen mit langem Kontext
Die Teams trainierten das Modell nachträglich mit dem menschlichen Genom und verwendeten dabei Sequenzen aus 512k Tokens. Der Verlust auf zurückgehaltenen Daten sank in 80 Schritten um 4,8 Prozent. Die größte Verbesserung zeigte sich bei Tokens, denen Hunderttausende Tokens Kontext vorausgingen.
Für das Training wurden die Chromosomen 1 und 2 des menschlichen Referenzgenoms hg38 verwendet. Die Evaluierung erfolgte mit Chromosom 22, das das Modell zuvor nicht gesehen hatte. Laut Anyscale deutet dieses positionsbasierte Ergebnis darauf hin, dass das Modell gelernt hat, langen Kontext zu nutzen, statt sich ausschließlich auf lokale Muster zu stützen.
Alle Experimente liefen über Ray auf der Anyscale-Plattform und einem 64-GPU-B200-Cluster in der Cloud von Lila. Die Teams erklären, dass das offene Rezept in SkyRL verfügbar ist und Forschenden damit eine Möglichkeit zur Reproduktion und Weiterentwicklung des Trainings mit langem Kontext bietet.