Zhejiang Labs Modell 021 soll Daten aus Chemie, Genomik und Astronomie vereinen
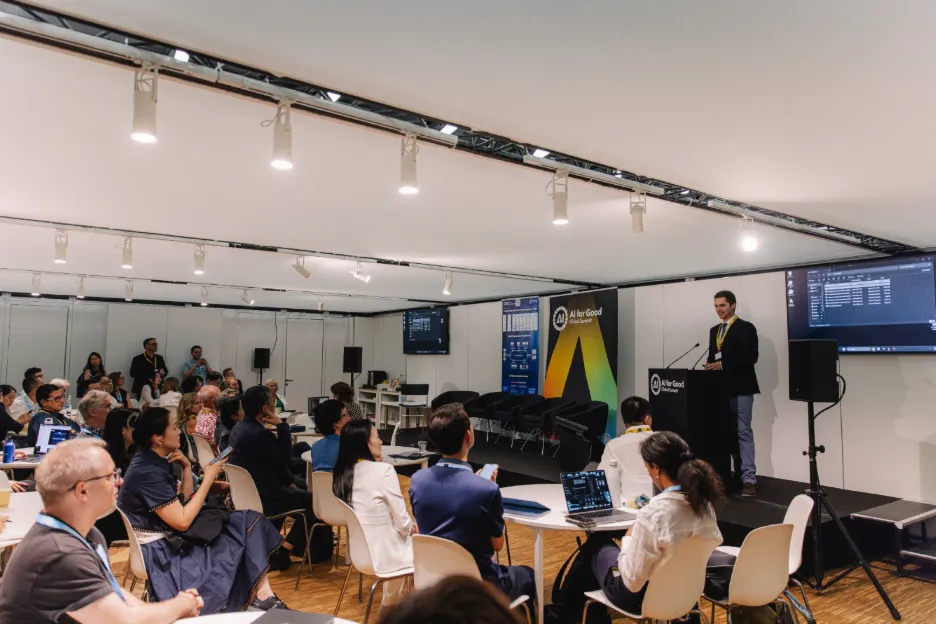
Zhejiang Lab hat beim AI for Good Global Summit 2026 sein 021 Scientific Foundation Model vorgestellt, einen einheitlichen Rahmen für wissenschaftliche Daten, die sonst meist getrennt analysiert werden. Das Modell deckt Text, Code, Mathematik, Chemie, Astronomie, Geowissenschaften, Biowissenschaften und Materialwissenschaften ab. Das Labor veröffentlichte Basismodelle mit 32 Milliarden und 236 Milliarden Parametern.
- Zhejiang Lab stellte das 021 Scientific Foundation Model beim AI for Good Global Summit 2026 vor, das Chemie, Biowissenschaften, Astronomie, Mathematik und Materialwissenschaften abdeckt.
- Veröffentlicht wurden Basismodelle mit 32 Milliarden und 236 Milliarden Parametern, die einen einheitlichen Tokenizer und eine Mixture-of-Experts-Architektur nutzen.
- Laut den Vortragenden erreichte die Kombination aus Bild- und Spektraldaten bei der Suche nach Gravitationslinsen 83 Prozent Präzision, gegenüber 2 bis 5 Prozent bei der üblichen Baseline.
- Ein Chemiemodell grenzte mögliche Kältemittel auf eine Auswahl von 60 ein, und eine Genomik-Plattform lieferte aus den Daten eines Tumorpatienten 34 therapeutische Zielstrukturen mit hoher Konfidenz.
- Die Teilnehmenden betonten Datenzugang, Standards und internationale Zusammenarbeit als Voraussetzungen für breiteren Fortschritt.
Eine Repräsentation für viele Datenarten
Die verschiedenen Wissenschaften halten Beobachtungen in unterschiedlichen Formen fest: Die Chemie nutzt Molekülformeln, die Genomik Sequenzen, die Astronomie Bilder und Spektren, die Geowissenschaften Karten. Laut dem Veranstaltungsbericht von ITU AI for Good lassen sich Modelle, die auf einer dieser Formen trainiert wurden, nur selten auf eine andere übertragen. Der gemeinsam mit Zhejiang Lab organisierte Workshop, moderiert von Anna Stepashkina, fragte, ob diese wissenschaftlichen „Sprachen“ ein gemeinsames KI-Framework nutzen können.
Guirong Xue, Chief Engineer for Science Models bei Zhejiang Lab, beschrieb zwei zentrale Designentscheidungen. Erstens wandelt ein einheitlicher Tokenizer jeden Datentyp vor dem Training in eine gemeinsame Repräsentation um. Zweitens kommt eine Mixture-of-Experts-Architektur zum Einsatz, bei der für bestimmte Aufgaben bestimmte Experten aktiviert werden, während Wissen dennoch domänenübergreifend geteilt werden kann. Das Team veröffentlichte Basismodelle mit 32 Milliarden und 236 Milliarden Parametern. Bei einem Genomik-Benchmark übertraf das einheitliche Modell nach Xues Angaben sowohl spezialisierte Genommodelle als auch größere allgemeine Sprachmodelle.
Suchräume in Chemie und Genomik eingrenzen
Mehrere Vorträge drehten sich darum, Forschenden bei Möglichkeiten zu helfen, die zu zahlreich sind, um sie von Hand zu prüfen. Sebastian Viktor Pios von Zhejiang Lab stellte ein Chemiemodell auf derselben Grundlage vor. Laut Pios schnitt es beim Molekülverständnis vergleichbar zu zwei führenden kommerziellen Systemen ab und übertraf beide bei der Vorhersage von Eigenschaften, obwohl es kleiner ist. Er schilderte eine Zusammenarbeit mit einem chinesischen Chemieunternehmen, bei der das Modell mögliche Kältemittel auf eine Auswahl von 60 Kandidaten für weitere rechnerische und experimentelle Arbeiten eingrenzte.
Shiping Liu, Chief Scientist bei BGI Research, stellte GenesLM vor, ein Foundation Model für das menschliche Genom, das auf mehr als 60 vollständigen menschlichen Genomen trainiert wurde, sowie TransGene, ein gemeinsames Text-und-Sequenz-Modell, das mit dem Team von Zhejiang Lab entwickelt wurde. In einem Fall mit einem Tumorpatienten lieferten 1,5 Terabyte an Multi-Omics-Daten 34 therapeutische Zielstrukturen mit hoher Konfidenz. Eine davon verfolgt eine chinesische Gruppe weiter in Richtung Therapien auf Basis von Messenger-RNA und dendritischen Zellen. Die Modelle wurden als Werkzeuge präsentiert, um die Optionen einzugrenzen, die weitere rechnerische, labortechnische oder klinische Arbeit erfordern.
Daten in Astronomie, Mathematik und Materialforschung kombinieren
Emma Tolley, Assistant Professor an der EPFL, stellte das Foundation Model One Astronomy vor, das Bild- und Spektraldaten kombiniert, um nach Gravitationslinsen zu suchen. Auf einem kuratierten Evaluationsdatensatz erreichte der kombinierte Ansatz nach ihren Angaben eine Präzision von 83 Prozent, gegenüber etwa 32 Prozent allein mit Bildern, 43 Prozent allein mit Spektren und 2 bis 5 Prozent bei der üblichen Baseline mit Convolutional Networks.
Jifeng Liu von den National Astronomical Observatories der Chinesischen Akademie der Wissenschaften stellte One Universe vor, eine Initiative, die astronomische Daten, Modelle, Einrichtungen und agentenbasierte Werkzeuge verbindet, um den Zugang zur Forschung zu erweitern. Er berichtete von einem Zahnarzt, der in seiner Freizeit öffentliche astronomische Daten untersuchte und zur Entdeckung dessen beitrug, was das Team als frühe Stadien der Entstehung eines Erde-Mond-artigen Systems um einen entfernten jungen Stern beschrieb.
Zum Thema Verifikation präsentierte Lei Zhang von der National University of Singapore Arbeiten zum formalen mathematischen Schlussfolgern auf Basis des 021-Basismodells. Laut Zhang leitete ein Multi-Agenten-Beweissystem innerhalb eines Tages eine Formel her, für die ein Doktorand zuvor etwa ein Jahr gebraucht hatte. Stepashkina stellte One Porous vor, einen Agenten für den Entwurf poröser Materialien. Eine von ihm erzeugte Struktur wurde 3D-gedruckt und experimentell getestet. Sie berichtete, sie sei in einer Satellitenkomponente eingesetzt worden, habe deren Masse um rund 10 Prozent verringert und den Produktionszyklus von drei Monaten auf zwei Wochen verkürzt.
Offenes Ökosystem, Datenzugang und Zusammenarbeit
In ihren Eröffnungsworten bezeichnete Tong Weiling, Director General des Zhejiang Provincial Department of Science and Technology, die Community Model Scope von Zhejiang Lab als größte Open-Source-Modell-Community Chinas und zweitgrößte der Welt. Sie schlug vier Felder der internationalen Zusammenarbeit vor: gemeinsame Forschung zu geteilten wissenschaftlichen Fragen, grenzüberschreitenden Datenaustausch und gemeinsames Labeling, den Austausch von Forschenden und Studierenden sowie eine gemeinsame Governance von Open-Source-Foundation-Models für die Wissenschaft.
Eine Podiumsdiskussion unter der Moderation von Richard Chuchla, Co-Chair des GeoGPT Governance Committee, widmete sich dem Datenzugang. Susanne Pedersen von der IUCN sagte, die Organisation verfüge über 76 Jahre an Biodiversitätsdaten und arbeite daran, ihre Datensätze KI-tauglich zu machen. Tomasz Kacprzak von der Fachhochschule Nordwestschweiz erklärte, KI habe aus denselben kosmologischen Daten etwa doppelt so viele Informationen gewonnen wie frühere Methoden. Amal Kasry äußerte Bedenken über die Konzentration von KI-Trainingsdaten und Infrastruktur in wenigen Ländern und Unternehmen und beschrieb UNESCO-Initiativen, die Forschenden im Globalen Süden Fernzugang zu Forschungseinrichtungen und Hochleistungsrechnern ermöglichen.
Was das für die wissenschaftliche Forschung bedeutet
Der Workshop verstand 021 weniger als ein Modell für viele Aufgaben, sondern als gemeinsame Infrastruktur, über die wissenschaftliche Daten, Wissen und Methoden verbunden werden können. Dem Bericht zufolge hängt der Fortschritt von mehr ab als von Modellen: verlässlichen Daten, Zugang zu Rechenressourcen, gemeinsamen Standards, internationaler Zusammenarbeit und dem Urteilsvermögen von Wissenschaftlerinnen und Wissenschaftlern, die die gestellten Fragen verstehen. Diskutiert wurden außerdem offener Zugang, Reproduzierbarkeit, geistiges Eigentum und die Notwendigkeit, dass Fachleute der jeweiligen Disziplinen eng mit KI-Entwicklern zusammenarbeiten.
ITU AI for Good: One model across many sciences: Zhejiang Lab’s 021 Scientific Foundation Model