Liquid AI veröffentlicht offene d1-Entscheidungsmodelle für Text, Bild und Audio
Liquid AI hat mit d1-3B und d1-omni-600M zwei Open-Weight-Modelle aus der d1-Familie von Entscheidungsmodellen veröffentlicht. Laut Unternehmen erreicht d1-3B im Decision Index v0.2.1 (öffentlicher Split) 48,57 Punkte und liegt damit vor allen Modellen unter 10B. Beide Modelle sind auf Hugging Face verfügbar.
- Liquid AI hat die Open-Weight-Entscheidungsmodelle d1-3B und d1-omni-600M veröffentlicht, die auf Hugging Face verfügbar sind.
- Die d1-Modelle liefern ihre Antwort in einem einzigen Vorwärtsdurchlauf, statt Token zu generieren.
- Laut Liquid AI erreicht d1-3B im Decision Index v0.2.1 48,57 Punkte und liegt damit gleichauf mit dem 12-mal größeren Decider 35B-A3B.
- d1-3B beantwortet eine Frage in 8 ms auf einer RTX 4090 und in 50 ms auf einem Jetson Orin Nano.
- d1-omni-600M ist ein experimenteller Checkpoint für Text mit Bild oder Audio und erreicht 15,95 Punkte.
Entscheidungsmodelle, die in einem Durchlauf antworten
Anders als die generativen Liquid Foundation Models (LFMs) von Liquid AI erzeugen die d1-Modelle keine Token. Sie liefern ihre Antwort in einem einzigen Vorwärtsdurchlauf. Da keine Ausgabe-Token anfallen, misst das Unternehmen die Latenz von der Eingabe bis zur Ausgabe.
Laut Liquid AI liegt der Wert von d1-3B im Decision Index v0.2.1 mit 48,57 auf dem Niveau von Decider 35B-A3B, einem Entscheidungsmodell, das 12-mal so groß ist. d1-omni-600M, das das Unternehmen als seinen ersten experimentellen Checkpoint beschreibt, erreicht im selben Index 15,95 Punkte. Es verarbeitet Text und Bild sowie Text und Audio.
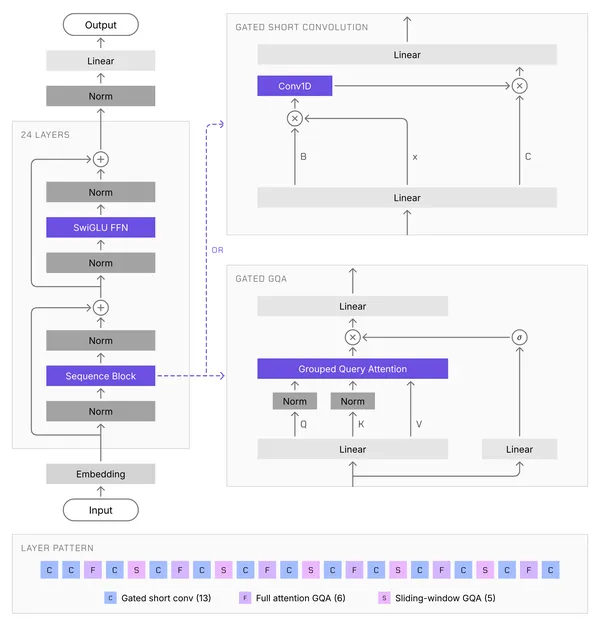
Die beiden Modelle basieren auf unterschiedlichen Architekturen. d1-3B wurde auf Grundlage von LFM2.5-VL-3B trainiert, einem Decoder-only-Vision-Language-Modell, das Text und Bilder verarbeitet. d1-omni-600M basiert auf LFM2.5-Encoder-350M, einem bidirektionalen Encoder, ergänzt um Vision- und Audio-Encoder.
So wurden die Modelle trainiert
Für d1-3B mittelte Liquid AI die Gewichte von LFM2.5-2.6B und des Text-Backbones von LFM2.5-VL-3B, um ein besseres Basismodell zu erhalten. Anschließend wurden Checkpoints mit unterschiedlichen Zufallswerten (Seeds) und Datenmischungen feinjustiert und erneut zusammengeführt. Nach Angaben des Unternehmens brachten das Training mit langen Eingaben, das Mischen der Antwortoptionen und das Beseitigen von Abkürzungen in den Daten mehr als anspruchsvollere Techniken.
Bei d1-omni-600M trimmte das Team zunächst den Encoder auf Entscheidungsaufgaben und fügte dann schrittweise Audio und Bild hinzu. Für Audio kommt ein FastConformer-Encoder mit Adapter zum Einsatz. Für Bilder wird der Encoder von LFM2.5-VL-450M verwendet, dazu ein Adapter und LoRA-Updates, die nur aktiv waren, wenn die Eingabe Bilder enthielt.
Benchmarks und Geschwindigkeit
Auf sieben öffentlichen Text-Benchmarks, die Leseverständnis, Toxizitätserkennung, Intent-Klassifikation, medizinische Fragen und Antworten sowie sprachübergreifendes Verständnis abdecken, erreicht d1-3B einen Mittelwert von 82,9. Das ist der höchste Wert in der Tabelle des Unternehmens, vor Decider 4B mit 81,1. d1-omni-600M kommt auf 78,4 und liegt damit bei einem Viertel der Parameter vor Decider 2B mit 77,1. Zudem erzielt es die höchsten Werte der Tabelle bei Civil Comments (95,8) und PAWS-X (79,5).
Ergebnisse für den privaten Vision-Split des Decision Index v0.3 nennt Liquid AI in dieser Veröffentlichung nicht. Das Unternehmen gibt an, es habe geprüft, dass d1-3B die Vision-Fähigkeiten seines Backbones behält und d1-omni-600M alle drei Modalitäten beherrscht. Eigene Audio-Benchmarks für Entscheidungen bezeichnet es als ungelöstes Problem.
Latenzwerte nennt das Unternehmen für d1-3B, gemessen bei jeweils einer Anfrage zur Zeit. Eine einzelne Frage dauert:
- 8 ms auf einer NVIDIA RTX 4090
- 9 ms auf einer AMD MI325X
- 16 ms auf einem Jetson AGX Thor
- 26 ms auf einem Jetson AGX Orin 64 GB
- 30 ms auf einem Apple M5 Pro
- 50 ms auf einem Jetson Orin Nano
Drei Fragen zu einem Zustand benötigen laut Unternehmen etwa das 1,3-Fache der Zeit einer einzelnen Frage. Bei d1-omni-600M handelt es sich um eine frühe Forschungsversion, daher gibt es dafür keine Inferenzwerte.
Verfügbarkeit und Bedeutung
Beide Modelle sind Open-Weight, und laut Liquid AI können sie ohne Einschränkungen heruntergeladen, feinjustiert und eingesetzt werden. Das Unternehmen verweist auf llama.cpp-Unterstützung vom ersten Tag an auf Hardware von Apple, AMD, Qualcomm und NVIDIA mit NVFP4. Außerdem entwickelte es zehn Demos, in denen d1-3B in einer Schleife über Live-Kamerabilder läuft, von gestengesteuerten Spielen bis zu Live-Inhaltsmoderation. Zudem zeigte es, wie das Modell in Isaac Sim eine Umgebung navigiert, bereitgestellt auf einem Jetson in einem Hardware-in-the-Loop-Aufbau.
Für Entwickler bietet die Veröffentlichung zwei Größen: d1-3B für Entscheidungsqualität und d1-omni-600M dort, wo es auf den Platzbedarf ankommt. Liquid AI positioniert die Modelle für schnelle, strukturierte Entscheidungen, auch aus multimodalen Eingaben, auf Hardware vom Rechenzentrum bis zu kleinen Edge-Geräten.
Liquid AI: Open d1: Edge decision models for text, vision, and audio | Blog