Liquid AI stellt LiquidCodec für schnelleres Audio in hoher Qualität vor
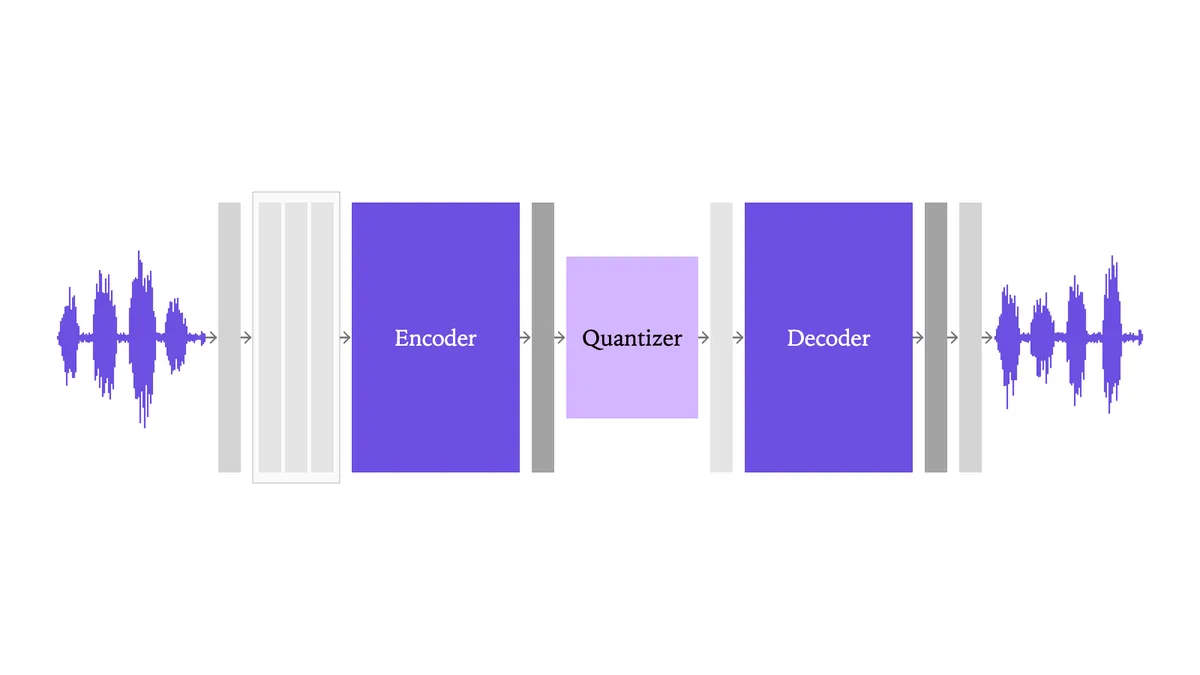
Liquid AI hat LiquidCodec vorgestellt, einen unternehmenseigenen Streaming-Audiocodec für die Modelle LFM3-Audio-2B und LFM3-Omni-2B. Das System mit rund 74 Millionen Parametern soll Audiotokens leichter vorhersagbar machen und zugleich die Rückumwandlung in Sprache beschleunigen.
- LiquidCodec wurde für die Modelle LFM3-Audio-2B und LFM3-Omni-2B von Liquid AI entwickelt.
- Der Codec verfügt über rund 74 Millionen Parameter und zielt auf eine schnelle Audioverarbeitung auf Geräten ab.
- Er nutzt gruppierte endliche Skalarquantisierung für eine stärker parallelisierte Vorhersage von Audiotokens.
- Das Training umfasste in der ersten Phase 264.000 Stunden aus 107 Sprachen.
- In einer zweiten Phase kamen 55.000 Stunden sauberer Sprache über das gesamte Frequenzband zum Einsatz.
Ein Codec für Audio auf Geräten
LiquidCodec wandelt Sprache in diskrete Tokens um, die Sprachmodelle vorhersagen können, und konvertiert diese Tokens anschließend wieder in Audio. Laut Liquid AI erreicht der Codec bei der Rekonstruktion von Audioqualität und Sprachkompression das Niveau ähnlich großer Modelle, übertrifft sie jedoch bei der Sprachgenerierung und der Geschwindigkeit der Token-zu-Wellenform-Dekodierung.
Der Codec kombiniert herkömmliche Spektralverarbeitung mit einem symmetrischen Encoder und Decoder. Liquid AI hat ihn auf Basis der LFM3-Architektur entwickelt und für den Einsatz auf Geräten optimiert, mit Fokus auf geringe Latenz und Audio-Streaming in Echtzeit. Das System verarbeitet Wellenformen mit 24 kHz und hält eine Bildrate von 12,5 Hz ein, wobei alle 80 ms ein Frame erzeugt wird.
Warum Liquid AI den bisherigen Ansatz ersetzt hat
Liquid AI setzte zuvor den Mimi-Codec in LFM2-Audio-1.5B ein. Mimi bot eine Bitrate von 1,1 kbit/s und eine Parameterzahl von etwa 96 Millionen. Für LFM2.5-Audio-1.5B ersetzte Liquid AI lediglich den Detokenizer und erreichte eine 8× schnellere Detokenisierung, während der Tokenizer von Mimi beibehalten wurde.
Für die neuesten Audiomodelle wollte das Unternehmen mehr Kontrolle über die Qualität der Audiotokens und darüber, wie leicht Sprachmodelle diese Tokens vorhersagen können. Mimi nutzt die Quantisierung mittels Residualvektorquantisierung, kurz RVQ, bei der Codebücher nacheinander verwendet werden. LiquidCodec setzt stattdessen auf gruppierte endliche Skalarquantisierung, kurz GFSQ. Laut Liquid AI reduziert dieser Ansatz die sequentiellen Abhängigkeiten zwischen den Codebüchern und ermöglicht eine parallele Vorhersage.
LiquidCodec verwendet außerdem einen vollständig kausalen Encoder sowie einen symmetrischen Tokenizer und Detokenizer. Laut Liquid AI vermeidet das Design kostenintensive Operationen, die in ähnlichen Codecs zum Einsatz kommen, darunter ein schrittweises Upsampling mit erlernten transponierten Faltungen während der Dekodierung.
Multilinguales Training und Sprachqualität
Liquid AI trainierte LiquidCodec in zwei Phasen. In der ersten kamen 264.000 Stunden Daten aus 107 Sprachen zum Einsatz. Die Daten kombinierten Websprache, Hörbücher, von Menschen beigesteuerte Aufnahmen sowie kleinere Sammlungen aus Parlaments- und Gesprächsaufzeichnungen. Das Unternehmen verwendete Verluste auf Wellenform- und Spektralebene und verzichtete in dieser Phase auf adversariale Verluste, um robuste Audiodarstellungen zu entwickeln.
Laut Liquid AI konnte dieses anfängliche Training „metallische“ Artefakte hinterlassen. In der zweiten Phase wurde der Codec mit 55.000 Stunden sauberer Sprache über das gesamte Frequenzband aus mehreren Sprachen feinjustiert. Die Quellen waren nativ mit 24 kHz oder höher abgetastet, und das Unternehmen setzte adversariale Kritiker ein, die Wellenformmuster, spektrale Details und Sprachmerkmale abdeckten. Zusätzlich kam ein quantisierungsbewusstes Training ausschließlich des Decoders zum Einsatz, um die Robustheit bei der Inferenz auf Edge-Geräten zu verbessern.
Laut Liquid AI ist die Rekonstruktionsqualität nur ein Maß für einen Codec. Seine Tokens müssen außerdem während des Text-zu-Sprache-Trainings für ein Sprachmodell leicht erlernbar sein. Für den Vergleich der Codecs hielt das Unternehmen Trainingsdaten, Architektur und Rechenbudget konstant. Dabei verwendete es 101.000 Stunden aus sechs Sprachen und ein auf Basis des vortrainierten LFM3-1.7B initialisiertes Backbone.