Meta gibt Einblick in Prometheus, seinen KI-Supercluster im Gigawatt-Maßstab in Ohio
Meta hat die erste Phase von Prometheus abgeschlossen, einem KI-Supercluster im Gigawatt-Maßstab in New Albany, Ohio, und nach eigenen Angaben darauf die Muse-Familie von Foundation-Modellen trainiert. Laut Meta wird der Cluster auf etwa 1 Million GPUs ausgebaut.
- Meta hat die erste Phase von Prometheus abgeschlossen, eines Superclusters im Gigawatt-Maßstab in New Albany, Ohio, auf dem die Muse-Modelle trainiert wurden.
- Im Vollausbau plant Meta rund 1 Million GPUs, derzeit sind es Hunderttausende.
- Bei Muse Wonder erreichten die Läufe laut Meta mehr als 85 % Goodput im Pre-Training und mehr als 90 % im RL.
- Die mittlere Zeit zwischen Unterbrechungen stieg nach späteren Korrekturen von rund 47k auf mehr als 54K GPU-Stunden.
- Im Einsatz sind zwei NVIDIA-Plattformen, GB200 und GB300, eine dritte auf Basis von Vera Rubin NVL72 folgt bald.
Vom Rechenzentrum für Web-Traffic zur Trainingszentrale für Frontier-Modelle
Meta bezeichnet Prometheus als sein bislang ehrgeizigstes Infrastrukturprojekt für künstliche Intelligenz. Dem Unternehmen zufolge war New Albany vor zwei Jahren noch ein herkömmliches Rechenzentrum, in dem Web-Traffic lief. Fortschritte bei Hardware, Netzwerktechnik und Gebäudedesign hätten es Meta ermöglicht, den Standort zu einer Anlage für das Training von Frontier-Modellen umzubauen.
Der Supercluster entsteht in Phasen. Die erste Phase ist abgeschlossen und wurde genutzt, um die Muse-Modelle zu trainieren, darunter Muse Wonder. Meta nennt sie seine neuen Frontier-Modelle mit Spitzenleistung bei persönlichen und beruflichen agentischen Aufgaben. Der weitere Ausbau zielt laut Meta auf die nächsten Frontier-Modelle der Meta Superintelligence Labs.
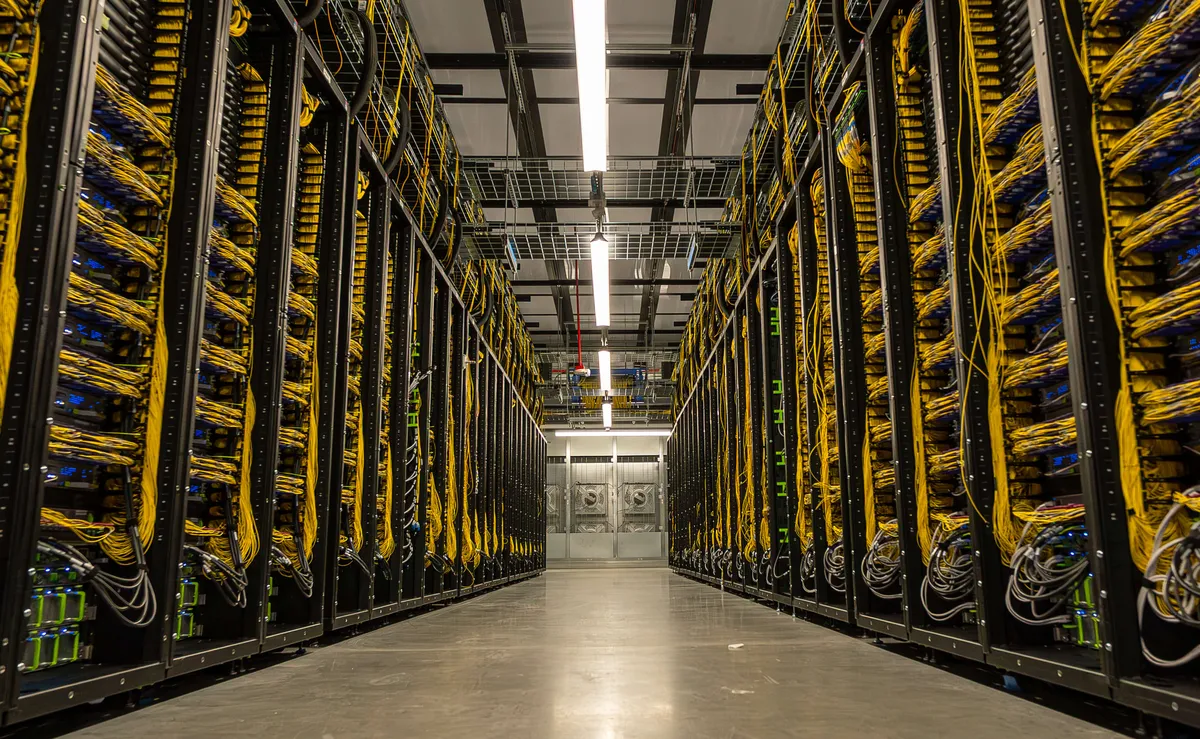
Heute besteht Prometheus aus Hunderttausenden GPUs in mehreren miteinander verbundenen Gebäuden. Dazu zählen klassische und auf KI optimierte Rechenzentrumsgebäude sowie schnell errichtete Strukturen, die über viele Kilometer Glasfaser verbunden sind und wie eine einzige Maschine arbeiten. Im Vollausbau soll der Cluster nach Angaben von Meta rund 1 Million verteilter GPUs umfassen, die im Gleichtakt arbeiten. Als Technik für den effizienten Betrieb des Standorts nennt das Unternehmen zudem eine Flüssigkeitskühlung im geschlossenen Kreislauf.
Zuverlässigkeitswerte für Muse Wonder
Meta betont, dass der Ausfall eines einzelnen Hosts einen ganzen Trainingsjob verlangsamen oder stoppen kann, was den Goodput senkt. Durch Arbeit an Stabilität und Zuverlässigkeit habe man bei Muse Wonder mehr als 85 % Goodput bei Pre-Training-Läufen und mehr als 90 % Goodput bei Reinforcement-Learning-Läufen erreicht.
Bei diesen Läufen lag die mittlere Zeit zwischen Unterbrechungen, gemessen in realer Laufzeit, bei etwa 47k GPU-Stunden. Spätere Änderungen in der gesamten Flotte, darunter Firmware-Korrekturen, haben diesen Wert laut Meta auf mehr als 54K GPU-Stunden erhöht, die Arbeit daran gehe weiter.
Zwei NVIDIA-Plattformen, eine dritte folgt
Auf Prometheus laufen derzeit zwei GPU-Plattformen von NVIDIA, eine dritte auf Basis von NVIDIAs Vera Rubin NVL72 kommt bald hinzu. Alle nutzen Metas NVL72-Rack-Architektur, bei der 72 GPUs innerhalb desselben Netzwerk-Fabrics als ein einziger Beschleuniger arbeiten.
- Catalina (GB200 NVL72): Meta setzt die Ariel-Variante ein, einen Aufbau aus zwei Racks mit je 36 GPUs, die per NVLink zu einer Domäne mit 72 GPUs verbunden sind. Jede Blackwell-GPU wird mit einer Grace-CPU und zwei ConnectX-7-400G-NICs kombiniert, was 800G an I/O pro GPU ergibt. Meta nennt für das Paar 13,4 TB HBM3e, 720 PFLOPS FP8-Trainingsleistung (Spitzenwert) und rund 120 kW Gesamtleistungsaufnahme.
- Clemente (GB300 NVL72): Laut Meta steigt der HBM-Speicher pro GPU um das 1,5-Fache von 192 GB auf 288 GB, zudem kommen ConnectX-8-SuperNICs zum Einsatz, die nativ 800G pro GPU liefern. Bei einem GPU-zu-CPU-Verhältnis von 2:1 passt die gesamte 72-GPU-Domäne in ein Rack. Meta nennt über 1 ExaFLOP FP4-Spitzenleistung, rund 135 kW Rack-Leistung und eine um 5 bis 10 % höhere Performance gegenüber dem GB200 NVL72.
Meta erklärt, man habe sich für die Ariel-Konfiguration entschieden, weil das GB200 NVL72 im Vergleich zur H100 nahezu jede Dimension vergrößert habe, die Scale-out-Bandbreite pro GPU aber bei 400G geblieben wäre. Das Unternehmen erwartete, dass dieses Ungleichgewicht Leistung kosten würde.
Ein eigenes Netzwerk für GPU-Verkehr
Meta zufolge kam vor einigen Jahren zusätzlich zum üblichen Rechenzentrumsnetz ein zweites, Ethernet-basiertes Netz hinzu, das Back-End-Netzwerk (BE), für die direkte Kommunikation von GPU zu GPU innerhalb und zwischen Gebäuden. Das Design spiegelt wider, wie sich große Pre-Training-Jobs in datenparallele Replikate aufteilen: Latenz- und bandbreitenkritischer Verkehr bleibt innerhalb eines Replikats, toleranterer Verkehr läuft zwischen den Replikaten.
Innerhalb eines Gebäudes verbindet jedes Ethernet-Fabric bis zu 20.736 GPUs. Meta setzte zunächst ein Disaggregated Scheduled Fabric ein und wechselte dann mit der Weiterentwicklung der NIC-Technik zu einem Non-Scheduled Fabric mit 51,2T-Ethernet-Switches wie Minipack3 und Minipack3N. Beide laufen auf Metas Netzwerk-Stack FBOSS. Die Gebäude sind über das Backend Aggregation Network verbunden, ein mehrschichtiges Hub-and-Spoke-Design über Distanzen von 2 km bis über 100 km, gebaut mit Chassis der Arista-7800-Serie.
Was das bedeutet
Der Beitrag zeigt, wie Meta die Modellentwicklung an die Skalierung der Infrastruktur koppelt. Laut Unternehmen erlaubt die Kapazität größere Modelle und längere Kontextfenster, als bisher praktikabel waren. Für die nächsten Frontier-Modelle der Meta Superintelligence Labs sind weitere Ausbauphasen geplant.
Engineering at Meta: Inside Prometheus: Meta’s Journey to a Gigawatt-Scale Supercluster